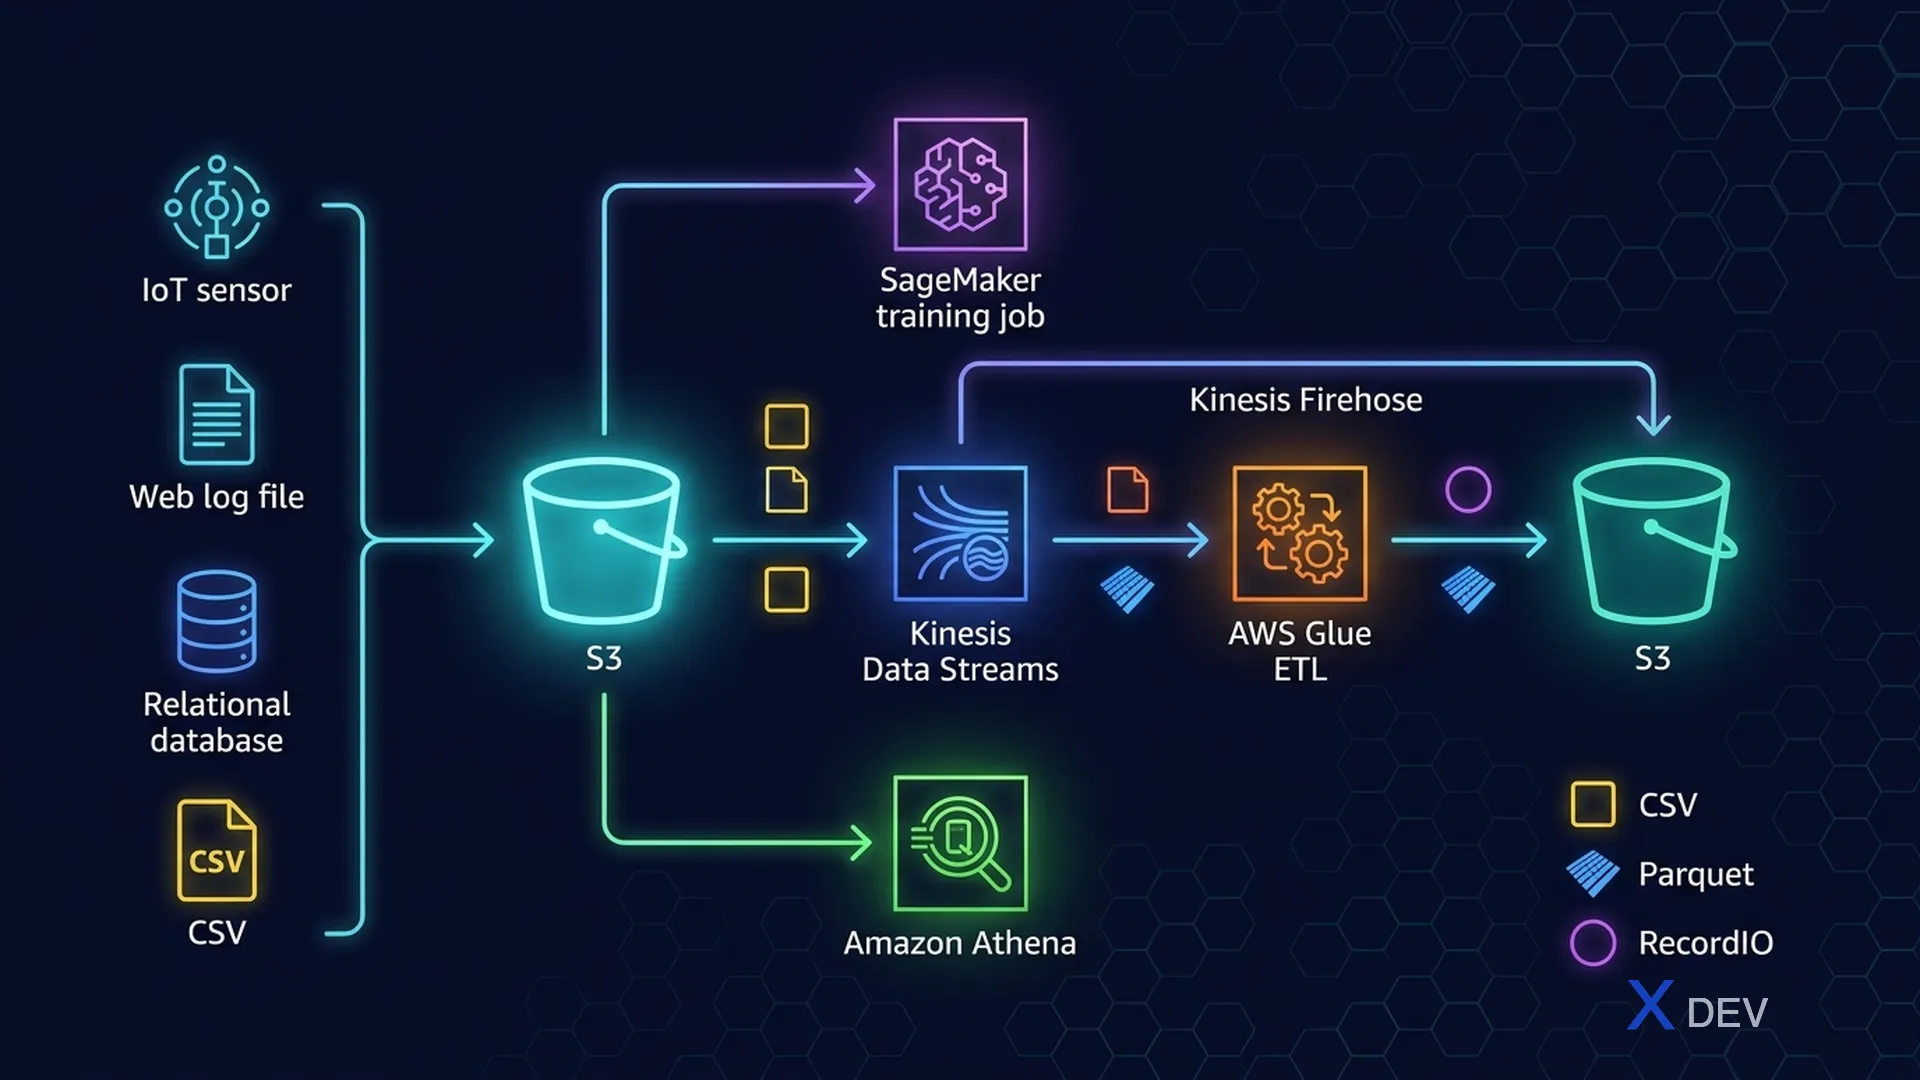
Data Repositories & Ingestion:MLパイプラインにおけるS3、Kinesis、Glue、Lake Formation
1. MLS-C01におけるデータエンジニアリングの概要
データエンジニアリングドメインはMLS-C01試験の20%を占めます。「ML向けデータの取り込み・保存・変換にどのサービスを使うべきか?」という質問が頻出します。
試験のヒント: データエンジニアリングの問題の大半はシナリオが提示され、適切なサービスを選ぶ形式です。主要パターン:バッチ → S3 + Glue、ストリーミング → Kinesis、構造化/SQL → Athena、カタログ → Glue Data Catalog。
2. Amazon S3 — MLデータレイク
Amazon S3はAWS上のMLデータストレージの基盤です。すべてのMLパイプラインはS3から始まりS3で終わります:訓練データ、モデルアーティファクト、予測結果。
2.1. ML向けS3ストレージクラス
| ストレージクラス | ユースケース | コスト |
|---|---|---|
| S3 Standard | アクティブな訓練データ、頻繁なアクセス | 最も高い |
| S3 Intelligent-Tiering | アクセスパターンが混在(自動階層化) | 自動最適化 |
| S3 Standard-IA | バックアップデータセット、低頻度アクセス | Standardより低い |
| S3 Glacier Instant Retrieval | アーカイブデータセット、時折の取得 | 低い |
| S3 Glacier Deep Archive | 長期コンプライアンスアーカイブ | 最も低い |
2.2. ML向けファイルフォーマット
| フォーマット | タイプ | 最適な用途 | 圧縮 |
|---|---|---|---|
| Parquet | カラムナー | 分析、大規模データセット、Feature Store | 優秀 |
| ORC | カラムナー | Hive/EMRワークロード | 優秀 |
| CSV | 行ベース | シンプル、SageMaker訓練入力 | 悪い |
| JSON | 半構造化 | ネストデータ、API | 悪い |
| RecordIO | バイナリ | SageMaker Pipe Mode訓練 | 良い |
試験のヒント: 大規模訓練のパフォーマンス最適化について問われた場合、正解は通常Parquet(カラムナー、圧縮)への変換とSageMakerでのPipe Mode(File Modeの代わり)の使用です。
S3 Data Lake Architecture for ML:

┌─────────────────────────────────────────────────────────┐
│                    Amazon S3 Buckets                     │
├──────────────┬──────────────┬──────────────┬────────────┤
│  Raw Zone    │ Processed    │  Features    │  Models    │
│  (landing)   │  Zone        │  Zone        │  & Output  │
│              │              │              │            │
│  CSV/JSON    │  Parquet/ORC │  Feature     │  Model     │
│  original    │  cleaned     │  Store       │  Artifacts │
│  data        │  transformed │  snapshots   │  Predictions│
└──────────────┴──────────────┴──────────────┴────────────┘
       ↑                ↑                ↑
   Kinesis          AWS Glue         SageMaker
  (streaming)        (ETL)           Processing
3. Amazon Kinesis — ストリーミング取り込み
Kinesisはリアルタイムデータストリーミングのサービスファミリーです。試験で重要なトピックであり、4つのサービスを明確に区別する必要があります。
| サービス | 機能 | 送信先 | MLユースケース |
|---|---|---|---|
| Kinesis Data Streams (KDS) | カスタムリアルタイム処理 | カスタムコンシューマー | リアルタイム特徴量エンジニアリング |
| Kinesis Data Firehose | マネージド配信(コード不要) | S3、Redshift、ES、Splunk | データレイクへのバッチロード |
| Kinesis Data Analytics | ストリーム上のSQL/Flink | S3、Redshift | リアルタイム集計、異常検知 |
| Kinesis Video Streams | 動画取り込み | Rekognition、SageMaker | コンピュータビジョンパイプライン |
試験のヒント: よくある質問:「IoTセンサーが継続的にデータを送信し、カスタムコードなしでS3に保存したい」→ Kinesis Data Firehose(マネージド、コード不要)。「カスタムロジックでリアルタイム処理が必要」→ Kinesis Data Streams。
3.1. KDSシャードとキャパシティ
Kinesis Data Streams Capacity:

┌─────────────────────────────────────────────┐
│  Each Shard:                                │
│  • Ingest:  1 MB/s OR 1,000 records/s       │
│  • Read:    2 MB/s                          │
│  • Retention: 24 hours (default) → 7 days  │
└─────────────────────────────────────────────┘

Stream with N shards:
• Total ingest: N × 1 MB/s
• Total read:   N × 2 MB/s
4. AWS Glue — ML向けETL
AWS GlueはフルマネージドETLサービスです。MLパイプラインでは、訓練前のデータの変換とクリーニングに使用します。
4.1. Glueコンポーネント
| コンポーネント | 機能 |
|---|---|
| Glue Data Catalog | 中央メタデータリポジトリ — スキーマ、テーブル、パーティション |
| Glue Crawlers | S3/RDS/Redshiftからスキーマを自動検出しData Catalogに登録 |
| Glue ETL Jobs | Sparkベースの変換ジョブ(Python/Scala) |
| Glue DataBrew | ノーコードビジュアルデータ準備(250以上の組み込み変換) |
| Glue Studio | ビジュアルETLジョブビルダー(ドラッグ&ドロップ) |
試験のヒント: Glue Data CatalogはAthena、EMR、Redshift Spectrumの共通メタデータストアです。「一元的なスキーマ管理」→ Glue Data Catalog。「ノーコードデータクリーニング」→ Glue DataBrew。
5. AWS Lake Formation
Lake FormationはS3 + Glueの上に構築され、データレイクのセキュリティとガバナンスを管理します。主要機能:カラムレベルおよび行レベルのアクセス制御。
Lake Formation Architecture:

  IAM Users ──→ Lake Formation ──→ S3 Data Lake
  IAM Roles       (Security         (Raw/Processed)
                   & Governance)
                       ↓
                  Column/Row
                  Level Access
                  Control
6. チートシート — データ取り込みサービス
| シナリオ | サービス |
|---|---|
| ストリーミング → S3(コード不要) | Kinesis Data Firehose |
| カスタムロジックのリアルタイム処理 | Kinesis Data Streams |
| ストリーミングデータ上のSQL | Kinesis Data Analytics (Flink) |
| バッチETL(Sparkベース) | AWS Glue ETL Jobs |
| ノーコードビジュアルデータ準備 | Glue DataBrew |
| S3からのスキーマ検出 | Glue Crawlers + Data Catalog |
| S3上のSQLクエリ | Amazon Athena |
| データレイクガバナンス | AWS Lake Formation |
| 大規模Spark/Hadoop | Amazon EMR |
7. 練習問題
Q1: ある企業がIoTセンサーデータをML訓練のためにAmazon S3に取り込みたいと考えています。データは継続的に到着し、カスタム処理は不要です。最もコスト効率の良いサービスはどれですか?
- A) Amazon Kinesis Data StreamsとLambdaコンシューマー
- B) Amazon Kinesis Data Firehose ✓
- C) Amazon EMRとSpark Streaming
- D) スケジュールされたAWS Glue ETLジョブ
解説:Kinesis Data Firehoseはフルマネージドでカスタムコードが不要です。ストリーミングデータをS3、Redshift、Elasticsearchに直接配信します。Data Streamsはカスタムコンシューマーが必要、EMRは大規模な管理が必要、GlueはバッチETL向けです。
Q2: データエンジニアがS3内の生のCSVファイルをデータベースにロードせずにSQLでクエリしたいと考えています。どのサービスを使うべきですか?
- A) Amazon RDS
- B) Amazon DynamoDB
- C) Amazon Athena ✓
- D) Amazon Redshift
解説:Amazon Athenaはサーバーレスで、ロードなしにS3データに対して直接SQLクエリを実行できます。CSV、Parquet、ORC、JSONなどのフォーマットをサポートしています。
Q3: Amazon S3に保存された大規模MLデータセットに対するカラムナー分析クエリで最高のパフォーマンスを提供するファイルフォーマットはどれですか?
- A) CSV
- B) JSON
- C) XML
- D) Apache Parquet ✓
解説:Parquetは優れた圧縮とプレディケートプッシュダウンをサポートするカラムナーフォーマットです。カラムナーフォーマットは必要なカラムのみを読み取るため、分析クエリのI/Oを劇的に削減します。