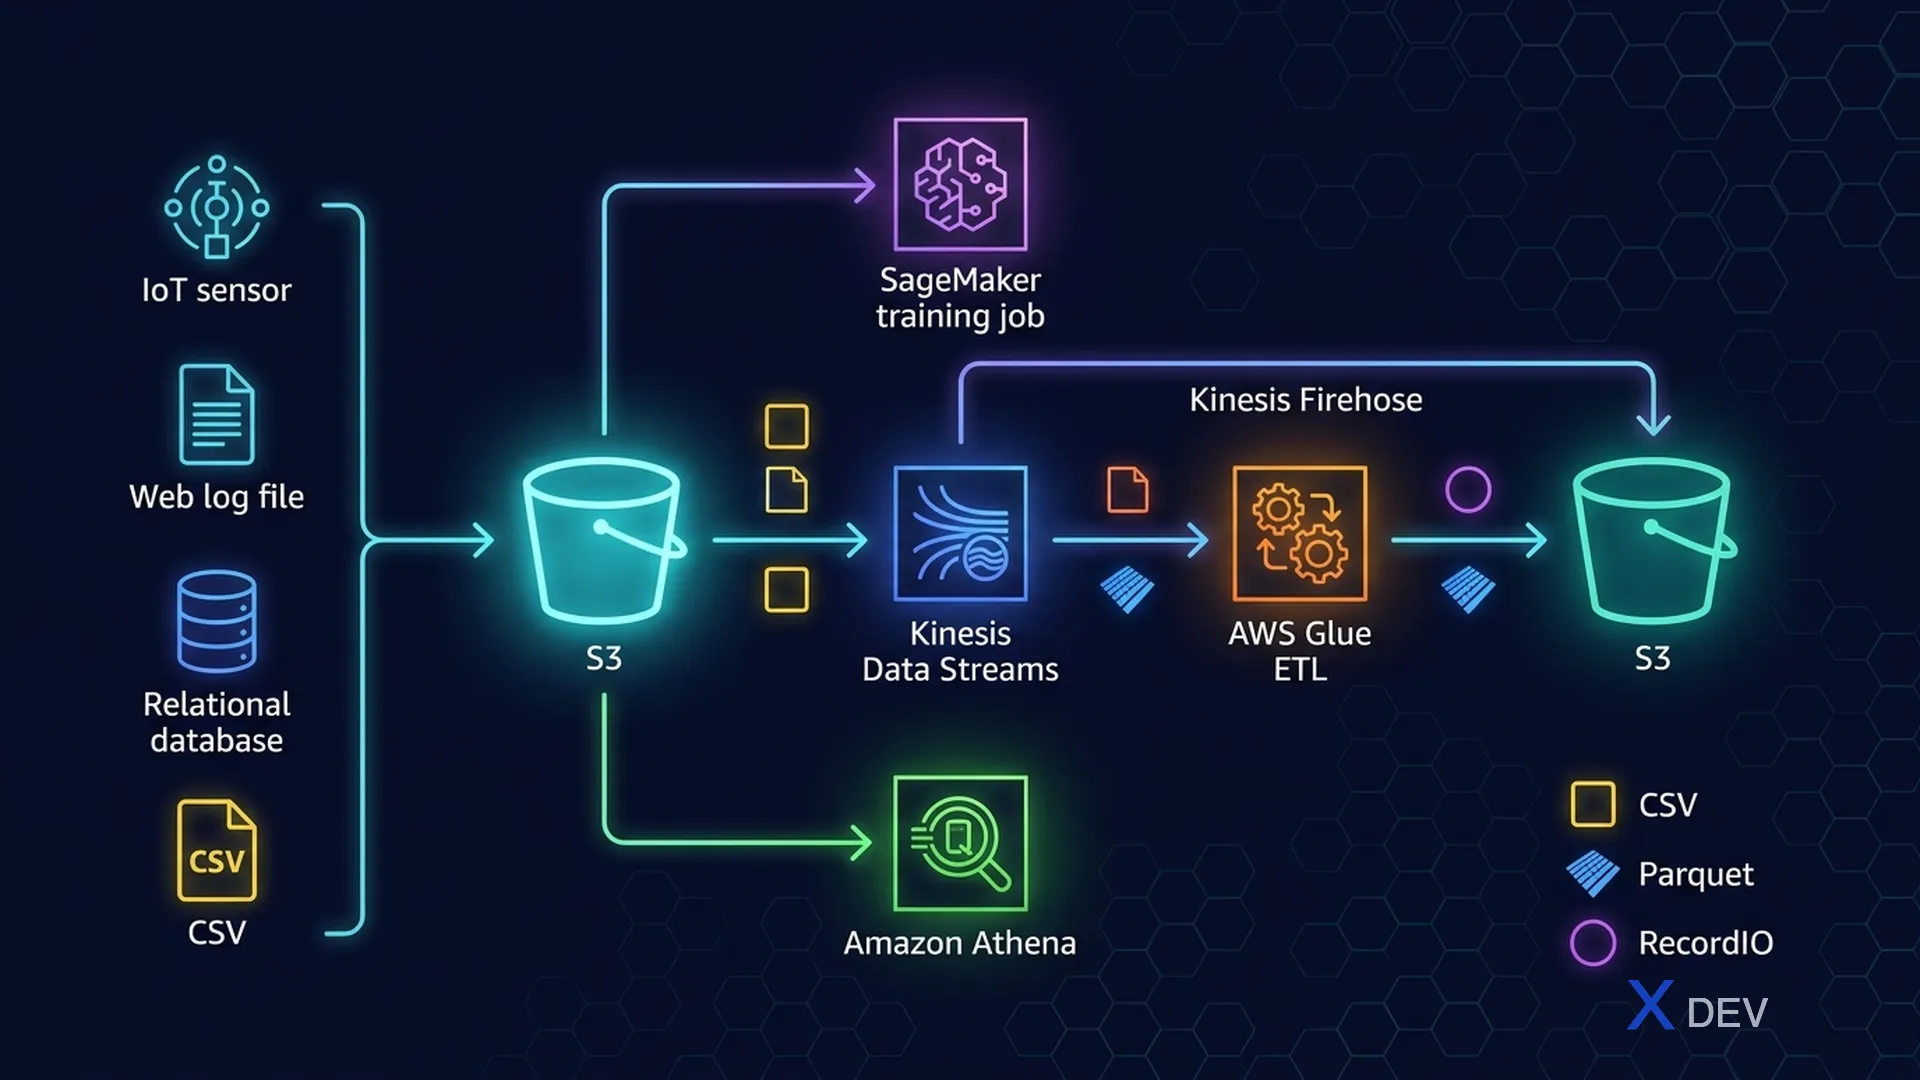
Data Repositories & Ingestion:ML管線中的S3、Kinesis、Glue、Lake Formation
1. MLS-C01數據工程概述
數據工程領域佔MLS-C01考試的20%。最常見的問題是「ML數據的攝取、儲存、轉換應該使用哪個服務?」
考試提示: 數據工程的大部分問題是情境式的,需要選擇適當的服務。主要模式:批次 → S3 + Glue、串流 → Kinesis、結構化/SQL → Athena、目錄 → Glue Data Catalog。
2. Amazon S3 — ML數據湖
Amazon S3是AWS上ML數據儲存的基礎。所有ML管線都從S3開始、以S3結束:訓練數據、模型產出物、預測結果。
2.1. ML適用的S3儲存類別
| 儲存類別 | 使用情境 | 成本 |
|---|---|---|
| S3 Standard | 活躍的訓練數據、頻繁存取 | 最高 |
| S3 Intelligent-Tiering | 混合存取模式(自動分層) | 自動最佳化 |
| S3 Standard-IA | 備份數據集、低頻存取 | 低於Standard |
| S3 Glacier Instant Retrieval | 封存數據集、偶爾取回 | 低 |
| S3 Glacier Deep Archive | 長期合規性封存 | 最低 |
2.2. ML適用的檔案格式
| 格式 | 類型 | 最適用途 | 壓縮 |
|---|---|---|---|
| Parquet | 列式 | 分析、大型數據集、Feature Store | 優秀 |
| ORC | 列式 | Hive/EMR工作負載 | 優秀 |
| CSV | 行式 | 簡單、SageMaker訓練輸入 | 差 |
| JSON | 半結構化 | 巢狀數據、API | 差 |
| RecordIO | 二進位 | SageMaker Pipe Mode訓練 | 良好 |
考試提示: 當問到大規模訓練的效能最佳化時,答案通常是轉換為Parquet(列式、壓縮)並在SageMaker中使用Pipe Mode(而非File Mode)。
S3 Data Lake Architecture for ML:

┌─────────────────────────────────────────────────────────┐
│                    Amazon S3 Buckets                     │
├──────────────┬──────────────┬──────────────┬────────────┤
│  Raw Zone    │ Processed    │  Features    │  Models    │
│  (landing)   │  Zone        │  Zone        │  & Output  │
│              │              │              │            │
│  CSV/JSON    │  Parquet/ORC │  Feature     │  Model     │
│  original    │  cleaned     │  Store       │  Artifacts │
│  data        │  transformed │  snapshots   │  Predictions│
└──────────────┴──────────────┴──────────────┴────────────┘
       ↑                ↑                ↑
   Kinesis          AWS Glue         SageMaker
  (streaming)        (ETL)           Processing
3. Amazon Kinesis — 串流攝取
Kinesis是即時數據串流的服務家族。這是考試的重要主題,需要清楚區分4個服務。
| 服務 | 功能 | 目的地 | ML使用情境 |
|---|---|---|---|
| Kinesis Data Streams (KDS) | 自訂即時處理 | 自訂消費者 | 即時特徵工程 |
| Kinesis Data Firehose | 託管交付(無需程式碼) | S3、Redshift、ES、Splunk | 批次載入至數據湖 |
| Kinesis Data Analytics | 串流上的SQL/Flink | S3、Redshift | 即時彙總、異常檢測 |
| Kinesis Video Streams | 影片攝取 | Rekognition、SageMaker | 電腦視覺管線 |
考試提示: 常見問題:「IoT感測器持續發送數據,想要無需自訂程式碼存入S3」→ Kinesis Data Firehose(託管、無需程式碼)。「需要自訂邏輯的即時處理」→ Kinesis Data Streams。
3.1. KDS分片與容量
Kinesis Data Streams Capacity:

┌─────────────────────────────────────────────┐
│  Each Shard:                                │
│  • Ingest:  1 MB/s OR 1,000 records/s       │
│  • Read:    2 MB/s                          │
│  • Retention: 24 hours (default) → 7 days  │
└─────────────────────────────────────────────┘

Stream with N shards:
• Total ingest: N × 1 MB/s
• Total read:   N × 2 MB/s
4. AWS Glue — ML的ETL
AWS Glue是全託管ETL服務。在ML管線中用於訓練前的數據轉換和清理。
4.1. Glue元件
| 元件 | 功能 |
|---|---|
| Glue Data Catalog | 中央元數據儲存庫 — 綱要、表格、分區 |
| Glue Crawlers | 從S3/RDS/Redshift自動發現綱要並註冊至Data Catalog |
| Glue ETL Jobs | Spark為基礎的轉換工作(Python/Scala) |
| Glue DataBrew | 無程式碼視覺化數據準備(250+內建轉換) |
| Glue Studio | 視覺化ETL工作建構器(拖放式) |
考試提示: Glue Data Catalog是Athena、EMR、Redshift Spectrum的共用元數據儲存。「集中式綱要管理」→ Glue Data Catalog。「無程式碼數據清理」→ Glue DataBrew。
5. AWS Lake Formation
Lake Formation建構在S3 + Glue之上,管理數據湖的安全性和治理。主要功能:列級和行級存取控制。
Lake Formation Architecture:

  IAM Users ──→ Lake Formation ──→ S3 Data Lake
  IAM Roles       (Security         (Raw/Processed)
                   & Governance)
                       ↓
                  Column/Row
                  Level Access
                  Control
6. 速查表 — 數據攝取服務
| 情境 | 服務 |
|---|---|
| 串流 → S3(無需程式碼) | Kinesis Data Firehose |
| 自訂邏輯的即時處理 | Kinesis Data Streams |
| 串流數據上的SQL | Kinesis Data Analytics (Flink) |
| 批次ETL(Spark為基礎) | AWS Glue ETL Jobs |
| 無程式碼視覺化數據準備 | Glue DataBrew |
| S3的綱要發現 | Glue Crawlers + Data Catalog |
| S3上的SQL查詢 | Amazon Athena |
| 數據湖治理 | AWS Lake Formation |
| 大規模Spark/Hadoop | Amazon EMR |
7. 練習題
Q1: 一家公司想要將IoT感測器數據攝取至Amazon S3用於ML訓練。數據持續到達且不需要自訂處理。最具成本效益的服務是哪個?
- A) Amazon Kinesis Data Streams搭配Lambda消費者
- B) Amazon Kinesis Data Firehose ✓
- C) Amazon EMR搭配Spark Streaming
- D) 排程AWS Glue ETL工作
解析:Kinesis Data Firehose是全託管且無需自訂程式碼。它直接將串流數據交付至S3、Redshift、Elasticsearch。Data Streams需要自訂消費者,EMR需要大規模管理,Glue是批次ETL。
Q2: 數據工程師想要對S3中的原始CSV檔案執行SQL查詢,而無需載入到資料庫。應該使用哪個服務?
- A) Amazon RDS
- B) Amazon DynamoDB
- C) Amazon Athena ✓
- D) Amazon Redshift
解析:Amazon Athena是無伺服器的,可以直接對S3數據執行SQL查詢而無需載入。支援CSV、Parquet、ORC、JSON等格式。
Q3: 對儲存在Amazon S3的大型ML數據集,哪種檔案格式能為列式分析查詢提供最佳效能?
- A) CSV
- B) JSON
- C) XML
- D) Apache Parquet ✓
解析:Parquet是列式格式,支援優秀的壓縮和謂詞下推。列式格式僅讀取所需的列,大幅減少分析查詢的I/O。