ML問題パターン:不正検知、レコメンデーション、NLP、時系列、AWSでのコンピュータビジョン
1. 問題パターンの迅速な認識
MLS-C01の大半の問題はシナリオベースです:ビジネス問題の説明を読み、最も適切なAWSサービスまたはアルゴリズムを選択します。このレッスンでは迅速な認識のためのフレームワークを提供します。
ML Problem Recognition Framework:

READ SCENARIO
    ↓
Is output a CATEGORY?          → Classification
Is output a NUMBER?            → Regression
Is output a CLUSTER/GROUP?     → Clustering (no labels)
Is output a RANK/SCORE?        → Recommendation / Ranking
Is output a DETECTION (anomaly)? → Anomaly Detection
Is output a SEQUENCE?          → Time Series / Seq2Seq
2. 不正検知
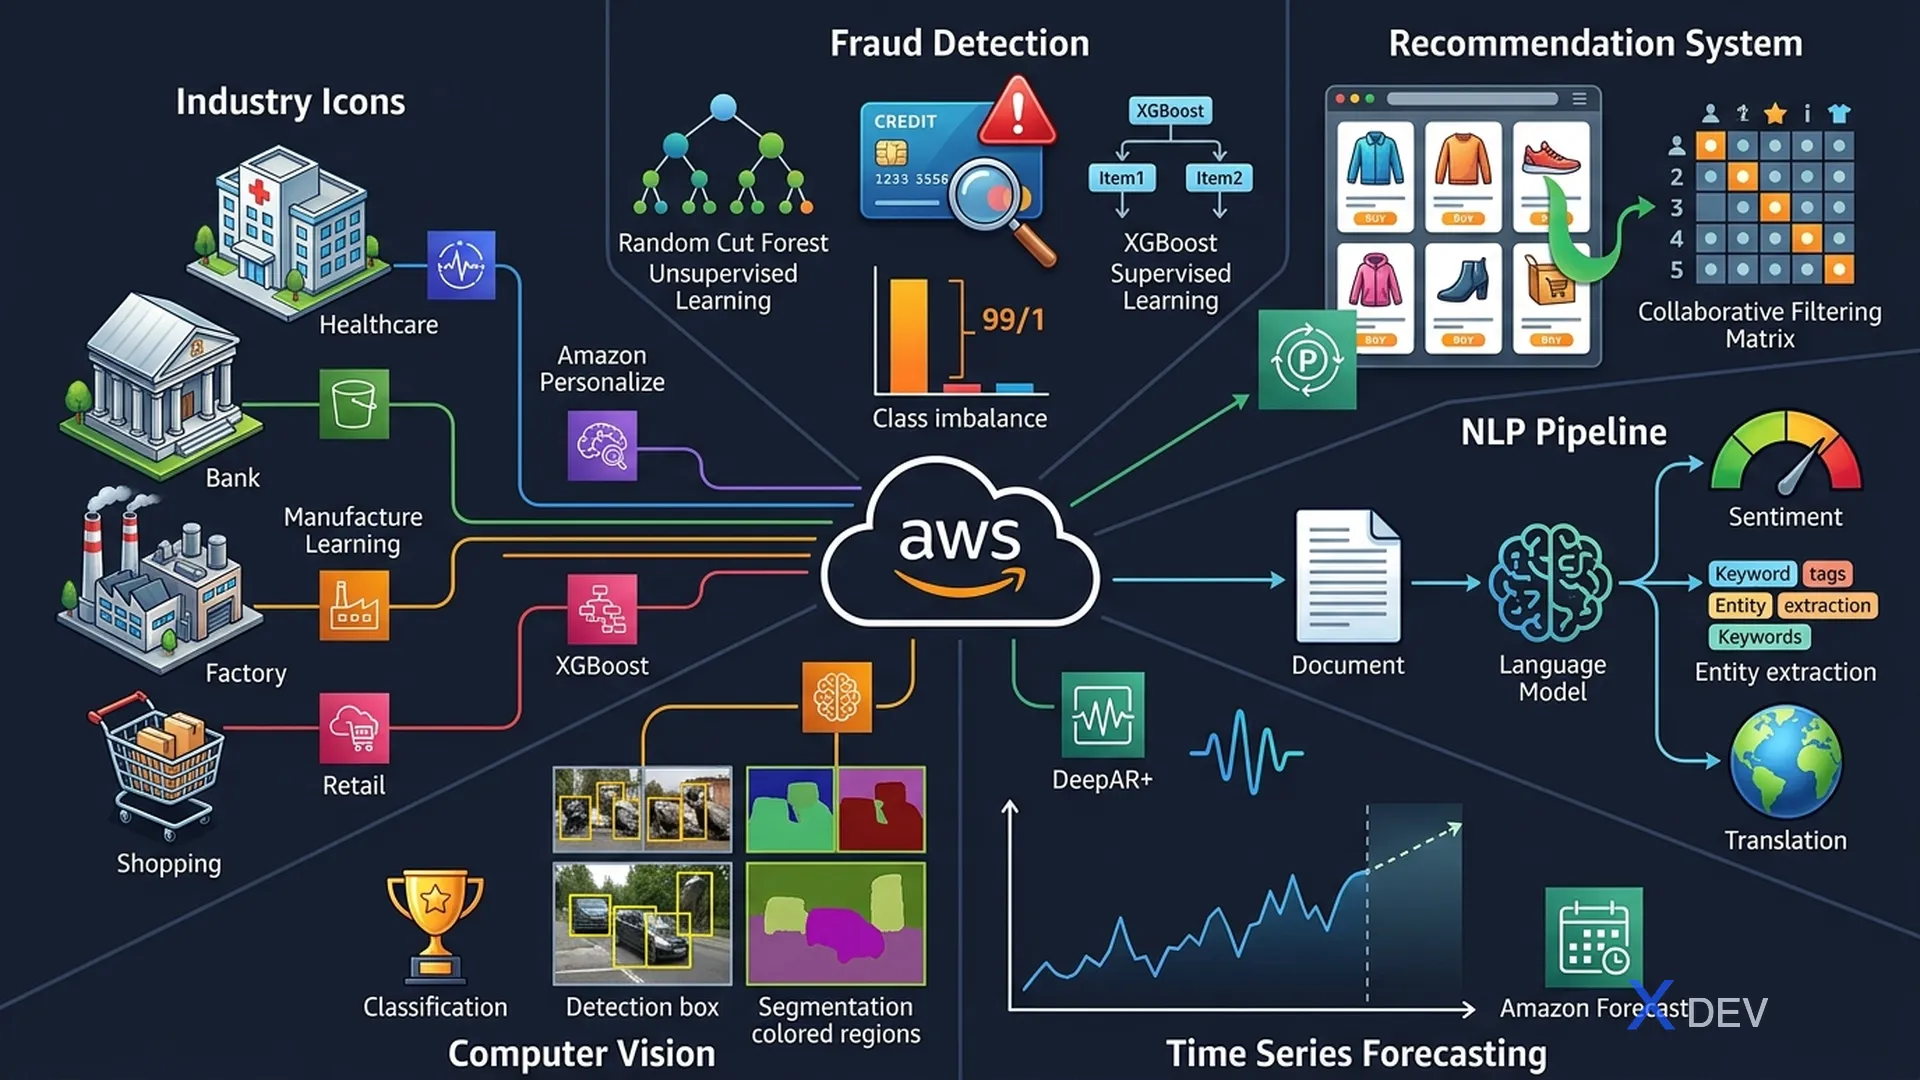
不正検知は試験の典型的な問題です。主要な課題:極端なクラス不均衡(99.9%のトランザクションが正常)。
| 課題 | 解決策 |
|---|---|
| クラス不均衡 | SMOTE、class_weight、precision-recall(accuracyではない) |
| リアルタイムスコアリング | SageMakerリアルタイムエンドポイント |
| 教師なし不正検知(ラベルなし) | Random Cut Forest(異常検知) |
| グラフベースの不正リング | Amazon Neptune + GNN(GraphSAGE) |
| 教師あり(ラベル付き履歴あり) | XGBoostまたはLinear Learner |
試験のヒント: 問題に「ラベルなし」「異常行動の検出」とある場合 → Random Cut Forest。ラベル付きの不正取引履歴がある場合 → 分類(XGBoost)。
3. レコメンデーションシステム
| タイプ | アルゴリズム | AWSサービス |
|---|---|---|
| 協調フィルタリング | Factorization Machines、Neural CF | SageMaker FM、Amazon Personalize |
| コンテンツベース | TF-IDF、Embeddings | SageMaker KNN |
| ハイブリッド | FM + コンテンツ特徴量 | Amazon Personalize(HRNN) |
| コールドスタート問題 | コンテンツ特徴量、メタデータ | Personalizeコンテキストメタデータ |
試験では頻繁に問われます:「eコマース向けリアルタイムパーソナライズドレコメンデーション」 → 回答はほぼ常にAmazon Personalize(マネージドサービス)です。
4. NLPパイプライン
NLP Task Decision Tree:

Classify documents?
    → Text Classification → BlazingText (word2vec mode), Comprehend Custom

Extract entities from text?
    → Named Entity Recognition → Amazon Comprehend (NER)

Translate text?
    → Amazon Translate

Summarize documents?
    → Hugging Face on SageMaker (T5, BART)

Q&A / Generation?
    → SageMaker JumpStart foundation models (Llama, Falcon)

Toxic content detection?
    → Amazon Comprehend (Sentiment + custom classifier)
| NLPタスク | アルゴリズム/サービス |
|---|---|
| 文書分類 | BlazingText、Comprehend Custom |
| トピックモデリング | Latent Dirichlet Allocation(LDA)、NTM |
| 感情分析 | Amazon Comprehend |
| 言語検出 | Amazon Comprehend |
| 機械翻訳 | Amazon Translate |
| 会話AI | Amazon Lex(チャットボット) + Lambda |
5. 時系列予測
| サービス/アルゴリズム | ユースケース |
|---|---|
| DeepAR+(SageMaker組み込み) | 複数の関連時系列、コールドスタート |
| Amazon Forecast | フルマネージド、ビジネス予測(需要、在庫) |
| ARIMA | 単一の定常系列、古典的アプローチ |
| Prophet | 季節性 + 祝日、Facebookのライブラリ |
試験のヒント: 「数千の製品の小売需要を予測」→ DeepAR+(複数の関連時系列)またはAmazon Forecast(マネージド)。主な差別化要因:DeepAR+はすべてのアイテムに対して1つのモデルを訓練しますが、古典的手法は系列ごとに1つのモデルが必要です。
6. コンピュータビジョン
| CVタスク | アルゴリズム | サービス |
|---|---|---|
| 画像分類 | Image Classification(ResNet) | SageMaker組み込み |
| 物体検出 | Object Detection(SSD/YOLO) | SageMaker組み込み |
| セマンティックセグメンテーション | Semantic Segmentation | SageMaker組み込み |
| Rekognition(ML不要) | 顔、物体、テキスト、モデレーション | Amazon Rekognition |
| 画像のカスタムラベル | ファインチューニング | Rekognition Custom Labels |
7. ビジネスドメイン → AWSサービスマッピング
| 業界/シナリオ | AWSサービス |
|---|---|
| eコマースパーソナライゼーション | Amazon Personalize |
| コールセンター分析 | Amazon Transcribe + Comprehend |
| 医療画像分析 | Amazon HealthLake + SageMaker(カスタムモデル) |
| 文書理解(請求書、フォーム) | Amazon Textract |
| 製品検索(セマンティック) | Amazon OpenSearch + KNN |
| IoT異常検知 | Amazon Lookout for Equipment |
| 製造欠陥検出 | Amazon Lookout for Vision |
| 財務予測(マネージド) | Amazon Forecast |
| 離反予測 | XGBoost(SageMaker) |
8. 練習問題
Q1: ある小売企業が祝日の季節性とプロモーションイベントを考慮して、10,000の個別製品の来四半期の売上を予測したいと考えています。最も適切なソリューションはどれですか?
- A) 10,000の製品それぞれに個別のARIMAモデルを訓練
- B) 関連時系列データを含むAmazon Forecastを使用 ✓
- C) トレンド分析にAmazon Comprehendを使用
- D) 製品画像の分析にAmazon Rekognitionを使用
解説:Amazon Forecastは大規模なビジネス需要予測向けに設計されており、数千の関連時系列を同時に処理でき、祝日やプロモーションなどの外部要因をサポートします。10,000の個別ARIMAモデルの訓練は非現実的で、系列間のパターンを見逃します。
Q2: ある銀行がラベル付きの過去の不正データなしにリアルタイムで不正取引を検出する必要があります。どのアルゴリズムを使用すべきですか?
- A) XGBoost分類器
- B) 二値分類のLinear Learner
- C) Random Cut Forest ✓
- D) BlazingText
解説:ラベル付き不正データがない場合、これは教師なし異常検知問題です。Random Cut Forestはラベル付き例を必要とせずに異常(通常パターンから逸脱した取引)を検出します。XGBoostとLinear Learnerは教師ありであり、ラベル付き訓練データが必要です。
Q3: ある企業がスキャンされた保険請求書フォーム(PDF)からキーバリューペアを抽出したいと考えています。カスタムML訓練は行われていません。どのAWSサービスを使用すべきですか?
- A) Amazon Comprehend
- B) Amazon Textract ✓
- C) SageMaker Object Detection
- D) Amazon Rekognition
解説:Amazon Textractは、PDFを含むスキャンされた文書からテキスト、フォーム(キーバリューペア)、テーブルを抽出するために特別に構築されています。ML訓練は不要です。Comprehendはテキストの意味を分析し、Rekognitionは画像を分析しますが、どちらもTextractのような構造化フォーム抽出を処理しません。