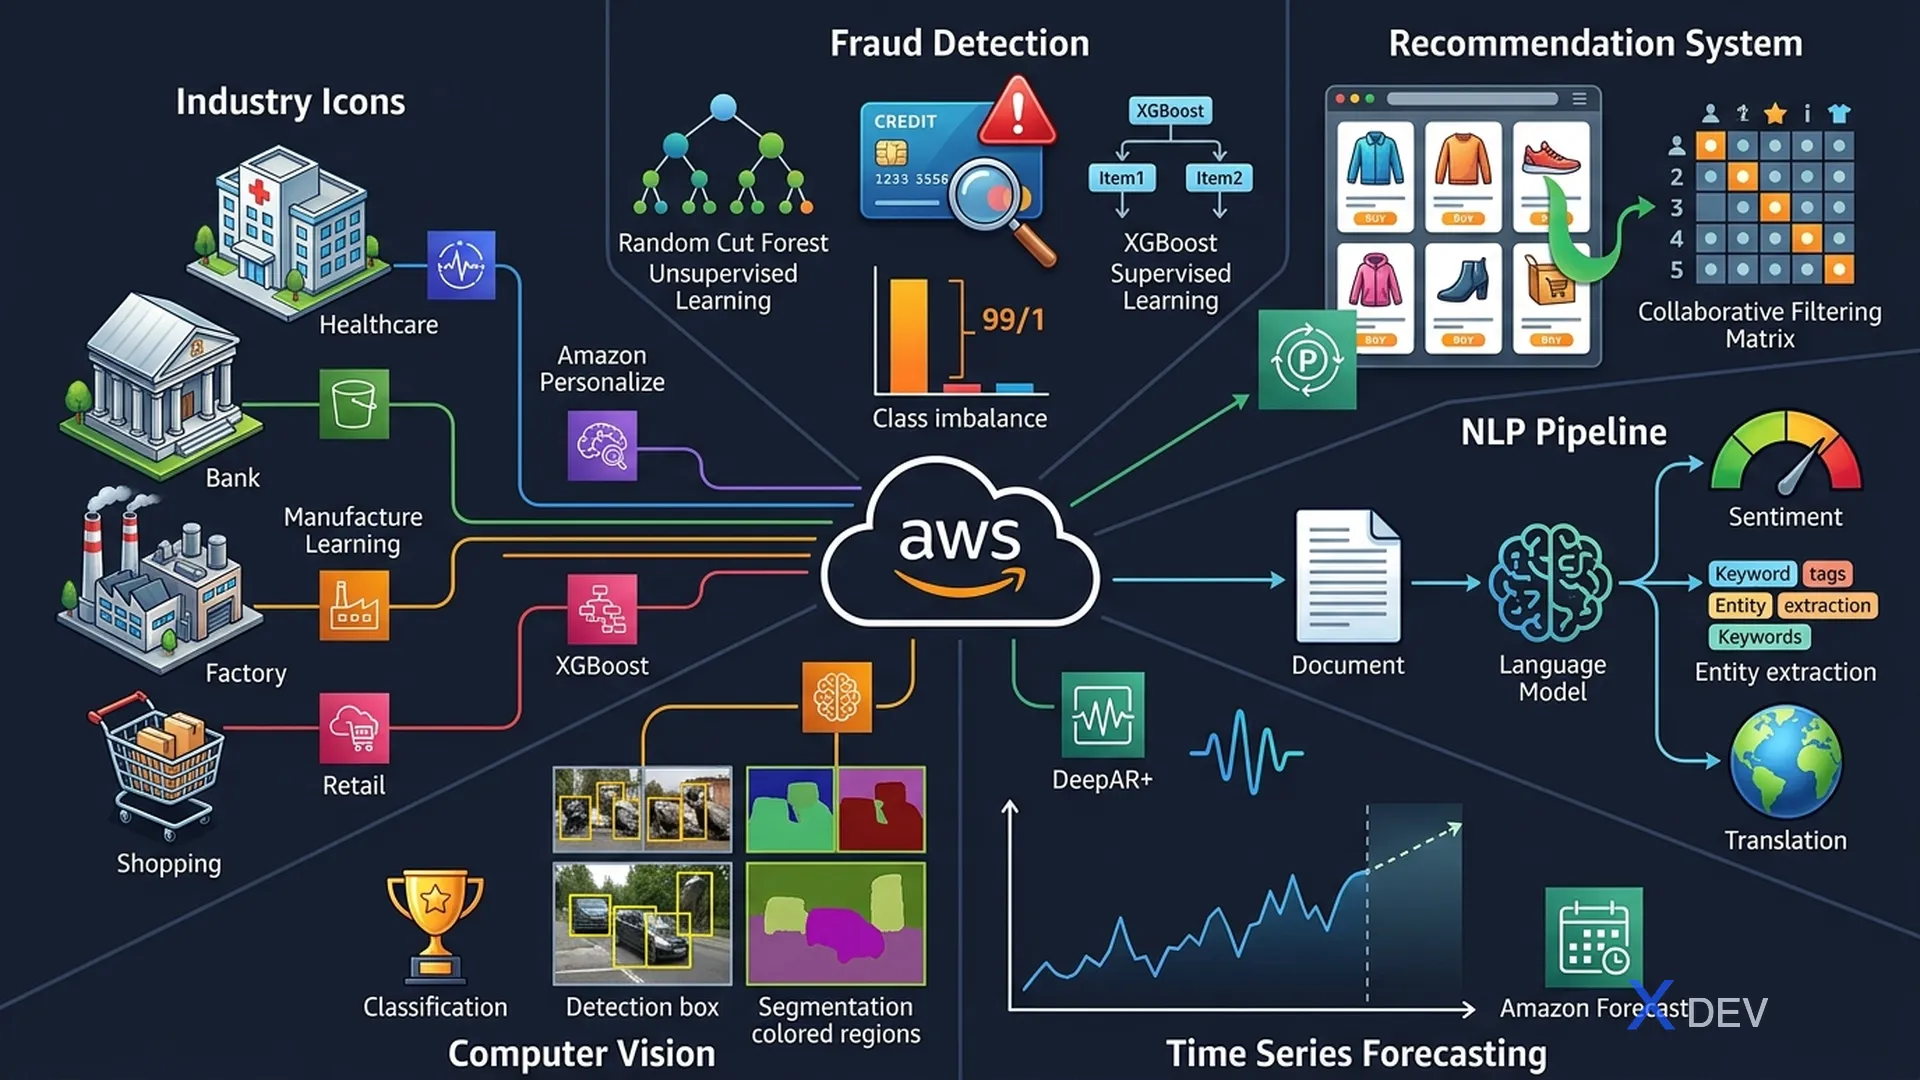
ML問題模式:AWS上的欺詐檢測、推薦、NLP、時間序列與電腦視覺
1. 快速識別問題類型
MLS-C01大部分問題是情境式的:閱讀商業問題描述,選擇最適合的AWS服務或演算法。本課提供快速識別的框架。
ML Problem Recognition Framework:

READ SCENARIO
    ↓
Is output a CATEGORY?          → Classification
Is output a NUMBER?            → Regression
Is output a CLUSTER/GROUP?     → Clustering (no labels)
Is output a RANK/SCORE?        → Recommendation / Ranking
Is output a DETECTION (anomaly)? → Anomaly Detection
Is output a SEQUENCE?          → Time Series / Seq2Seq
2. 欺詐檢測
欺詐檢測是考試中的經典問題。關鍵挑戰:極端類別不平衡(99.9%的交易是合法的)。
| 挑戰 | 解決方案 |
|---|---|
| 類別不平衡 | SMOTE、class_weight、precision-recall(非accuracy) |
| 即時評分 | SageMaker即時端點 |
| 非監督式欺詐(無標籤) | Random Cut Forest(異常檢測) |
| 基於圖的欺詐網絡 | Amazon Neptune + GNN(GraphSAGE) |
| 監督式(有標註歷史) | XGBoost或Linear Learner |
考試提示: 當問題提到「沒有欺詐標籤」或「檢測異常行為」→ Random Cut Forest。當有已標註的欺詐交易歷史 → 分類(XGBoost)。
3. 推薦系統
| 類型 | 演算法 | AWS服務 |
|---|---|---|
| 協同過濾 | Factorization Machines、Neural CF | SageMaker FM、Amazon Personalize |
| 基於內容 | TF-IDF、Embeddings | SageMaker KNN |
| 混合 | FM + 內容特徵 | Amazon Personalize(HRNN) |
| 冷啟動問題 | 內容特徵、元數據 | Personalize上下文元數據 |
考試經常問:「電商的即時個人化推薦」 → 答案幾乎總是Amazon Personalize(託管服務)。
4. NLP管線
NLP Task Decision Tree:

Classify documents?
    → Text Classification → BlazingText (word2vec mode), Comprehend Custom

Extract entities from text?
    → Named Entity Recognition → Amazon Comprehend (NER)

Translate text?
    → Amazon Translate

Summarize documents?
    → Hugging Face on SageMaker (T5, BART)

Q&A / Generation?
    → SageMaker JumpStart foundation models (Llama, Falcon)

Toxic content detection?
    → Amazon Comprehend (Sentiment + custom classifier)
| NLP任務 | 演算法/服務 |
|---|---|
| 文件分類 | BlazingText、Comprehend Custom |
| 主題建模 | Latent Dirichlet Allocation(LDA)、NTM |
| 情感分析 | Amazon Comprehend |
| 語言檢測 | Amazon Comprehend |
| 機器翻譯 | Amazon Translate |
| 對話式AI | Amazon Lex(聊天機器人)+ Lambda |
5. 時間序列預測
| 服務/演算法 | 使用情境 |
|---|---|
| DeepAR+(SageMaker內建) | 多個相關時間序列、冷啟動 |
| Amazon Forecast | 全託管、商業預測(需求、庫存) |
| ARIMA | 單一平穩序列、傳統方法 |
| Prophet | 季節性 + 節假日、Facebook函式庫 |
考試提示: 「預測數千個產品的零售需求」→ DeepAR+(多個相關序列)或Amazon Forecast(託管)。關鍵差異:DeepAR+為所有項目訓練一個模型,而傳統方法需要每個序列一個模型。
6. 電腦視覺
| CV任務 | 演算法 | 服務 |
|---|---|---|
| 影像分類 | Image Classification(ResNet) | SageMaker內建 |
| 物體檢測 | Object Detection(SSD/YOLO) | SageMaker內建 |
| 語義分割 | Semantic Segmentation | SageMaker內建 |
| Rekognition(無需ML) | 人臉、物體、文字、內容審核 | Amazon Rekognition |
| 影像中的自訂標籤 | 微調 | Rekognition Custom Labels |
7. 商業領域 → AWS服務對應表
| 產業 / 情境 | AWS服務 |
|---|---|
| 電商個人化 | Amazon Personalize |
| 客服中心分析 | Amazon Transcribe + Comprehend |
| 醫療影像分析 | Amazon HealthLake + SageMaker(自訂模型) |
| 文件理解(發票、表單) | Amazon Textract |
| 產品搜尋(語義) | Amazon OpenSearch + KNN |
| IoT異常檢測 | Amazon Lookout for Equipment |
| 製造瑕疵檢測 | Amazon Lookout for Vision |
| 財務預測(託管) | Amazon Forecast |
| 客戶流失預測 | XGBoost(SageMaker) |
8. 練習題
Q1: 一家零售公司想要預測10,000個產品下一季度的銷售額,並納入節假日季節性和促銷活動。最適當的解決方案是哪個?
- A) 為10,000個產品各訓練單獨的ARIMA模型
- B) 使用Amazon Forecast搭配相關時間序列數據 ✓
- C) 使用Amazon Comprehend進行趨勢分析
- D) 使用Amazon Rekognition分析產品圖片
解析:Amazon Forecast專為大規模商業需求預測設計,可同時處理數千個相關時間序列,並支援節假日和促銷等外部因素。為10,000個產品訓練單獨的ARIMA模型不切實際且會錯過跨序列模式。
Q2: 一家銀行需要即時檢測欺詐交易,但沒有已標註的歷史欺詐數據。應該使用哪個演算法?
- A) XGBoost分類器
- B) Linear Learner二元分類
- C) Random Cut Forest ✓
- D) BlazingText
解析:沒有已標註的欺詐數據,這是一個非監督式異常檢測問題。Random Cut Forest無需標註範例即可檢測異常(偏離正常模式的交易)。XGBoost和Linear Learner是監督式的,需要已標註的訓練數據。
Q3: 一家公司想要從掃描的保險理賠表單(PDF)中擷取鍵值對。沒有進行過自訂ML訓練。應該使用哪個AWS服務?
- A) Amazon Comprehend
- B) Amazon Textract ✓
- C) SageMaker Object Detection
- D) Amazon Rekognition
解析:Amazon Textract專門設計用於從掃描文件(包括PDF)中擷取文字、表單(鍵值對)和表格。無需ML訓練。Comprehend分析文字含義;Rekognition分析影像;兩者都不像Textract那樣處理結構化表單擷取。