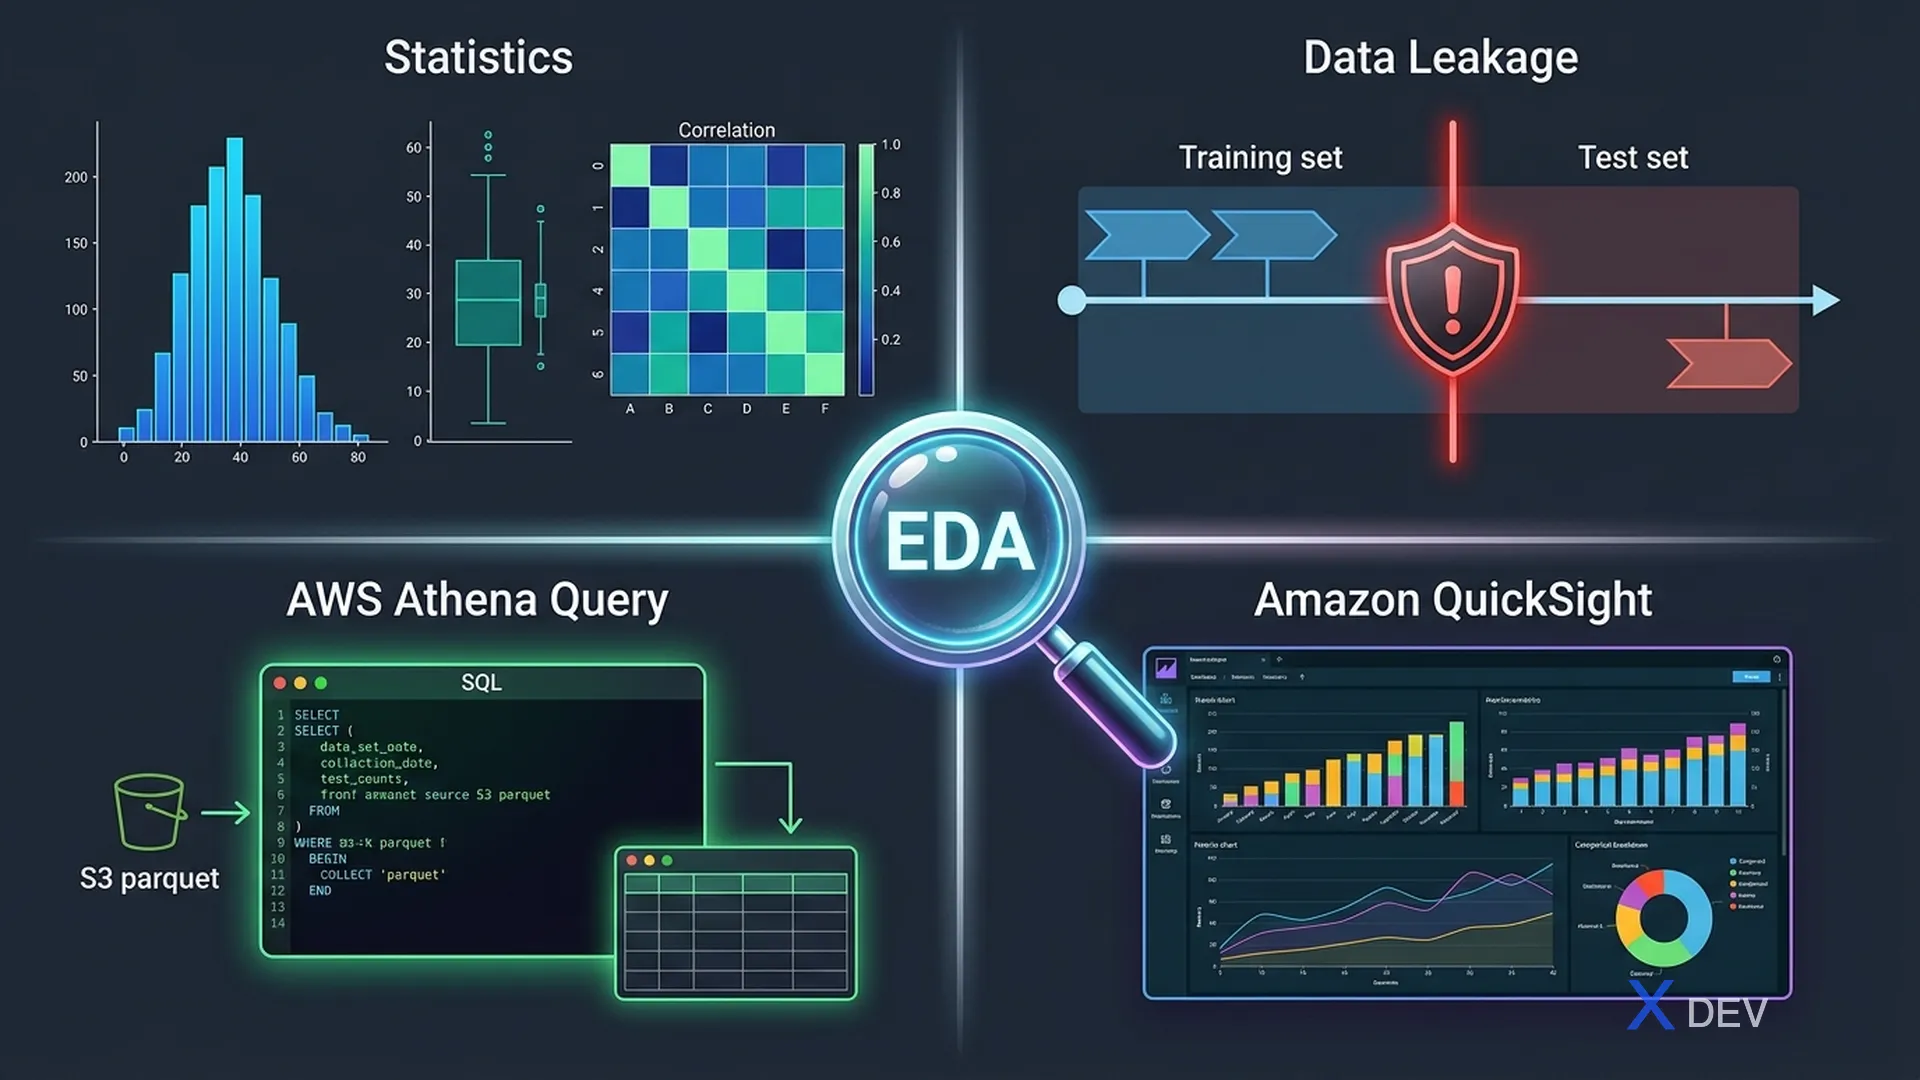
EDAとデータ分析:記述統計、外れ値検出、AWS上での特徴量相関
1. 探索的データ分析(EDA)
EDAはモデリング前にデータの構造、パターン、異常を理解するための初期分析ステップです。SageMakerは大規模なEDAを実行するための多くのツールを提供しています。
2. データ分析用AWSツール
| ツール | ユースケース | インターフェース |
|---|---|---|
| SageMaker Studio Notebooks | インタラクティブEDA、Python/R分析 | JupyterLabベースのIDE |
| SageMaker Data Wrangler | ビジュアルデータ準備、300以上の変換、自動インサイト | ドラッグ&ドロップGUI |
| Amazon Athena | S3データ上のSQLクエリ | SQLコンソール |
| Amazon QuickSight | BIダッシュボード、経営レポート | ビジュアルBIツール |
| Amazon Redshift | 大規模データウェアハウス、SQL分析 | SQL |
| AWS Glue DataBrew | ノーコードデータプロファイリングとクリーニングレシピ | ビジュアルツール |
試験のヒント: Data Wrangler = ML向けビジュアルデータ準備(SageMaker Processingコードを生成)。DataBrew = データアナリスト/BI向け(MLコンテキストなし)。QuickSight = ビジネスユーザー向けBIダッシュボード、MLではない。
3. データ品質の問題
試験ではデータ品質に関する一般的な問題の識別と対処方法がよく出題されます。
| 問題 | 検出方法 | モデルへの影響 |
|---|---|---|
| 欠損値 | Null数、列ごとの欠損率 | エラー、偏った結果 |
| 外れ値 | 箱ひげ図、Z-score > 3、IQR法 | 重みの歪み、汎化性能の低下 |
| クラス不均衡 | クラス分布ヒストグラム | 多数クラスへの偏り |
| 特徴量相関 | 相関行列、VIFスコア | 多重共線性 → 不安定な係数 |
| データリーケージ | ターゲットとの異常に高い相関を持つ特徴量 | 過大評価、本番で失敗 |
| 分布の歪み | ヒストグラム、歪度指標 | モデルの仮定違反 |
3.1. データリーケージ — 重要概念
データリーケージは訓練セット外の情報が特徴量に漏れ込み、訓練時のaccuracyが高くなるが本番で失敗する現象です。
Common Data Leakage Patterns:

❌ Target leakage:
   Feature "loan_default_flag" → predicting "credit_risk"
   (feature derived from target)

❌ Future data leakage:
   Using tomorrow's stock price to predict today's trade

❌ Train/test contamination:
   Scaling data BEFORE splitting (test mean leaks into train)

✅ Correct approach:
   Split data FIRST → fit scaler on train only → transform both
試験のヒント: 常に変換前にデータを分割してください。StandardScaler.fit()は訓練セットのみで呼び出し、その後transform()を訓練セットとテストセットの両方に適用します。データセット全体でfit+transformするとデータリーケージになります。
4. Amazon Athena
AthenaはデータベースにロードせずにS3上で直接SQLクエリを実行できます。スキャンあたりの課金のため、Parquet + パーティショニングで最適化します。
Cost Optimization Tips:
┌────────────────────────────────────────────────┐
│  Partition data by date/region/category:       │
│  s3://bucket/data/year=2024/month=01/          │
│  → Query chỉ scan the required partitions      │
│                                                │
│  Use columnar formats (Parquet/ORC):           │
│  → Read only needed columns                   │
│                                               │
│  Compress data (Snappy, Gzip):                │
│  → Reduce scan size → reduce cost             │
└────────────────────────────────────────────────┘
5. Amazon QuickSight
QuickSightはBIサービスであり、MLツールではありません。主要機能:SPICE(インメモリエンジン)による高速ダッシュボード。
| 機能 | 説明 |
|---|---|
| SPICE | Super-fast Parallel In-memory Calculation Engine — キャッシュされたデータセット |
| ML Insights | ダッシュボード上の組み込み異常検知、予測 |
| Q (NLQ) | 自然言語クエリ — 「先月の地域別売上を表示」 |
6. チートシート — 分析ツール
| シナリオ | ツール |
|---|---|
| 大規模データのインタラクティブPython EDA | SageMaker Studio Notebooks |
| ビジュアルノーコードMLデータ準備 | SageMaker Data Wrangler |
| S3データ上のSQL(サーバーレス) | Amazon Athena |
| ビジネスダッシュボードとレポート | Amazon QuickSight |
| 大規模データウェアハウスSQL | Amazon Redshift |
| ノーコードデータプロファイリングレシピ | AWS Glue DataBrew |
7. 練習問題
Q1: データサイエンティストがデータセット全体の平均と標準偏差を使って特徴量を標準化してから、訓練/テストセットに分割しました。これはどのような問題を引き起こしますか?
- A) モデルの未学習
- B) 訓練の収束が遅い
- C) テストセットの統計量が訓練に漏れるデータリーケージ ✓
- D) クラス不均衡
解説:データセット全体でスケーラーをフィッティングすると、テストセットの統計量(平均、標準偏差)が訓練データの変換に影響するデータリーケージが発生します。常に訓練データのみでトランスフォーマーをフィットし、フィット済みトランスフォーマーを訓練とテスト両方に適用してください。
Q2: ビジネスアナリストがS3データから高速なインタラクティブ可視化を備えた経営ダッシュボードを作成する必要があります。最適なAWSサービスはどれですか?
- A) Amazon SageMaker Studio
- B) Amazon Athena
- C) Amazon QuickSight ✓
- D) AWS Glue DataBrew
解説:Amazon QuickSightはSPICEインメモリエンジンによる高速なインタラクティブクエリを備えた、ビジネスダッシュボードと可視化のために設計されたAWS BIサービスです。
Q3: 顧客離反データで訓練されたモデルが99%の訓練accuracyを達成しましたが、本番データでのパフォーマンスが低いです。調査の結果、「days_since_last_call」が予想以上に予測力が高いことがわかりました。最も可能性の高い原因は何ですか?
- A) 特徴量が多すぎることによる過学習
- B) モデル複雑性の不足による未学習
- C) データリーケージ — 特徴量が離反後の活動から導出されている ✓
- D) クラス不均衡
解説:これは典型的なターゲットリーケージです — 「days_since_last_call」は離反後の行動を反映している可能性があります(顧客が解約のために電話する)。この将来の情報は本番では利用できないため、モデルが失敗します。