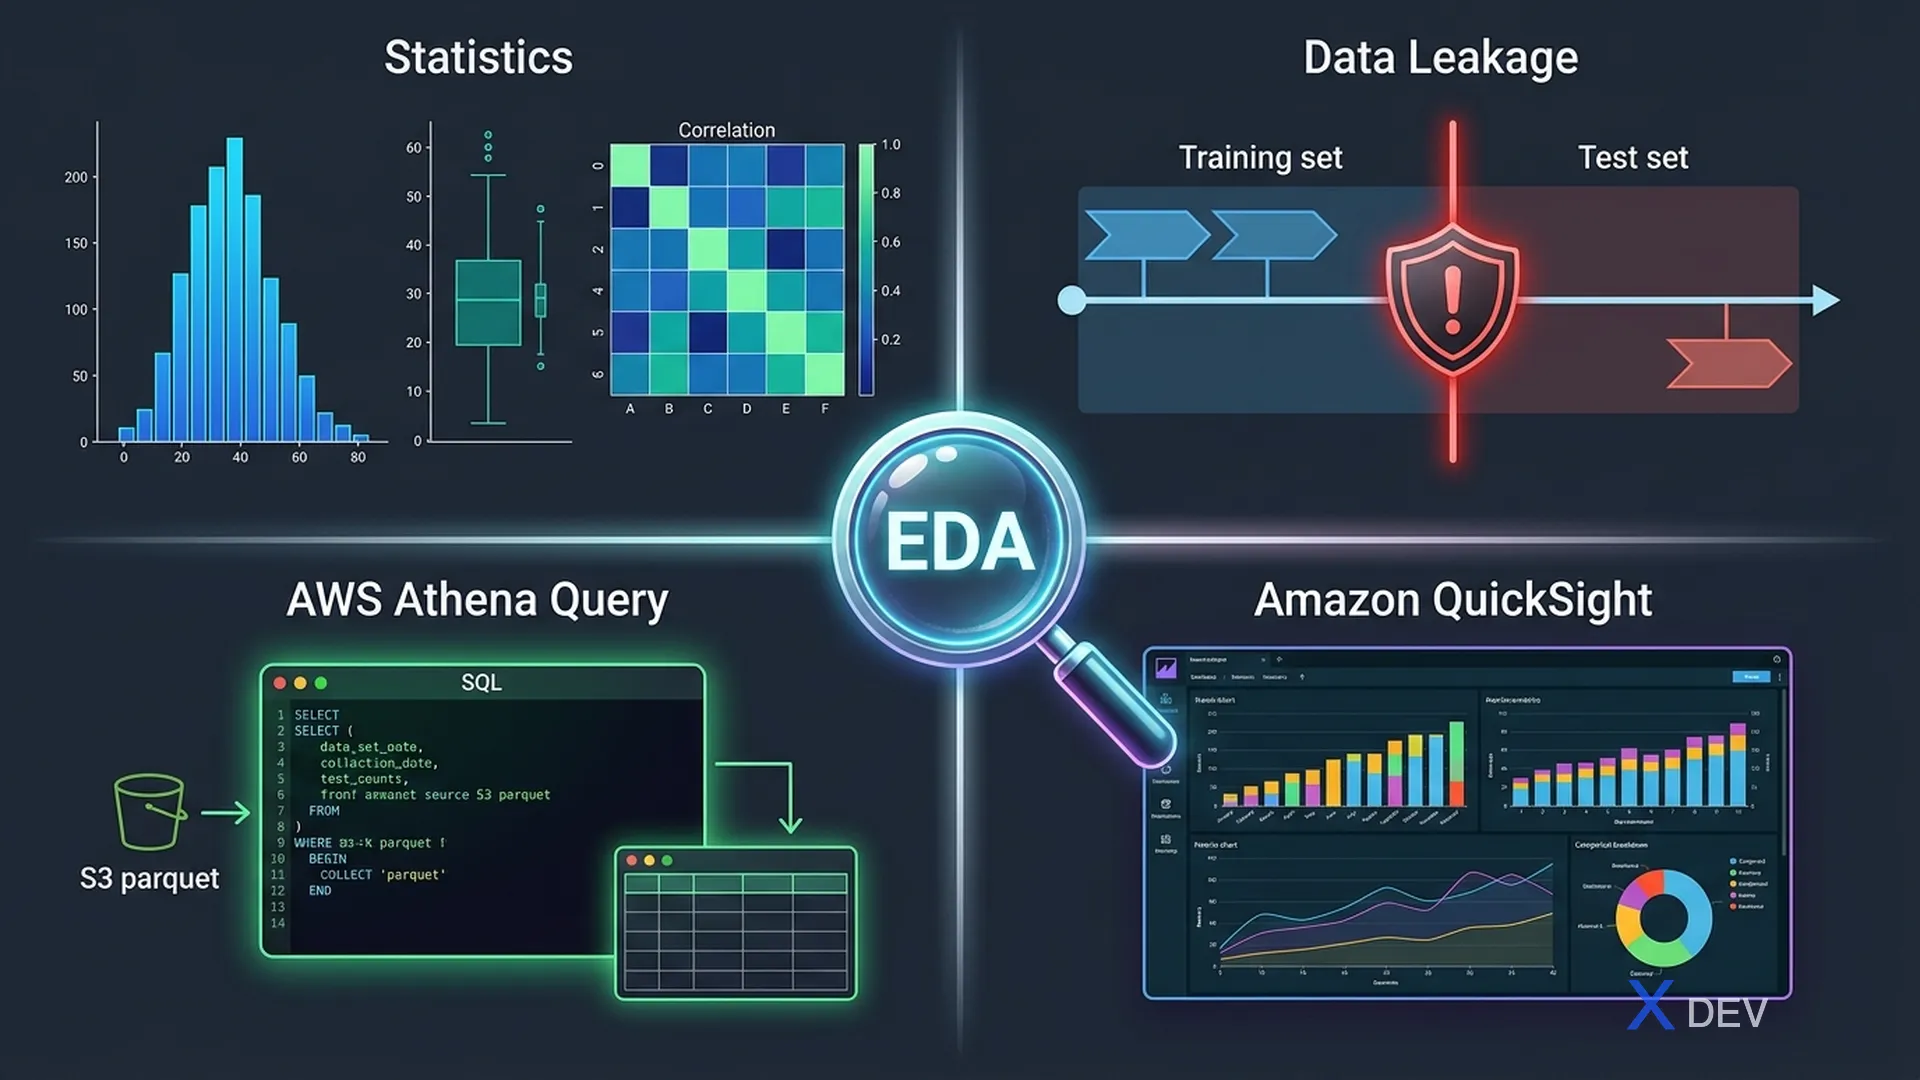
EDA與數據分析:描述性統計、離群值檢測、AWS上的特徵相關性
1. 探索性數據分析(EDA)
EDA是建模前了解數據結構、模式和異常的初始分析步驟。SageMaker提供了許多工具來執行大規模EDA。
2. 數據分析用AWS工具
| 工具 | 使用情境 | 介面 |
|---|---|---|
| SageMaker Studio Notebooks | 互動式EDA、Python/R分析 | JupyterLab為基礎的IDE |
| SageMaker Data Wrangler | 視覺化數據準備、300+轉換、自動洞察 | 拖放式GUI |
| Amazon Athena | S3數據上的SQL查詢 | SQL主控台 |
| Amazon QuickSight | BI儀表板、經營報告 | 視覺化BI工具 |
| Amazon Redshift | 大規模數據倉儲、SQL分析 | SQL |
| AWS Glue DataBrew | 無程式碼數據分析與清理配方 | 視覺化工具 |
考試提示: Data Wrangler = ML的視覺化數據準備(產生SageMaker Processing程式碼)。DataBrew = 數據分析師/BI用途(無ML脈絡)。QuickSight = 商業用戶的BI儀表板,非ML。
3. 數據品質問題
| 問題 | 檢測方法 | 對模型的影響 |
|---|---|---|
| 缺失值 | Null計數、每列缺失率 | 錯誤、偏差結果 |
| 離群值 | 箱形圖、Z-score > 3、IQR法 | 權重偏斜、泛化能力下降 |
| 類別不平衡 | 類別分佈直方圖 | 偏向多數類別 |
| 特徵相關性 | 相關矩陣、VIF分數 | 多重共線性 → 不穩定係數 |
| 數據洩漏 | 與目標變數異常高相關的特徵 | 過高評估、正式環境失敗 |
| 分佈偏斜 | 直方圖、偏度指標 | 違反模型假設 |
3.1. 數據洩漏 — 重要概念
數據洩漏是訓練集外的資訊洩漏到特徵中,導致訓練時accuracy很高但正式環境失敗的現象。
Common Data Leakage Patterns:

❌ Target leakage:
   Feature "loan_default_flag" → predicting "credit_risk"
   (feature derived from target)

❌ Future data leakage:
   Using tomorrow's stock price to predict today's trade

❌ Train/test contamination:
   Scaling data BEFORE splitting (test mean leaks into train)

✅ Correct approach:
   Split data FIRST → fit scaler on train only → transform both
考試提示: 務必在轉換前先分割數據。StandardScaler.fit()僅在訓練集上呼叫,然後transform()應用於訓練集和測試集。在整個數據集上fit+transform就會造成數據洩漏。
4. Amazon Athena
Athena可以直接在S3上執行SQL查詢而無需載入資料庫。按掃描量計費,因此使用Parquet + 分區進行最佳化。
5. Amazon QuickSight
QuickSight是BI服務,不是ML工具。主要功能:SPICE(記憶體引擎)提供快速儀表板。
| 功能 | 說明 |
|---|---|
| SPICE | Super-fast Parallel In-memory Calculation Engine — 快取數據集 |
| ML Insights | 儀表板上的內建異常檢測、預測 |
| Q (NLQ) | 自然語言查詢 — 「顯示上個月各地區的銷售額」 |
6. 速查表 — 分析工具
| 情境 | 工具 |
|---|---|
| 大規模數據的互動式Python EDA | SageMaker Studio Notebooks |
| 視覺化無程式碼ML數據準備 | SageMaker Data Wrangler |
| S3數據上的SQL(無伺服器) | Amazon Athena |
| 商業儀表板和報告 | Amazon QuickSight |
| 大規模數據倉儲SQL | Amazon Redshift |
| 無程式碼數據分析配方 | AWS Glue DataBrew |
7. 練習題
Q1: 數據科學家使用整個數據集的均值和標準差來標準化特徵,然後才分割為訓練/測試集。這會導致什麼問題?
- A) 模型欠擬合
- B) 訓練收斂緩慢
- C) 測試集統計量洩漏到訓練的數據洩漏 ✓
- D) 類別不平衡
解析:在整個數據集上擬合縮放器會導致數據洩漏,因為測試集的統計量(均值、標準差)會影響訓練數據的轉換。務必僅在訓練數據上擬合轉換器,然後將擬合後的轉換器應用於訓練和測試兩者。
Q2: 商業分析師需要從S3數據建立具有快速互動視覺化的經營儀表板。最佳的AWS服務是哪個?
- A) Amazon SageMaker Studio
- B) Amazon Athena
- C) Amazon QuickSight ✓
- D) AWS Glue DataBrew
解析:Amazon QuickSight是專為商業儀表板和視覺化設計的AWS BI服務,搭配SPICE記憶體引擎提供快速互動查詢。
Q3: 在客戶流失數據上訓練的模型達到了99%的訓練accuracy,但在正式環境數據上表現不佳。調查發現「days_since_last_call」的預測力異常高。最可能的原因是什麼?
- A) 特徵太多導致過擬合
- B) 模型複雜度不足導致欠擬合
- C) 數據洩漏 — 特徵來自流失後的活動 ✓
- D) 類別不平衡
解析:這是典型的目標洩漏 — 「days_since_last_call」可能反映了流失後的行為(客戶打電話取消)。這種未來資訊在正式環境中不可用,導致模型失敗。