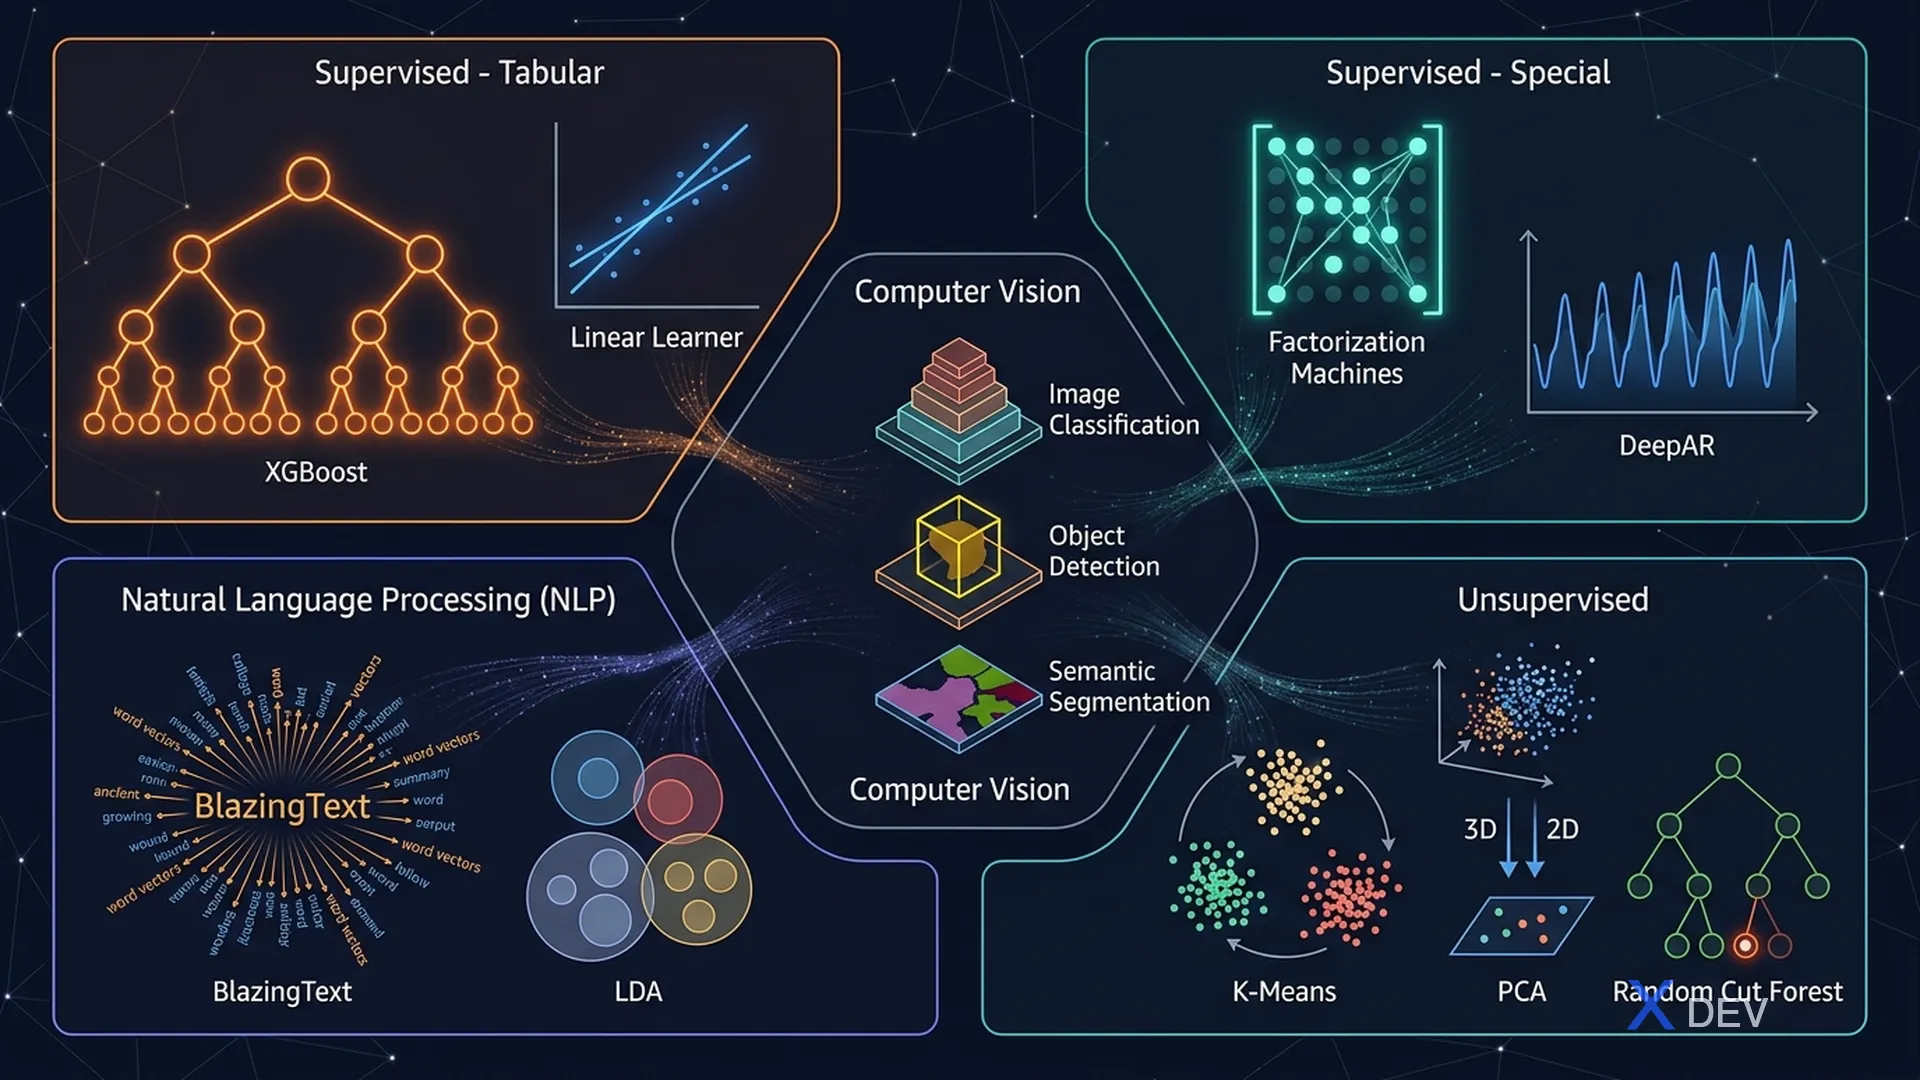
SageMaker組み込みアルゴリズム:XGBoost、Linear LearnerからDeepAR、Image Classificationまで
1. SageMaker組み込みアルゴリズムの概要
SageMakerは18以上の組み込みアルゴリズムを提供し、AWSインフラストラクチャ上で分散実行するために最適化されています。これはMLS-C01で非常に重要なトピックで、通常8〜12問出題されます。
試験のヒント: 「問題タイプ → アルゴリズム」の表を暗記してください。試験では常にシナリオが提示され、適切なアルゴリズムが問われます。主要パターン:時系列 → DeepAR、異常 → Random Cut Forest、NLP分類 → BlazingText、テーブルデータ → XGBoost。
2. 教師あり学習アルゴリズム
| アルゴリズム | 問題タイプ | 入力 | 主な特徴 |
|---|---|---|---|
| XGBoost | 分類、回帰 | テーブルデータ(CSV/LibSVM) | テーブルデータの最高性能、勾配ブースティング |
| Linear Learner | 二値/多クラス分類、回帰 | RecordIO、CSV | 高速、スケーラブル、正則化内蔵 |
| Factorization Machines | 二値分類、回帰 | RecordIO-protobuf(疎データ) | 疎データ、レコメンデーション、CTR予測 |
| KNN(k近傍法) | 分類、回帰 | RecordIO-protobuf | インスタンスベース、訓練不要、遅延学習 |
| DeepAR | 時系列予測 | JSON Lines | 複数の関連時系列、確率的予測 |
| Object2Vec | Embeddings | ペア入力 | 単語、製品、ユーザーの埋め込みを学習 |
3. NLPアルゴリズム
| アルゴリズム | 出力 | ユースケース |
|---|---|---|
| BlazingText | 単語ベクトルまたはテキスト分類 | 感情分析、スパム検出、エンティティ分類 |
| Seq2Seq | 系列 → 系列 | 機械翻訳、要約、Q&A |
| LDA(Latent Dirichlet Allocation) | 文書ごとのトピック | トピックモデリング、文書分類 |
| NTM(Neural Topic Model) | 潜在表現 | ニューラルネットワークによるトピックモデリング |
試験のヒント: BlazingTextには2つのモードがあります:(1)
Word2Vecモード — 教師なし、単語埋め込みを生成;(2)Text Classificationモード — 教師あり、FastTextに類似。問題を読む際に明確に区別してください。
4. 教師なし学習アルゴリズム
| アルゴリズム | 問題タイプ | ユースケース |
|---|---|---|
| K-Means | クラスタリング | 顧客セグメンテーション、文書グルーピング |
| PCA(主成分分析) | 次元削減 | 高次元データ、特徴量圧縮 |
| Random Cut Forest (RCF) | 異常検知 | 不正検知、IoT異常、時系列異常 |
| IP Insights | 異常検知 | 異常なIP-エンティティ関係の検出、セキュリティ |
5. コンピュータビジョンアルゴリズム
| アルゴリズム | タスク | 出力 |
|---|---|---|
| Image Classification | 多クラス分類 | クラスラベル + 信頼度 |
| Object Detection | オブジェクトの位置特定 + 分類 | バウンディングボックス + ラベル |
| Semantic Segmentation | ピクセルレベルの分類 | セグメンテーションマスク |
6. アルゴリズム選択の決定木
What is the problem type?
│
├── Tabular data, classification/regression?
│   └── XGBoost (best general choice)
│
├── Sparse features, recommendation, ad CTR?
│   └── Factorization Machines
│
├── Time series forecasting (multiple related series)?
│   └── DeepAR
│
├── Anomaly detection on time series / IoT?
│   └── Random Cut Forest (RCF)
│
├── Text classification / sentiment?
│   └── BlazingText (supervised mode)
│
├── Sequence-to-sequence (translation / summarization)?
│   └── Seq2Seq
│
├── Topic modeling?
│   └── LDA or NTM
│
├── Clustering?
│   └── K-Means
│
├── Dimensionality reduction?
│   └── PCA
│
└── Image tasks?
    ├── Classification only → Image Classification
    ├── Locate objects → Object Detection
    └── Pixel mask → Semantic Segmentation
7. 訓練入力モード
| モード | 仕組み | 最適な用途 |
|---|---|---|
| File Mode | 開始前にデータセット全体を訓練インスタンスにダウンロード | 小〜中規模データセット |
| Pipe Mode | 訓練中にS3から直接データをストリーミング | 超大規模データセット — ディスクボトルネックなし |
| FastFile Mode | S3をローカルファイルシステムのようにアクセス(FUSE経由) | ランダムアクセスパターン |
試験のヒント: 「大規模データセットの訓練時間を短縮する」と問われた場合、正解は通常Pipe ModeとRecordIOフォーマットへの切り替えです。Pipe Modeはデータセット全体をダウンロードせず、S3から直接ストリーミングします。
8. チートシート — クイックリファレンス
| 問題のキーワード | アルゴリズム |
|---|---|
| 「テーブルデータ」「構造化データ」 | XGBoost |
| 「時系列」「予測」 | DeepAR |
| 「異常検知」 | Random Cut Forest |
| 「レコメンデーション」「疎な特徴量」 | Factorization Machines |
| 「テキスト分類」「感情分析」 | BlazingText(教師ありモード) |
| 「単語埋め込み」 | BlazingText(Word2Vecモード) |
| 「翻訳」「要約」 | Seq2Seq |
| 「トピックモデリング」 | LDAまたはNTM |
| 「クラスタリング」「セグメンテーション」 | K-Means |
| 「次元削減」 | PCA |
| 「バウンディングボックス」「物体検出」 | Object Detection |
| 「ピクセルレベル」「セグメンテーションマスク」 | Semantic Segmentation |
| 「IPアドレス異常」「不正ログイン」 | IP Insights |
9. 練習問題
Q1: 小売企業が5,000の製品カテゴリについて今後30日間の需要を予測したいと考えています。最適なSageMakerアルゴリズムはどれですか?
- A) K-Means
- B) Linear Learner
- C) DeepAR ✓
- D) Seq2Seq
解説:DeepARは複数の関連時系列にわたる時系列予測に特化して設計されています。5,000の全系列からグローバルパターンを同時に学習し、確率的予測を提供します。
Q2: IoTシステムがサーバーのCPU使用率を監視しています。チームは異常なスパイクを自動検出したいと考えています。どのSageMaker組み込みアルゴリズムを使用すべきですか?
- A) XGBoost
- B) Random Cut Forest ✓
- C) BlazingText
- D) PCA
解説:Random Cut Forest(RCF)はSageMakerの組み込み異常検知アルゴリズムです。各データポイントに異常スコアを割り当て、CPU使用率のスパイクなどの時系列異常検知に適しています。
Q3: データサイエンティストが500GBのデータセットでモデルを訓練しています。訓練インスタンスへのデータダウンロードに時間がかかりすぎて訓練が非常に遅いです。パフォーマンスを最も改善する変更はどれですか?
- A) CSVからJSONフォーマットに切り替え
- B) 訓練インスタンスのサイズを増加
- C) Pipe ModeとRecordIO-protobufフォーマットに切り替え ✓
- D) 訓練エポック数を増加
解説:Pipe Modeは訓練中にS3からデータを直接ストリーミングし、事前ダウンロードなしで大規模データセットのI/Oボトルネックを排除します。RecordIO-protobufフォーマットと組み合わせることで、起動時間が劇的に短縮されます。