SageMaker內建演算法:從XGBoost、Linear Learner到DeepAR、Image Classification
1. SageMaker內建演算法概述
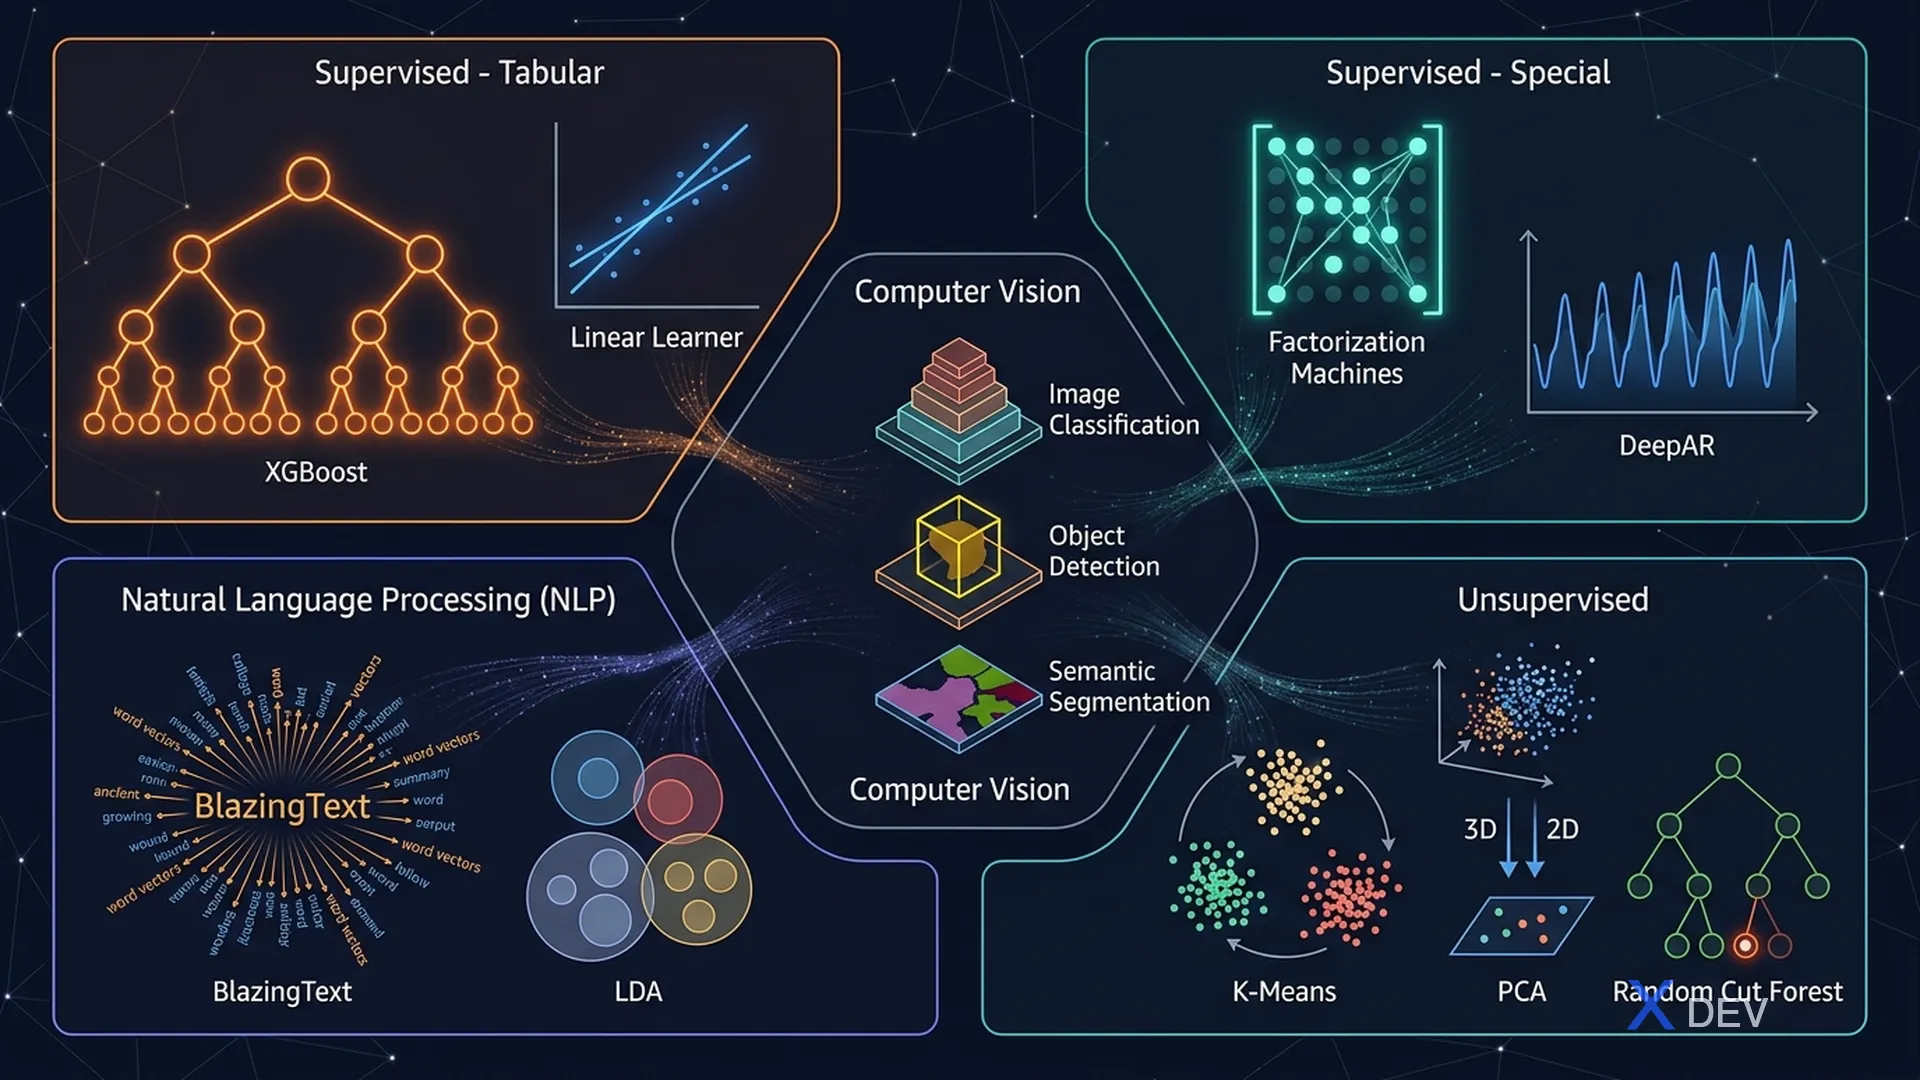
SageMaker提供18種以上的內建演算法,針對AWS基礎設施上的分散式執行進行了最佳化。這是MLS-C01非常重要的主題,通常出8〜12題。
考試提示: 背誦「問題類型 → 演算法」的對應表。考試中總是給出情境並要求選擇適當的演算法。主要模式:時間序列 → DeepAR、異常 → Random Cut Forest、NLP分類 → BlazingText、表格數據 → XGBoost。
2. 監督式學習演算法
| 演算法 | 問題類型 | 輸入 | 主要特點 |
|---|---|---|---|
| XGBoost | 分類、迴歸 | 表格數據(CSV/LibSVM) | 表格數據最佳效能、梯度提升 |
| Linear Learner | 二元/多類別分類、迴歸 | RecordIO、CSV | 快速、可擴展、內建正規化 |
| Factorization Machines | 二元分類、迴歸 | RecordIO-protobuf(稀疏數據) | 稀疏數據、推薦、CTR預測 |
| KNN(k近鄰) | 分類、迴歸 | RecordIO-protobuf | 基於實例、無需訓練、惰性學習 |
| DeepAR | 時間序列預測 | JSON Lines | 多個相關時間序列、機率預測 |
| Object2Vec | Embeddings | 配對輸入 | 學習詞彙、產品、使用者的嵌入 |
3. NLP演算法
| 演算法 | 輸出 | 使用情境 |
|---|---|---|
| BlazingText | 詞向量或文本分類 | 情感分析、垃圾郵件檢測、實體分類 |
| Seq2Seq | 序列 → 序列 | 機器翻譯、摘要、問答 |
| LDA(Latent Dirichlet Allocation) | 每份文件的主題 | 主題建模、文件分類 |
| NTM(Neural Topic Model) | 潛在表示 | 神經網路主題建模 |
考試提示: BlazingText有2種模式:(1)
Word2Vec模式 — 非監督式,產生詞嵌入;(2)Text Classification模式 — 監督式,類似FastText。閱讀問題時需明確區分。
4. 非監督式學習演算法
| 演算法 | 問題類型 | 使用情境 |
|---|---|---|
| K-Means | 分群 | 客戶分群、文件分組 |
| PCA(主成分分析) | 維度縮減 | 高維數據、特徵壓縮 |
| Random Cut Forest (RCF) | 異常檢測 | 欺詐檢測、IoT異常、時間序列異常 |
| IP Insights | 異常檢測 | 異常IP-實體關係檢測、安全 |
5. 電腦視覺演算法
| 演算法 | 任務 | 輸出 |
|---|---|---|
| Image Classification | 多類別分類 | 類別標籤 + 信心度 |
| Object Detection | 物體定位 + 分類 | 邊界框 + 標籤 |
| Semantic Segmentation | 像素級分類 | 分割遮罩 |
6. 演算法選擇決策樹
What is the problem type?
│
├── Tabular data, classification/regression?
│   └── XGBoost (best general choice)
│
├── Sparse features, recommendation, ad CTR?
│   └── Factorization Machines
│
├── Time series forecasting (multiple related series)?
│   └── DeepAR
│
├── Anomaly detection on time series / IoT?
│   └── Random Cut Forest (RCF)
│
├── Text classification / sentiment?
│   └── BlazingText (supervised mode)
│
├── Sequence-to-sequence (translation / summarization)?
│   └── Seq2Seq
│
├── Topic modeling?
│   └── LDA or NTM
│
├── Clustering?
│   └── K-Means
│
├── Dimensionality reduction?
│   └── PCA
│
└── Image tasks?
    ├── Classification only → Image Classification
    ├── Locate objects → Object Detection
    └── Pixel mask → Semantic Segmentation
7. 訓練輸入模式
| 模式 | 運作方式 | 最適用途 |
|---|---|---|
| File Mode | 開始前將整個數據集下載至訓練執行個體 | 中小型數據集 |
| Pipe Mode | 訓練期間直接從S3串流數據 | 超大型數據集 — 無磁碟瓶頸 |
| FastFile Mode | 透過FUSE像本地檔案系統般存取S3 | 隨機存取模式 |
考試提示: 當問到「縮短大型數據集的訓練時間」時,答案通常是切換至Pipe Mode和RecordIO格式。Pipe Mode不需要下載整個數據集,直接從S3串流。
8. 速查表 — 快速參考
| 問題關鍵字 | 演算法 |
|---|---|
| 「表格數據」「結構化數據」 | XGBoost |
| 「時間序列」「預測」 | DeepAR |
| 「異常檢測」 | Random Cut Forest |
| 「推薦」「稀疏特徵」 | Factorization Machines |
| 「文本分類」「情感分析」 | BlazingText(監督式模式) |
| 「詞嵌入」 | BlazingText(Word2Vec模式) |
| 「翻譯」「摘要」 | Seq2Seq |
| 「主題建模」 | LDA或NTM |
| 「分群」「區隔」 | K-Means |
| 「維度縮減」 | PCA |
| 「邊界框」「物體檢測」 | Object Detection |
| 「像素級」「分割遮罩」 | Semantic Segmentation |
| 「IP位址異常」「異常登入」 | IP Insights |
9. 練習題
Q1: 一家零售企業想要預測5,000個產品類別未來30天的需求。最佳的SageMaker演算法是哪個?
- A) K-Means
- B) Linear Learner
- C) DeepAR ✓
- D) Seq2Seq
解析:DeepAR專門設計用於跨多個相關時間序列的預測。它同時從所有5,000個序列學習全域模式,並提供機率預測。
Q2: IoT系統監控伺服器CPU使用率。團隊想要自動檢測異常峰值。應該使用哪個SageMaker內建演算法?
- A) XGBoost
- B) Random Cut Forest ✓
- C) BlazingText
- D) PCA
解析:Random Cut Forest(RCF)是SageMaker的內建異常檢測演算法。它為每個數據點分配異常分數,適合檢測CPU使用率峰值等時間序列異常。
Q3: 數據科學家正在使用500GB的數據集訓練模型。數據下載至訓練執行個體的時間過長,導致訓練非常緩慢。哪項變更最能改善效能?
- A) 從CSV切換為JSON格式
- B) 增加訓練執行個體大小
- C) 切換至Pipe Mode和RecordIO-protobuf格式 ✓
- D) 增加訓練epoch數
解析:Pipe Mode在訓練期間直接從S3串流數據,無需預下載,消除了大型數據集的I/O瓶頸。搭配RecordIO-protobuf格式可大幅縮短啟動時間。