SageMaker Training JobsとHPO:分散訓練、Spot Instances、HPO戦略
1. SageMaker Training Jobs
SageMaker Training Jobsはマネージドコンピュートインフラストラクチャ上でML訓練コードを実行します。訓練はエフェメラルインスタンス上で行われ、実行時間のみ課金されます。
Training Job Lifecycle:

  Submit Job ──→ Provision Instances ──→ Download Data
                                              ↓
                                       Run Training Code
                                              ↓
                                       Save Model to S3
                                              ↓
                                       Terminate Instances
2. 訓練用インスタンスタイプ
| インスタンスファミリー | ハードウェア | 最適な用途 |
|---|---|---|
| ml.c5 | CPU最適化 | テーブルML、XGBoost、sklearn |
| ml.m5 | 汎用CPU | 軽量訓練、データ処理 |
| ml.p3 | V100 GPU | ディープラーニング訓練 |
| ml.p4d | A100 GPU(8基) | 大規模DL、分散訓練 |
| ml.g4dn | T4 GPU(コスト効率) | 小〜中規模DLモデル |
| ml.trn1 | AWS Trainium | LLM訓練、コスト最適化 |
3. 分散訓練
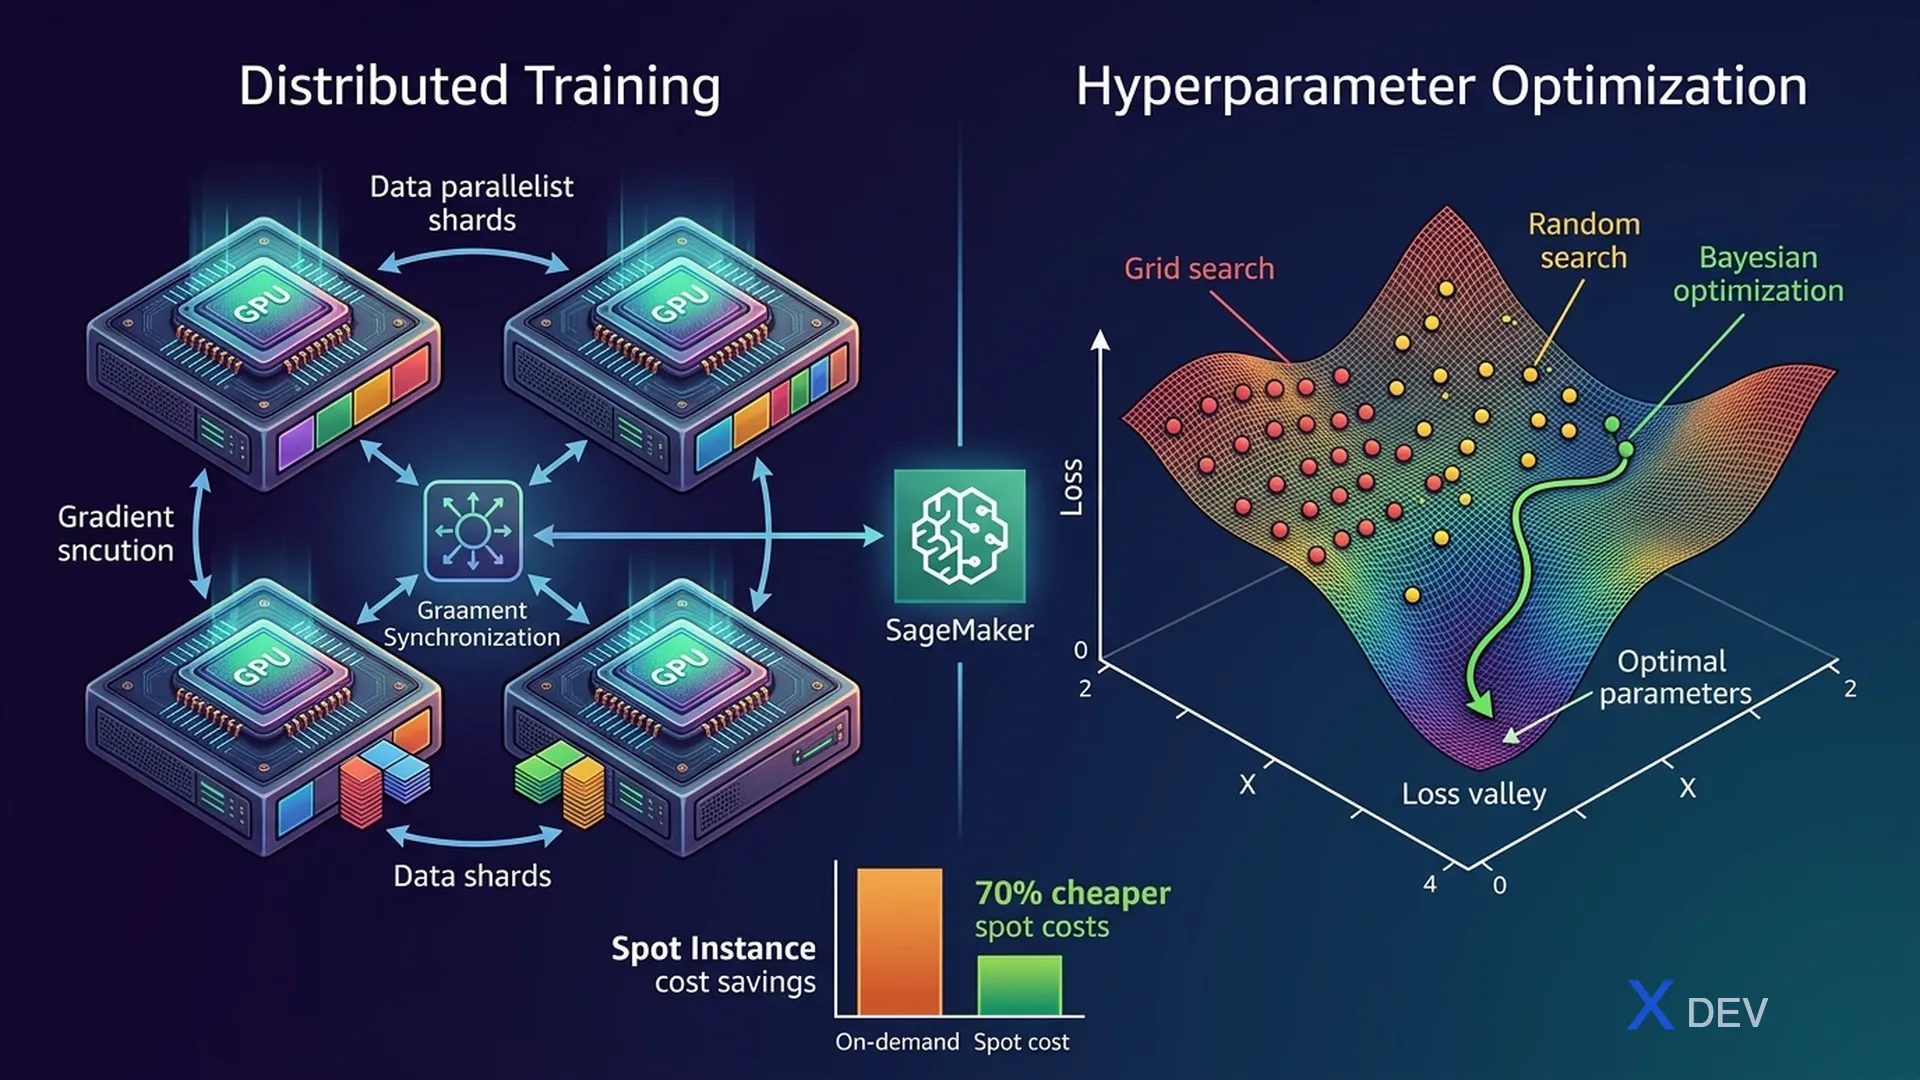
モデルまたはデータセットが1つのインスタンスに収まらない場合、複数インスタンスでの分散訓練が必要です。
| 戦略 | 仕組み | 使用場面 |
|---|---|---|
| データ並列 | 各インスタンスにモデルのコピーがあり、データのサブセットで訓練、勾配を同期 | データセットが大きすぎるが、モデルは1つのGPUに収まる場合 |
| モデル並列 | モデルをインスタンス間で分割、各インスタンスが一部を保持 | モデルが1つのGPUに収まらない場合(LLM) |
Data Parallelism:

Instance 1 [Full Model] ──→ Train on data shard A ──→ ↓
Instance 2 [Full Model] ──→ Train on data shard B ──→ ↓  AllReduce
Instance 3 [Full Model] ──→ Train on data shard C ──→ ↓  (sync gradients)
                                                          ↓
                                              Updated Model Weights

Model Parallelism:

Instance 1 [Layers 1-4]  ──→ forward pass ──→
Instance 2 [Layers 5-8]  ──→ forward pass ──→
Instance 3 [Layers 9-12] ──→ forward pass ──→ output
試験のヒント: SageMakerはSageMaker Distributedライブラリを2つのモジュールで提供:(1)
smdistributed.dataparallel— 最適化されたAllReduce;(2)smdistributed.modelparallel— 自動パイプライン並列。「大規模モデル訓練」→ モデル並列。
4. 自動モデルチューニング(HPO)
ハイパーパラメータ最適化(HPO)は異なる設定で複数の訓練ジョブを実行し、最適なハイパーパラメータを自動的に見つけます。
| 戦略 | 仕組み | トレードオフ |
|---|---|---|
| ランダムサーチ | 範囲からハイパーパラメータをランダムにサンプリング | 高速、良いベースライン |
| グリッドサーチ | すべての組み合わせを試行 | 網羅的、高コスト、大きな探索空間には不向き |
| ベイズ最適化 | 結果の確率モデル、次の最適な設定を提案 | 効率的、過去の試行から学習 — SageMakerのデフォルト |
| Hyperband | パフォーマンスの低い試行を早期停止 | リソース効率が良い、高速 |
試験のヒント: SageMaker AMT(Automatic Model Tuning)はデフォルトでベイズ最適化を使用します。前回のジョブの結果を参照して次のハイパーパラメータセットを提案します — ブルートフォースではなくインテリジェントな探索です。
5. Spot Instance Training
SageMakerは訓練ジョブにEC2 Spot Instancesの使用をサポートし、オンデマンドと比較して最大90%のコスト削減を実現します。
| 機能 | 詳細 |
|---|---|
| MaxWaitTimeInSeconds | Spotキャパシティを待つ最大時間 |
| チェックポイント | 定期的にモデルをS3に保存 — 中断後に再開 |
| use_spot_instances=True | SageMaker Estimatorのパラメータ |
試験のヒント: 「訓練コストを削減する」と問われた場合、正解は通常チェックポイント付きSpot Instancesです。チェックポイントはSpotインスタンスが終了された場合の進捗損失を防ぐために重要です。
6. バイアス-バリアンストレードオフ
| 問題 | 症状 | 原因 | 解決策 |
|---|---|---|---|
| 高バイアス(未学習) | 訓練誤差が高い、テスト誤差も高い | モデルが単純すぎる | モデル複雑性の増加、特徴量追加、正則化の減少 |
| 高バリアンス(過学習) | 訓練誤差が低い、テスト誤差が高い | モデルが複雑すぎる | データ追加、ドロップアウト、正則化、特徴量選択 |
| バランス良好 | 訓練誤差が低い、テスト誤差も低い(近い値) | 良いフィット | モデルをデプロイ |
7. 練習問題
Q1: ある企業が1つのGPUインスタンスに収まらない大規模ディープラーニングモデルを訓練しています。どのSageMaker分散訓練戦略を使用すべきですか?
- A) データ並列
- B) モデル並列 ✓
- C) パイプライン並列のみ
- D) バッチサイズの増加
解説:モデル並列はモデル自体を複数のGPUインスタンスに分割し、1つのGPUのメモリに収まらないモデルの訓練を可能にします。データ並列は各インスタンスに完全なモデルコピーを保持するため、モデル自体が大きすぎる場合は役に立ちません。
Q2: チームが500のハイパーパラメータチューニングジョブの実行コストを最小化したいと考えています。訓練は中断を許容できます。最もコスト効率の良いアプローチはどれですか?
- A) より大きなインスタンスでジョブを高速に実行
- B) チェックポイント有効化のSpot Instances ✓
- C) ベイズ最適化の代わりにグリッドサーチを使用
- D) エポック数を削減
解説:Spot Instancesはオンデマンド価格と比較して最大90%のコスト削減を実現できます。チェックポイントを有効にすると、中断されたジョブがS3に状態を保存し再開できるため、長時間のHPOジョブにSpot Instancesが実用的になります。
Q3: モデルが訓練データで95%のaccuracyを達成しましたが、テストセットでは62%です。これはどのような問題を示していますか?
- A) 未学習 / 高バイアス
- B) 過学習 / 高バリアンス ✓
- C) データリーケージ
- D) クラス不均衡
解説:訓練accuracy(95%)とテストaccuracy(62%)の大きなギャップは過学習(高バリアンス)の典型的な兆候です。モデルが訓練データを暗記したが汎化に失敗しています。解決策:データ追加、正則化(L1/L2、ドロップアウト)、モデル複雑性の削減。