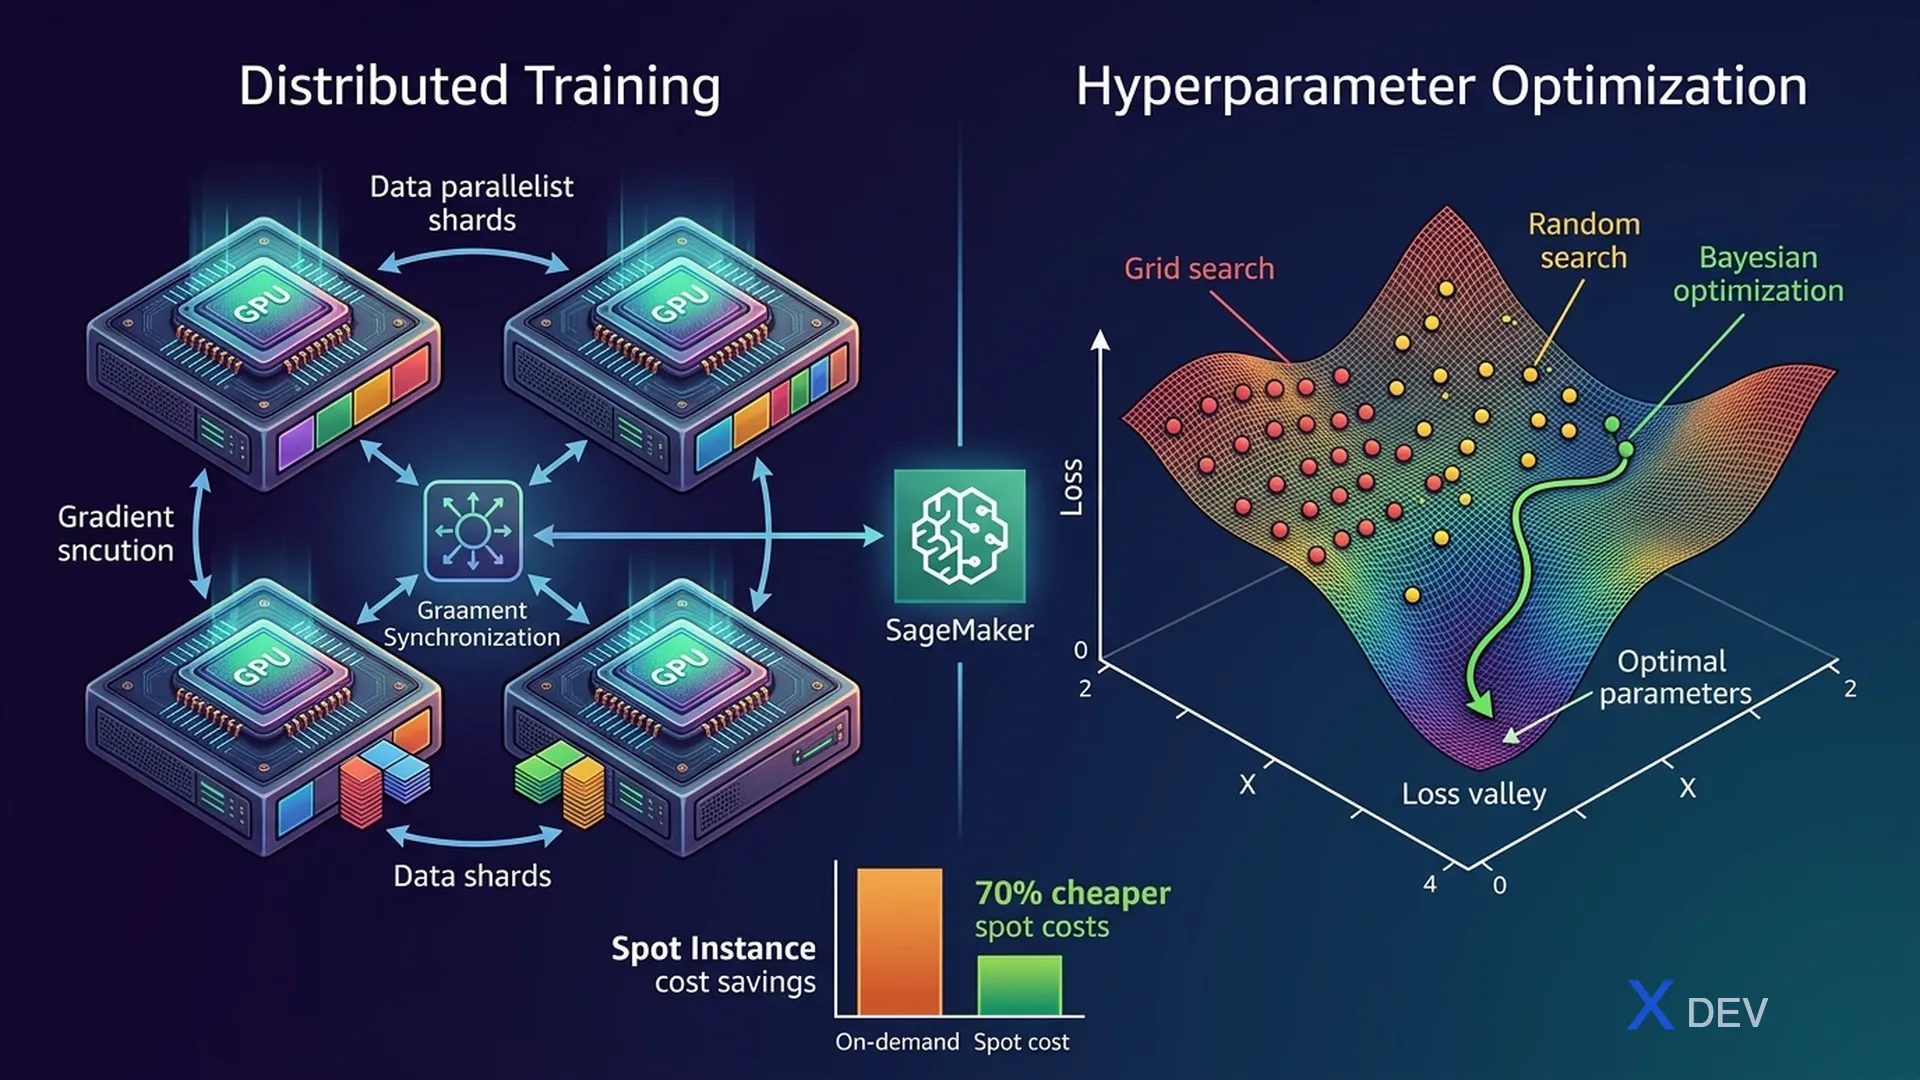
SageMaker Training Jobs與超參數調校:分散式訓練、Spot Instances、HPO策略
1. SageMaker Training Jobs
SageMaker Training Jobs在託管運算基礎設施上執行ML訓練程式碼。訓練在臨時執行個體上進行 — 僅在執行時計費。
Training Job Lifecycle:

  Submit Job ──→ Provision Instances ──→ Download Data
                                              ↓
                                       Run Training Code
                                              ↓
                                       Save Model to S3
                                              ↓
                                       Terminate Instances
2. 訓練用執行個體類型
| 執行個體系列 | 硬體 | 最適用途 |
|---|---|---|
| ml.c5 | CPU最佳化 | 表格ML、XGBoost、sklearn |
| ml.m5 | 通用CPU | 輕量訓練、數據處理 |
| ml.p3 | V100 GPU | 深度學習訓練 |
| ml.p4d | A100 GPU(8x) | 大規模DL、分散式訓練 |
| ml.g4dn | T4 GPU(高性價比) | 中小型DL模型 |
| ml.trn1 | AWS Trainium | LLM訓練、成本最佳化 |
3. 分散式訓練
當模型或數據集太大無法在單一執行個體上處理時,需要跨多個執行個體進行分散式訓練。
| 策略 | 運作方式 | 使用時機 |
|---|---|---|
| 數據並行 | 每個執行個體有完整模型副本,在數據子集上訓練,同步梯度 | 數據集太大,模型可裝入1個GPU |
| 模型並行 | 模型拆分到多個執行個體,每個執行個體包含一部分 | 模型太大無法裝入1個GPU(LLMs) |
Data Parallelism:

Instance 1 [Full Model] ──→ Train on data shard A ──→ ↓
Instance 2 [Full Model] ──→ Train on data shard B ──→ ↓  AllReduce
Instance 3 [Full Model] ──→ Train on data shard C ──→ ↓  (sync gradients)
                                                          ↓
                                              Updated Model Weights

Model Parallelism:

Instance 1 [Layers 1-4]  ──→ forward pass ──→
Instance 2 [Layers 5-8]  ──→ forward pass ──→
Instance 3 [Layers 9-12] ──→ forward pass ──→ output
考試提示: SageMaker提供SageMaker Distributed函式庫,包含2個模組:(1)
smdistributed.dataparallel— 最佳化的AllReduce;(2)smdistributed.modelparallel— 自動管線並行。當題目問「大型模型訓練」→ 模型並行。
4. 自動模型調校(HPO)
超參數最佳化(HPO)通過執行多個不同配置的訓練工作,自動找出最佳超參數。
| 策略 | 運作方式 | 取捨 |
|---|---|---|
| 隨機搜尋 | 從範圍中隨機取樣超參數 | 快速、良好的基準線 |
| 網格搜尋 | 嘗試所有組合 | 窮舉、昂貴、不適合大搜尋空間 |
| 貝葉斯最佳化 | 結果的機率模型,建議最佳下一個配置 | 高效、從先前試驗中學習 — SageMaker預設 |
| Hyperband | 提前停止表現不佳的試驗 | 資源高效、快速 |
考試提示: SageMaker AMT(自動模型調校)預設使用貝葉斯最佳化。它會參考先前工作的結果來建議下一組超參數 — 智慧搜尋,而非暴力法。
5. Spot Instance訓練
SageMaker支援使用EC2 Spot Instances進行訓練工作,與隨需相比可節省高達90%的成本。
| 功能 | 詳情 |
|---|---|
| MaxWaitTimeInSeconds | 等待Spot容量的最長時間 |
| 檢查點 | 定期將模型儲存至S3 — 中斷後可恢復 |
| use_spot_instances=True | SageMaker Estimator中的參數 |
考試提示: 當題目問「降低訓練成本」時,答案通常是Spot Instances搭配檢查點。檢查點非常重要,可避免Spot Instance被終止時遺失進度。
6. 偏差-變異數取捨
| 問題 | 症狀 | 原因 | 解決方案 |
|---|---|---|---|
| 高偏差(欠擬合) | 訓練誤差高、測試誤差高 | 模型太簡單 | 增加模型複雜度、增加特徵、減少正規化 |
| 高變異數(過擬合) | 訓練誤差低、測試誤差高 | 模型太複雜 | 增加數據、dropout、正規化、特徵選擇 |
| 平衡 | 訓練誤差低、測試誤差低(接近) | 良好擬合 | 部署模型 |
7. 練習題
Q1: 一家公司正在訓練一個無法裝入單一GPU執行個體的大型深度學習模型。應該使用哪種SageMaker分散式訓練策略?
- A) 數據並行
- B) 模型並行 ✓
- C) 僅管線並行
- D) 增加批次大小
解析:模型並行將模型本身拆分到多個GPU執行個體上,允許訓練無法裝入單一GPU記憶體的模型。數據並行在每個執行個體上保留完整的模型副本,當模型本身太大時無法解決問題。
Q2: 團隊想要將執行500個超參數調校工作的成本降至最低。訓練可以容忍中斷。最具成本效益的方法是什麼?
- A) 使用更大的執行個體來加快工作速度
- B) 使用Spot Instances並啟用檢查點 ✓
- C) 使用網格搜尋代替貝葉斯最佳化
- D) 減少訓練epoch數
解析:Spot Instances與隨需定價相比可節省高達90%。啟用檢查點後,被中斷的工作會將狀態儲存至S3並可恢復,使Spot Instances適用於長時間的HPO工作。
Q3: 一個模型在訓練數據上達到95%的accuracy,但在測試集上只有62%。這表明什麼問題?
- A) 欠擬合 / 高偏差
- B) 過擬合 / 高變異數 ✓
- C) 數據洩漏
- D) 類別不平衡
解析:訓練accuracy(95%)和測試accuracy(62%)之間的巨大差距是過擬合(高變異數)的典型徵兆。模型記住了訓練數據但無法泛化。解決方案:更多數據、正規化(L1/L2、dropout)、降低模型複雜度。