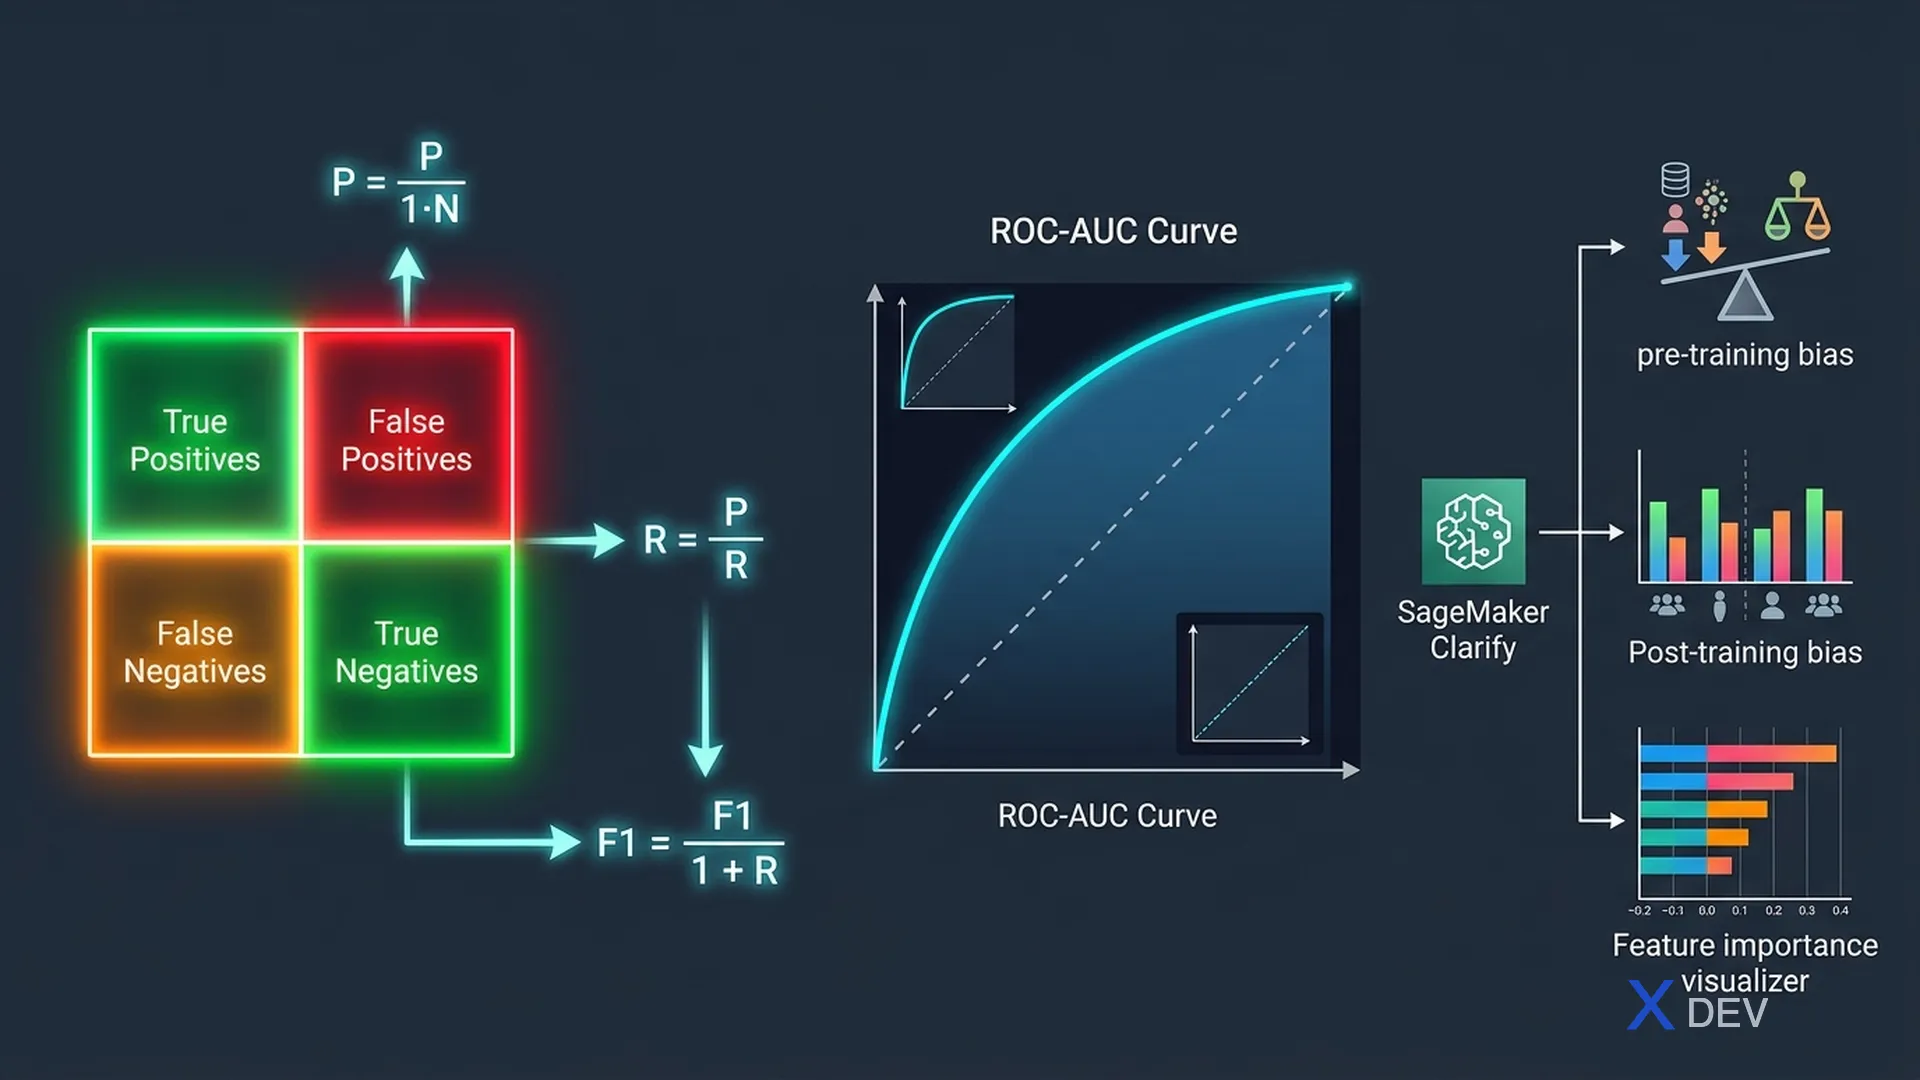
モデル評価:分類指標(AUC-ROC、F1)、回帰指標(RMSE、MAE)、混同行列
1. 分類指標
適切な指標を選択することはMLエンジニアの最も重要なスキルの1つです。MLS-C01試験ではシナリオが提示され、適切な指標が問われます。
1.1. 混同行列
                 Predicted
                 Positive  Negative
Actual Positive │   TP   │   FN   │  ← Recall = TP / (TP + FN)
       Negative │   FP   │   TN   │

Precision  = TP / (TP + FP)   ← 予測Positiveのうち正解の割合
Recall     = TP / (TP + FN)   ← 実際のPositiveのうち捕捉できた割合
F1 Score   = 2 × (P × R) / (P + R)   ← 調和平均
Accuracy   = (TP + TN) / Total
| 指標 | 最適化する場面 | 実世界の例 |
|---|---|---|
| Precision | FPのコストが高い — 誤検知を避けたい | スパムフィルター(正当なメールをブロックしない) |
| Recall(感度) | FNのコストが高い — 陽性を見逃したくない | がん検出(すべてのがん患者を発見) |
| F1スコア | PrecisionとRecallのバランス、不均衡データ | 不正検知 |
| Accuracy | 均衡クラスのみ | 多クラス、均衡データセット |
| AUC-ROC | ランキング品質、閾値に依存しない | 信用スコアリング、広告ランキング |
| PR-AUC | 不均衡、少数クラスに注目 | 不正検知、医療診断 |
試験のヒント: よくあるシナリオ — 「医療診断で、がんを見逃す方が偽陽性より危険」→ Recallを最適化。「スパム検出で、正当なメールのブロックが問題」→ Precisionを最適化。不均衡データ → F1またはAUC-ROCを使用、Accuracyは使わない。
2. 回帰指標
| 指標 | 式 | 外れ値への感度 | ユースケース |
|---|---|---|---|
| RMSE | √(mean(errors²)) | 高 — 大きな誤差をペナルティ | 大きな誤差が許容できない場合(価格予測) |
| MAE | mean(|errors|) | 低 — すべての誤差を均等に | 外れ値にロバスト、需要予測 |
| R²(決定係数) | 1 - SS_res/SS_tot | 中 | 説明された分散の割合(0〜1) |
| MAPE | mean(|error/actual|×100) | 実測値が0に近い場合高い | パーセンテージ誤差、ビジネス解釈が容易 |
3. 交差検証
| 戦略 | 仕組み | 最適な用途 |
|---|---|---|
| ホールドアウト分割 | 訓練/検証/テスト分割(例:70/15/15) | 大規模データセット、高速評価 |
| K分割交差検証 | K個のサブセット、K-1で訓練、1で評価、K回繰り返し | 中規模データセット、ロバストな推定 |
| 層化K分割 | K分割と同じだが各フォールドでクラス比率を維持 | 不均衡な分類 |
| Leave-One-Out (LOOCV) | N分割(各サンプルが1回テスト) | 非常に小さいデータセット |
| 時系列分割 | 訓練ウィンドウが前方に成長 — 訓練に将来データなし | 時系列データ |
試験のヒント: 時系列データは必ず時間ベースの分割を使用し、シャッフルしてから通常のK分割を使用してはいけません — 将来のデータが訓練にリークします。
4. SageMaker Clarify — バイアスと説明可能性
SageMaker Clarifyはデータ/モデルのバイアスを検出し、SHAP値を使用したモデルの説明可能性を提供します。
| 機能 | 動作 | 出力 |
|---|---|---|
| 訓練前バイアス検出 | 訓練前の生データを分析 | バイアス指標:CI、DPL、KL、JS |
| 訓練後バイアス検出 | モデル予測のバイアスを評価 | 指標:DPPL、DI、DCO、RD |
| モデル説明可能性 | 特徴量の重要度のSHAP値 | 予測ごとの特徴量重み寄与 |
SHAP Explainability Example (Loan Approval):

Feature            SHAP Value  Contribution
─────────────────────────────────────────────
credit_score       +0.42       ↑ approval
income             +0.28       ↑ approval
debt_ratio         -0.35       ↓ approval
employment_years   +0.15       ↑ approval
age                -0.02       minimal impact
5. Production VariantsによるA/Bテスト
SageMaker EndpointsはProduction Variantsをサポート — トラフィック分割による複数モデルバージョンの同時実行。
Endpoint with A/B Testing:

          ┌──────────────────────────────┐
 Request ─→  SageMaker Endpoint         │
          │                              │
          │  Variant A (v1): 80% traffic │──→ Model v1 (current)
          │  Variant B (v2): 20% traffic │──→ Model v2 (candidate)
          └──────────────────────────────┘
                        ↓
                 Compare metrics, shift traffic gradually
6. チートシート — 評価指標
| シナリオ | 最適な指標 |
|---|---|
| 医療診断(FNが致命的) | Recall(感度) |
| スパムフィルター(FPが致命的) | Precision |
| 不均衡な不正検知 | F1スコア、AUC-ROC |
| 住宅価格予測(外れ値が重要) | RMSE |
| 需要予測(ロバスト) | MAE |
| 個別予測の説明 | SHAP(SageMaker Clarify経由) |
7. 練習問題
Q1: ある病院が早期がん検出モデルを構築したいと考えています。実際のがん症例を見逃すことは偽陽性よりも危険です。どの指標を最適化すべきですか?
- A) Precision
- B) Recall ✓
- C) Accuracy
- D) RMSE
解説:Recall = TP / (TP + FN)。Recallを最適化すると偽陰性(見逃されたがん症例)が最小化されます。PrecisionはFPを最適化、Accuracyは不均衡な医療データでは誤解を招き、RMSEは回帰用です。
Q2: ある企業が既存モデルをフォールバックとして維持しながら、本番で新しいモデルバージョンを段階的にテストしたいと考えています。これを実現するSageMaker機能はどれですか?
- A) SageMaker Experiments
- B) SageMaker Pipelines
- C) SageMaker Endpointsの Production Variants ✓
- D) SageMaker Model Monitor
解説:SageMaker EndpointsはProduction Variantsをサポートし、設定可能なトラフィックウェイトで複数のモデルバージョンを同時に実行できます。ダウンタイムなしのA/Bテストとカナリアデプロイメントを実現します。
Q3: 住宅価格予測モデルのRMSE=50,000、MAE=20,000です。これは何を示していますか?
- A) 高バイアス
- B) データリーケージ
- C) 外れ値がRMSEを押し上げている ✓
- D) 未学習
解説:RMSEがMAEより大幅に高い場合、外れ値の存在を示します。RMSEは誤差を二乗するため、大きな誤差をMAEよりもはるかに重くペナルティします。このギャップ(50k対20k)は一部の予測に非常に大きな誤差があることを示唆しています。