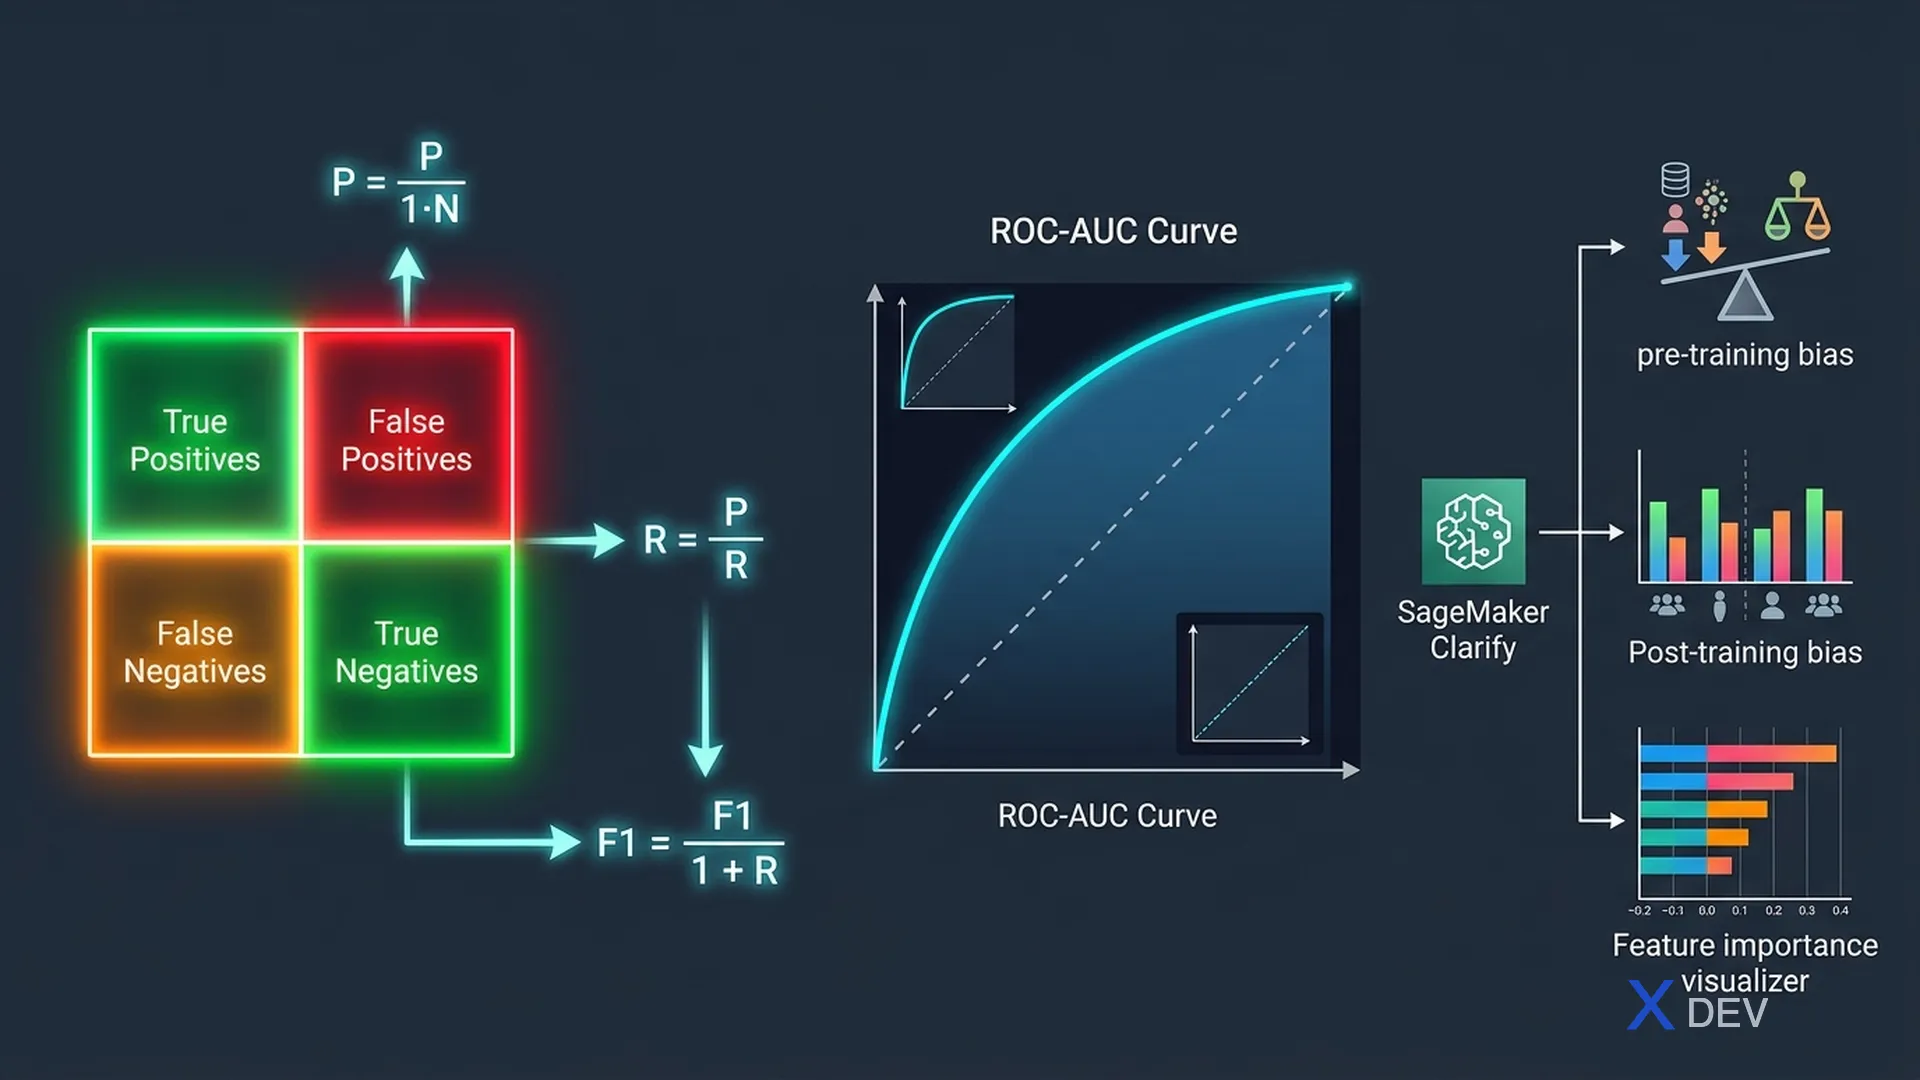
模型評估:分類指標(AUC-ROC、F1)、迴歸指標(RMSE、MAE)與混淆矩陣
1. 分類指標
選擇正確的指標是ML工程師最重要的技能之一。MLS-C01考試經常給出情境並詢問適當的指標。
1.1. 混淆矩陣
                 Predicted
                 Positive  Negative
Actual Positive │   TP   │   FN   │  ← Recall = TP / (TP + FN)
       Negative │   FP   │   TN   │

Precision  = TP / (TP + FP)   ← 在所有預測為正的中,有多少是正確的?
Recall     = TP / (TP + FN)   ← 在所有實際為正的中,我們捕獲了多少?
F1 Score   = 2 × (P × R) / (P + R)   ← 調和平均數
Accuracy   = (TP + TN) / Total
| 指標 | 最佳化時機 | 實際案例 |
|---|---|---|
| Precision | FP成本高 — 不想要假警報 | 垃圾郵件過濾器(不要攔截正常郵件) |
| Recall(靈敏度) | FN成本高 — 不能遺漏正例 | 癌症檢測(找出所有癌症患者) |
| F1分數 | 平衡Precision和Recall,不平衡數據 | 欺詐檢測 |
| Accuracy | 僅適用於平衡類別 | 多類別、平衡數據集 |
| AUC-ROC | 排序品質、與閾值無關 | 信用評分、廣告排序 |
| PR-AUC | 不平衡、關注少數類別 | 欺詐、醫療診斷 |
考試提示: 常見情境 — 「醫療診斷,遺漏癌症比假陽性更嚴重」→ 最佳化Recall。「垃圾郵件偵測器,攔截正常郵件不好」→ 最佳化Precision。不平衡數據 → 使用F1或AUC-ROC,不要使用Accuracy。
2. 迴歸指標
| 指標 | 公式 | 離群值敏感度 | 使用情境 |
|---|---|---|---|
| RMSE | √(mean(errors²)) | 高 — 懲罰大誤差 | 大誤差不可接受時(價格預測) |
| MAE | mean(|errors|) | 低 — 所有誤差權重相等 | 對離群值穩健、需求預測 |
| R²(決定係數) | 1 - SS_res/SS_tot | 中等 | 解釋的變異數比例(0–1) |
| MAPE | mean(|error/actual|×100) | 當實際值接近0時高 | 百分比誤差、易於商業解讀 |
3. 交叉驗證
| 策略 | 運作方式 | 最適用途 |
|---|---|---|
| 留出法分割 | 訓練/驗證/測試分割(例如70/15/15) | 大型數據集、快速評估 |
| K折交叉驗證 | K個子集,在K-1上訓練,在1上評估,重複K次 | 中型數據集、穩健估計 |
| 分層K折 | 與K折相同但每折維持類別比例 | 不平衡分類 |
| 留一法(LOOCV) | N折(每個樣本作為測試一次) | 非常小的數據集 |
| 時間序列分割 | 訓練窗口向前推進 — 訓練中沒有未來數據 | 時間序列數據 |
考試提示: 時間序列數據必須使用基於時間的分割,不能隨機打亂後使用普通K折 — 會將未來數據洩漏到訓練中。
4. SageMaker Clarify — 偏差與可解釋性
SageMaker Clarify檢測數據/模型中的偏差,並使用SHAP值提供模型可解釋性。
| 功能 | 用途 | 輸出 |
|---|---|---|
| 訓練前偏差檢測 | 訓練前分析原始數據 | 偏差指標:CI、DPL、KL、JS |
| 訓練後偏差檢測 | 評估模型預測是否存在偏差 | 指標:DPPL、DI、DCO、RD |
| 模型可解釋性 | 特徵重要性的SHAP值 | 每個預測的特徵權重貢獻 |
SHAP Explainability Example (Loan Approval):

Feature            SHAP Value  Contribution
─────────────────────────────────────────────
credit_score       +0.42       ↑ approval
income             +0.28       ↑ approval
debt_ratio         -0.35       ↓ approval
employment_years   +0.15       ↑ approval
age                -0.02       minimal impact
5. Production Variants的A/B測試
SageMaker Endpoints支援Production Variants — 同時執行多個模型版本並分配流量。
Endpoint with A/B Testing:

          ┌──────────────────────────────┐
 Request ─→  SageMaker Endpoint         │
          │                              │
          │  Variant A (v1): 80% traffic │──→ Model v1 (current)
          │  Variant B (v2): 20% traffic │──→ Model v2 (candidate)
          └──────────────────────────────┘
                        ↓
                 Compare metrics, shift traffic gradually
6. 速查表 — 評估指標
| 情境 | 最佳指標 |
|---|---|
| 醫療診斷(FN嚴重) | Recall(靈敏度) |
| 垃圾郵件過濾器(FP嚴重) | Precision |
| 不平衡欺詐檢測 | F1分數、AUC-ROC |
| 房價預測(離群值重要) | RMSE |
| 需求預測(穩健) | MAE |
| 解釋個別預測 | SHAP(透過SageMaker Clarify) |
7. 練習題
Q1: 一家醫院想要建構早期癌症檢測模型。遺漏實際癌症病例比假陽性更危險。應該最佳化哪個指標?
- A) Precision
- B) Recall ✓
- C) Accuracy
- D) RMSE
解析:Recall = TP / (TP + FN)。最佳化Recall可最小化假陰性(遺漏的癌症病例),這是此處的關鍵考量。Precision最佳化假陽性,Accuracy對不平衡醫療數據會產生誤導,RMSE用於迴歸。
Q2: 一家公司想在正式環境中逐步測試新模型版本,同時保留現有模型作為後備。哪個SageMaker功能提供此能力?
- A) SageMaker Experiments
- B) SageMaker Pipelines
- C) SageMaker Endpoints上的Production Variants ✓
- D) SageMaker Model Monitor
解析:SageMaker Endpoints支援Production Variants,允許多個模型版本同時執行並配置流量權重。這實現了A/B測試和金絲雀部署,無需停機。
Q3: 一個房價預測模型的RMSE=50,000且MAE=20,000。這表明存在什麼問題?
- A) 高偏差
- B) 數據洩漏
- C) 離群值推高了RMSE ✓
- D) 欠擬合
解析:當RMSE明顯高於MAE時,表示存在離群值 — 因為RMSE對誤差取平方,對大誤差的懲罰遠大於MAE。差距(50k vs 20k)表明某些預測存在非常大的誤差(目標變數中的離群值)。