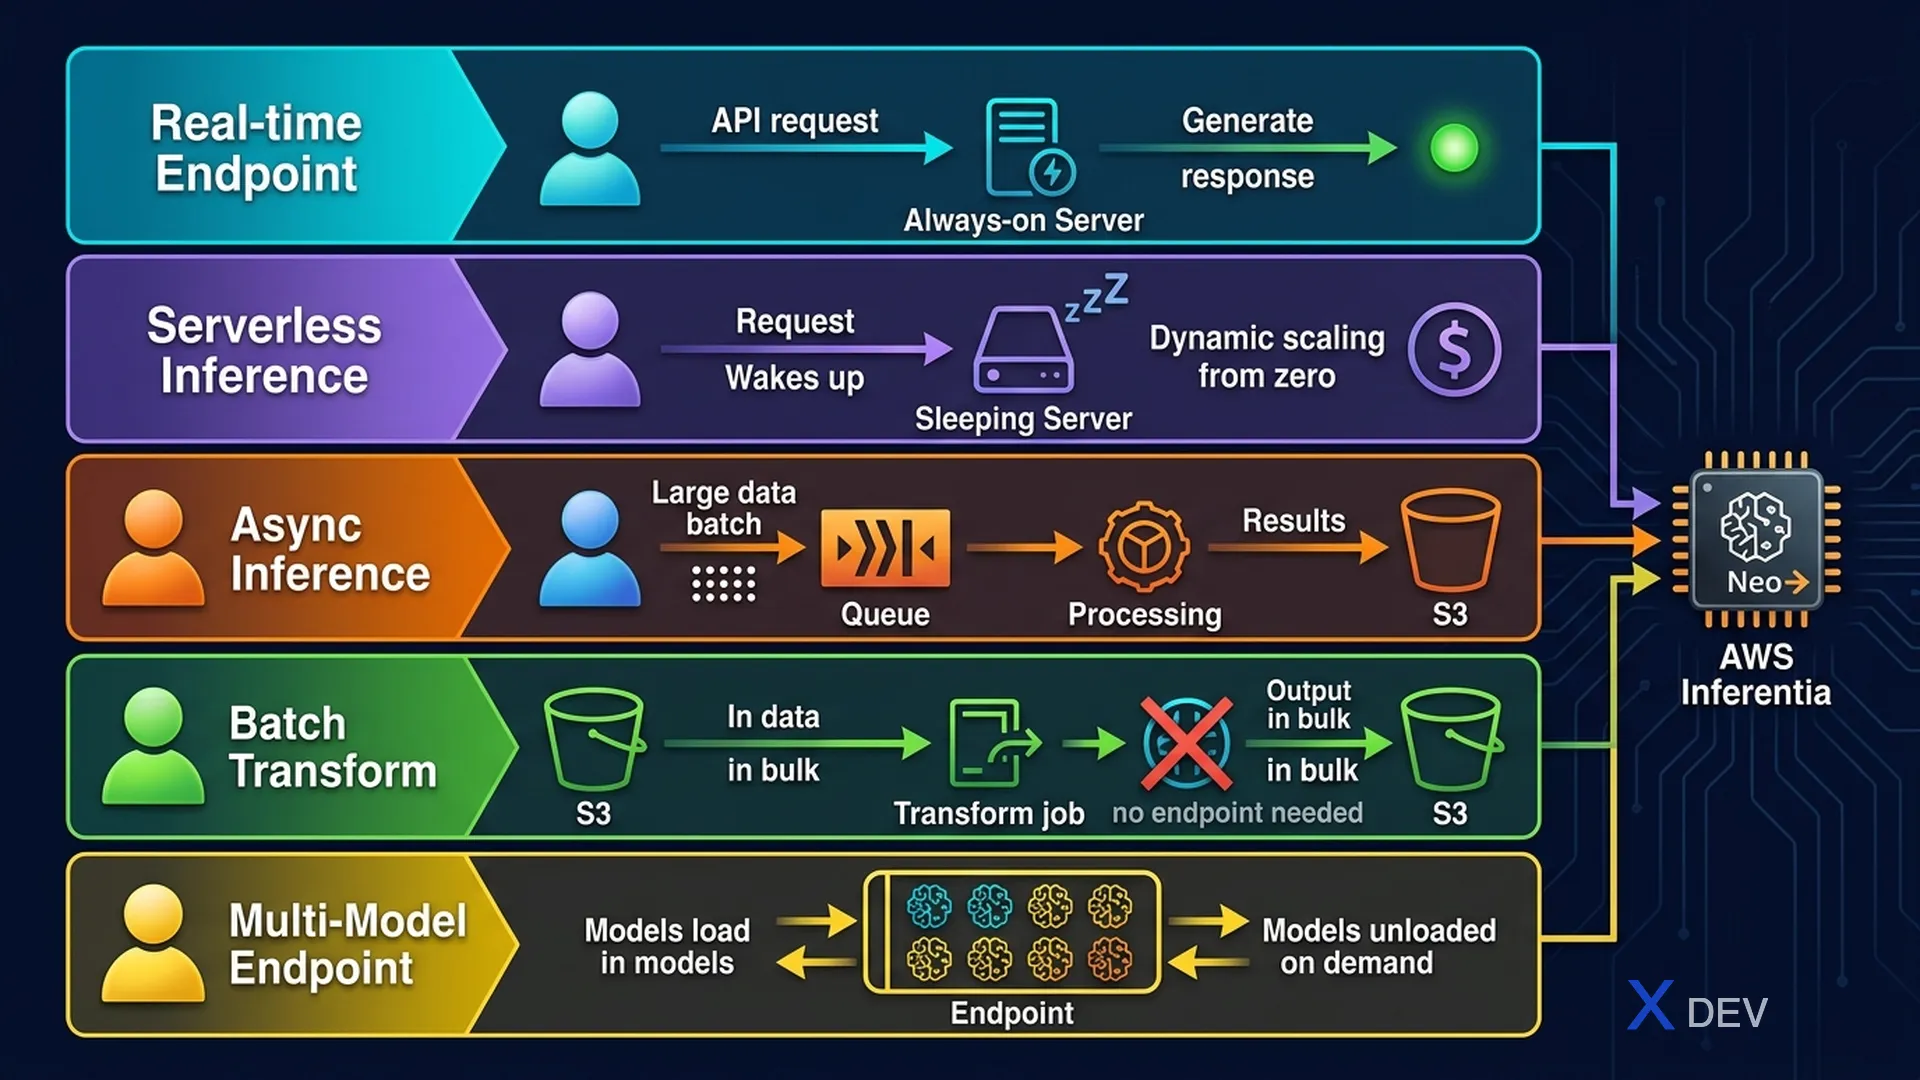
SageMakerデプロイ:リアルタイムエンドポイント、サーバーレス、非同期推論、バッチ変換
1. SageMakerデプロイオプション
SageMakerは複数の推論パターンを提供し、それぞれ異なるワークロードに適しています。MLS-C01試験では通常5〜8問出題されます。
試験のヒント: 主要な判断要素:レイテンシ要件、ボリューム、コスト、ペイロードサイズ。マッピング:リアルタイム(低レイテンシ)→ 非同期(大きなペイロード)→ サーバーレス(散発的)→ バッチ(レイテンシ不要)。
| デプロイタイプ | レイテンシ | スループット | コストモデル | 最適な用途 |
|---|---|---|---|---|
| リアルタイムエンドポイント | ミリ秒 | 高 | 常時稼働(時間課金) | インタラクティブアプリ、API |
| サーバーレス推論 | 秒(コールドスタート) | 可変 | 呼び出し課金 | 散発的、予測不可能なトラフィック |
| 非同期推論 | 分 | 高(キュー) | 処理課金 | 大きなペイロード、非緊急 |
| バッチ変換 | リアルタイムなし | 非常に高 | バッチジョブ課金 | スケジュールされたオフライン予測 |
2. リアルタイム推論
標準的なデプロイ — 永続エンドポイントが常時稼働し、同期的に応答します。
Real-time Endpoint Architecture:

Client ──→ HTTPS Request
              ↓
      SageMaker Endpoint
      ┌────────────────┐
      │  Model Server  │  ← Instance running 24/7
      │  (TorchServe,  │
      │  TensorFlow    │
      │  Serving, etc) │
      └────────────────┘
              ↓
         Response (ms)
2.1. エンドポイントのオートスケーリング
エンドポイントはApplication Auto Scalingを通じてInvocationsPerInstanceメトリクスに基づいてスケールできます。
3. サーバーレス推論
トラフィックが不均一で予測困難な場合に適しています。AWSが自動スケールし、トラフィックがない場合は0までスケールダウンします。
| 機能 | 詳細 |
|---|---|
| コールドスタートレイテンシ | 約1〜2秒(アイドル期間後の最初) |
| メモリ設定 | 1 GB → 6 GB |
| 最大ペイロード | 4 MB |
| 料金 | 推論リクエスト + 処理時間あたり |
4. 非同期推論
大きなメディアファイル、長い処理時間に適しています。リクエストはキューに入り、レスポンスはS3に保存されます。
Async Inference Flow:

Client ──→ Upload payload to S3 ──→ Invoke Endpoint
                                          ↓
                                   Queue Request
                                          ↓
                               Process when instance available
                                          ↓
                                   Save output to S3
                                          ↓
                           SNS Notification → Client
| 機能 | 詳細 |
|---|---|
| 最大ペイロード | 1 GB(リアルタイムの6 MBに対して) |
| 0までスケールダウン | 可 — キューが空の場合スケールダウン |
| レスポンス | S3出力パス + SNS通知 |
5. バッチ変換
データセット全体に対してスケジュールに従い予測を実行します。エンドポイントなし — 必要な時のみ実行。
Batch Transform:

Input S3 ──→ Batch Transform Job ──→ Output S3
  (CSV/       (ephemeral compute)      (CSV/JSON
  JSON/                                predictions)
  Parquet)           ↑
               No persistent endpoint
               Pay only when running
6. マルチモデルエンドポイント(MME)
MMEは1つのエンドポイントで複数のモデルをホストし、推論インフラストラクチャのコストを削減します。
| 機能 | 詳細 |
|---|---|
| コスト削減 | 1つのエンドポイントで数千のモデルに対応 |
| 動的ロード | モデルはオンデマンドでメモリにロード、キャッシュ |
| ユースケース | 顧客ごとのモデルを持つSaaSマルチテナント |
7. SageMaker Neo — エッジデプロイ
SageMaker Neoはモデルをコンパイルし、特定のハードウェア(エッジデバイス、モバイル)向けに最適化します。
Neo Workflow:

Trained Model (S3)
       ↓
  Neo Compiler
  (optimizes for target hardware)
       ↓
 Optimized Model
       ↓
    ├── Deploy to IoT Greengrass (edge)
    ├── Deploy to ARM devices
    └── Deploy to mobile (Android/iOS)
8. チートシート — デプロイ判断
| シナリオ | デプロイタイプ |
|---|---|
| モバイルアプリ、リアルタイム応答(100ms未満) | リアルタイムエンドポイント |
| トラフィックが散発的(数リクエスト/時間) | サーバーレス推論 |
| 動画/音声処理(大きなファイル) | 非同期推論 |
| 毎晩のデータセット全体への予測 | バッチ変換 |
| 顧客固有の数千のモデル | マルチモデルエンドポイント |
| IoTエッジデバイスデプロイ | SageMaker Neo + Greengrass |
9. 練習問題
Q1: ある企業がピークショッピング時に100ms未満の応答時間を要求するeコマースチャットボットを運用しています。どのSageMaker推論タイプを使用すべきですか?
- A) バッチ変換
- B) 非同期推論
- C) サーバーレス推論
- D) リアルタイムエンドポイント ✓
解説:リアルタイムエンドポイントはミリ秒レイテンシの永続的な常時稼働推論を提供します。サーバーレスはコールドスタート遅延があり、非同期は非同期(100ms未満ではない)、バッチ変換はスケジュールされたオフライン処理用です。
Q2: メディア企業が1GBの動画ファイルにML分類を実行したいと考えています。処理時間は緊急ではありません。最も適切なSageMaker推論オプションはどれですか?
- A) リアルタイムエンドポイント
- B) サーバーレス推論
- C) 非同期推論 ✓
- D) バッチ変換
解説:非同期推論は最大1GBのペイロードをサポートし、リクエストをキューに入れて処理するため、大きなメディアファイルに最適です。リアルタイムは6MBペイロード制限、サーバーレスは4MB制限です。
Q3: あるSaaS企業が10,000のエンタープライズ顧客それぞれに個別のMLモデルを提供しています。各モデルを別々のエンドポイントでホストするとコストが高すぎます。最善の解決策はどれですか?
- A) すべてのモデルを1つの大きなモデルに統合
- B) SageMakerマルチモデルエンドポイントを使用 ✓
- C) 単一のバッチ変換ジョブですべてのモデルをデプロイ
- D) 各モデルにサーバーレス推論を使用
解説:マルチモデルエンドポイント(MME)は単一のエンドポイントで複数のモデルをホストし、オンデマンドで動的にメモリにロードします。各顧客が独自のモデルを持つマルチテナントシナリオ向けに設計されています。