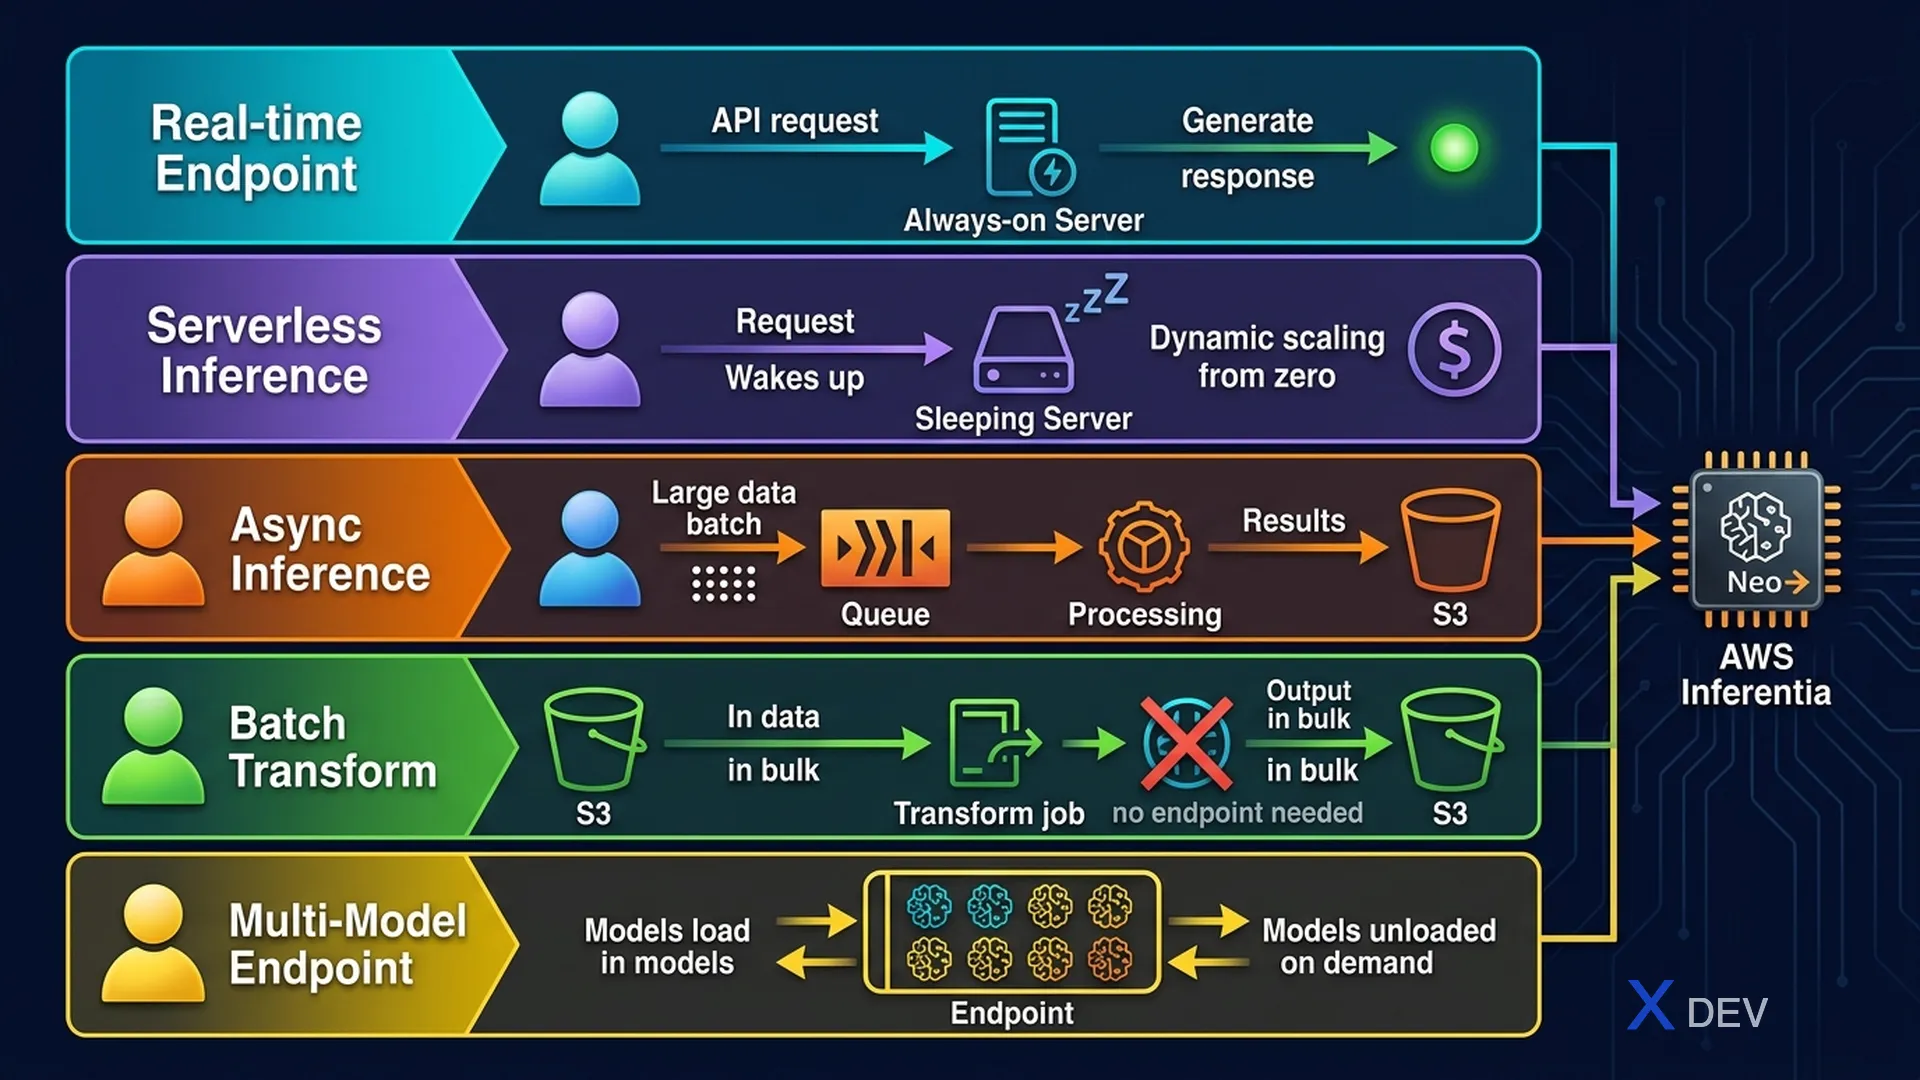
SageMaker部署選項:即時端點、無伺服器、非同步推論與批次轉換
1. SageMaker部署選項
SageMaker提供多種推論模式 — 每種適合不同的工作負載。此部分在MLS-C01考試中通常出5〜8題。
考試提示: 關鍵決策因素:延遲需求、流量、成本、有效負載大小。對應方式:即時(低延遲)→ 非同步(大型有效負載)→ 無伺服器(零星流量)→ 批次(無延遲需求)。
| 部署類型 | 延遲 | 吞吐量 | 成本模式 | 最適用途 |
|---|---|---|---|---|
| 即時端點 | 毫秒 | 高 | 持續運行(按小時計費) | 互動式應用、API |
| 無伺服器推論 | 秒(冷啟動) | 不定 | 按調用計費 | 零星、不可預測的流量 |
| 非同步推論 | 分鐘 | 高(佇列式) | 按處理計費 | 大型有效負載、非緊急 |
| 批次轉換 | 非即時 | 非常高 | 按批次工作計費 | 排程離線預測 |
2. 即時推論
標準部署 — 持久端點持續運行,同步回應。
Real-time Endpoint Architecture:

Client ──→ HTTPS Request
              ↓
      SageMaker Endpoint
      ┌────────────────┐
      │  Model Server  │  ← Instance running 24/7
      │  (TorchServe,  │
      │  TensorFlow    │
      │  Serving, etc) │
      └────────────────┘
              ↓
         Response (ms)
2.1. 端點自動擴展
端點可以透過Application Auto Scaling基於InvocationsPerInstance指標進行擴展。
3. 無伺服器推論
適合流量不均勻、難以預測的情況。AWS自動擴展,包括在沒有流量時縮減至0。
| 功能 | 詳情 |
|---|---|
| 冷啟動延遲 | 約1-2秒(閒置後的第一次請求) |
| 記憶體配置 | 1 GB → 6 GB |
| 最大有效負載 | 4 MB |
| 定價 | 按推論請求 + 處理時間 |
4. 非同步推論
適合大型媒體檔案、長時間處理的情況。請求排入佇列,回應儲存至S3。
Async Inference Flow:

Client ──→ Upload payload to S3 ──→ Invoke Endpoint
                                          ↓
                                   Queue Request
                                          ↓
                               Process when instance available
                                          ↓
                                   Save output to S3
                                          ↓
                           SNS Notification → Client
| 功能 | 詳情 |
|---|---|
| 最大有效負載 | 1 GB(即時為6 MB) |
| 自動縮減至0 | 是 — 佇列為空時縮減 |
| 回應 | S3輸出路徑 + SNS通知 |
5. 批次轉換
按排程對整個數據集執行預測。沒有端點 — 僅在需要時執行。
Batch Transform:

Input S3 ──→ Batch Transform Job ──→ Output S3
  (CSV/       (ephemeral compute)      (CSV/JSON
  JSON/                                predictions)
  Parquet)           ↑
               No persistent endpoint
               Pay only when running
6. 多模型端點(MME)
MME允許在單一端點上託管多個模型,降低推論基礎設施成本。
| 功能 | 詳情 |
|---|---|
| 成本節省 | 單一端點服務數千個模型 |
| 動態載入 | 模型按需載入記憶體、快取 |
| 使用情境 | SaaS多租戶,每個客戶一個模型 |
7. SageMaker Neo — 邊緣部署
SageMaker Neo編譯模型並針對特定硬體(邊緣裝置、行動裝置)進行最佳化。
Neo Workflow:

Trained Model (S3)
       ↓
  Neo Compiler
  (optimizes for target hardware)
       ↓
 Optimized Model
       ↓
    ├── Deploy to IoT Greengrass (edge)
    ├── Deploy to ARM devices
    └── Deploy to mobile (Android/iOS)
8. 速查表 — 部署決策
| 情境 | 部署類型 |
|---|---|
| 行動應用,即時回應(<100ms) | 即時端點 |
| 流量零星(每小時幾個請求) | 無伺服器推論 |
| 影片/音訊處理(大型檔案) | 非同步推論 |
| 每晚對完整數據集進行預測 | 批次轉換 |
| 數千個客戶特定模型 | 多模型端點 |
| IoT邊緣裝置部署 | SageMaker Neo + Greengrass |
9. 練習題
Q1: 一家公司經營一個電商聊天機器人,在購物高峰期需要低於100毫秒的回應時間。應該使用哪種SageMaker推論類型?
- A) 批次轉換
- B) 非同步推論
- C) 無伺服器推論
- D) 即時端點 ✓
解析:即時端點提供持久的、持續運行的毫秒級延遲推論。無伺服器有冷啟動延遲,非同步是非同步的(非低於100毫秒),批次轉換用於排程離線處理。
Q2: 一家媒體公司想對1 GB的影片檔案執行ML分類。處理時間不緊急。最適當的SageMaker推論選項是哪個?
- A) 即時端點
- B) 無伺服器推論
- C) 非同步推論 ✓
- D) 批次轉換
解析:非同步推論支援高達1 GB的有效負載並將請求排入佇列處理,非常適合大型媒體檔案。即時限制為6 MB有效負載,無伺服器限制為4 MB,批次轉換用於排程批量預測而非即時佇列。
Q3: 一家SaaS公司為其10,000個企業客戶各提供獨立的ML模型。為每個模型託管單獨的端點太昂貴。最佳解決方案是什麼?
- A) 將所有模型合併為一個大型模型
- B) 使用SageMaker多模型端點 ✓
- C) 在單一批次轉換工作中部署所有模型
- D) 為每個模型使用無伺服器推論
解析:多模型端點(MME)在單一端點上託管多個模型,按需動態將它們載入記憶體。這正是為多租戶場景設計的,每個客戶有自己的模型,可大幅降低基礎設施成本。