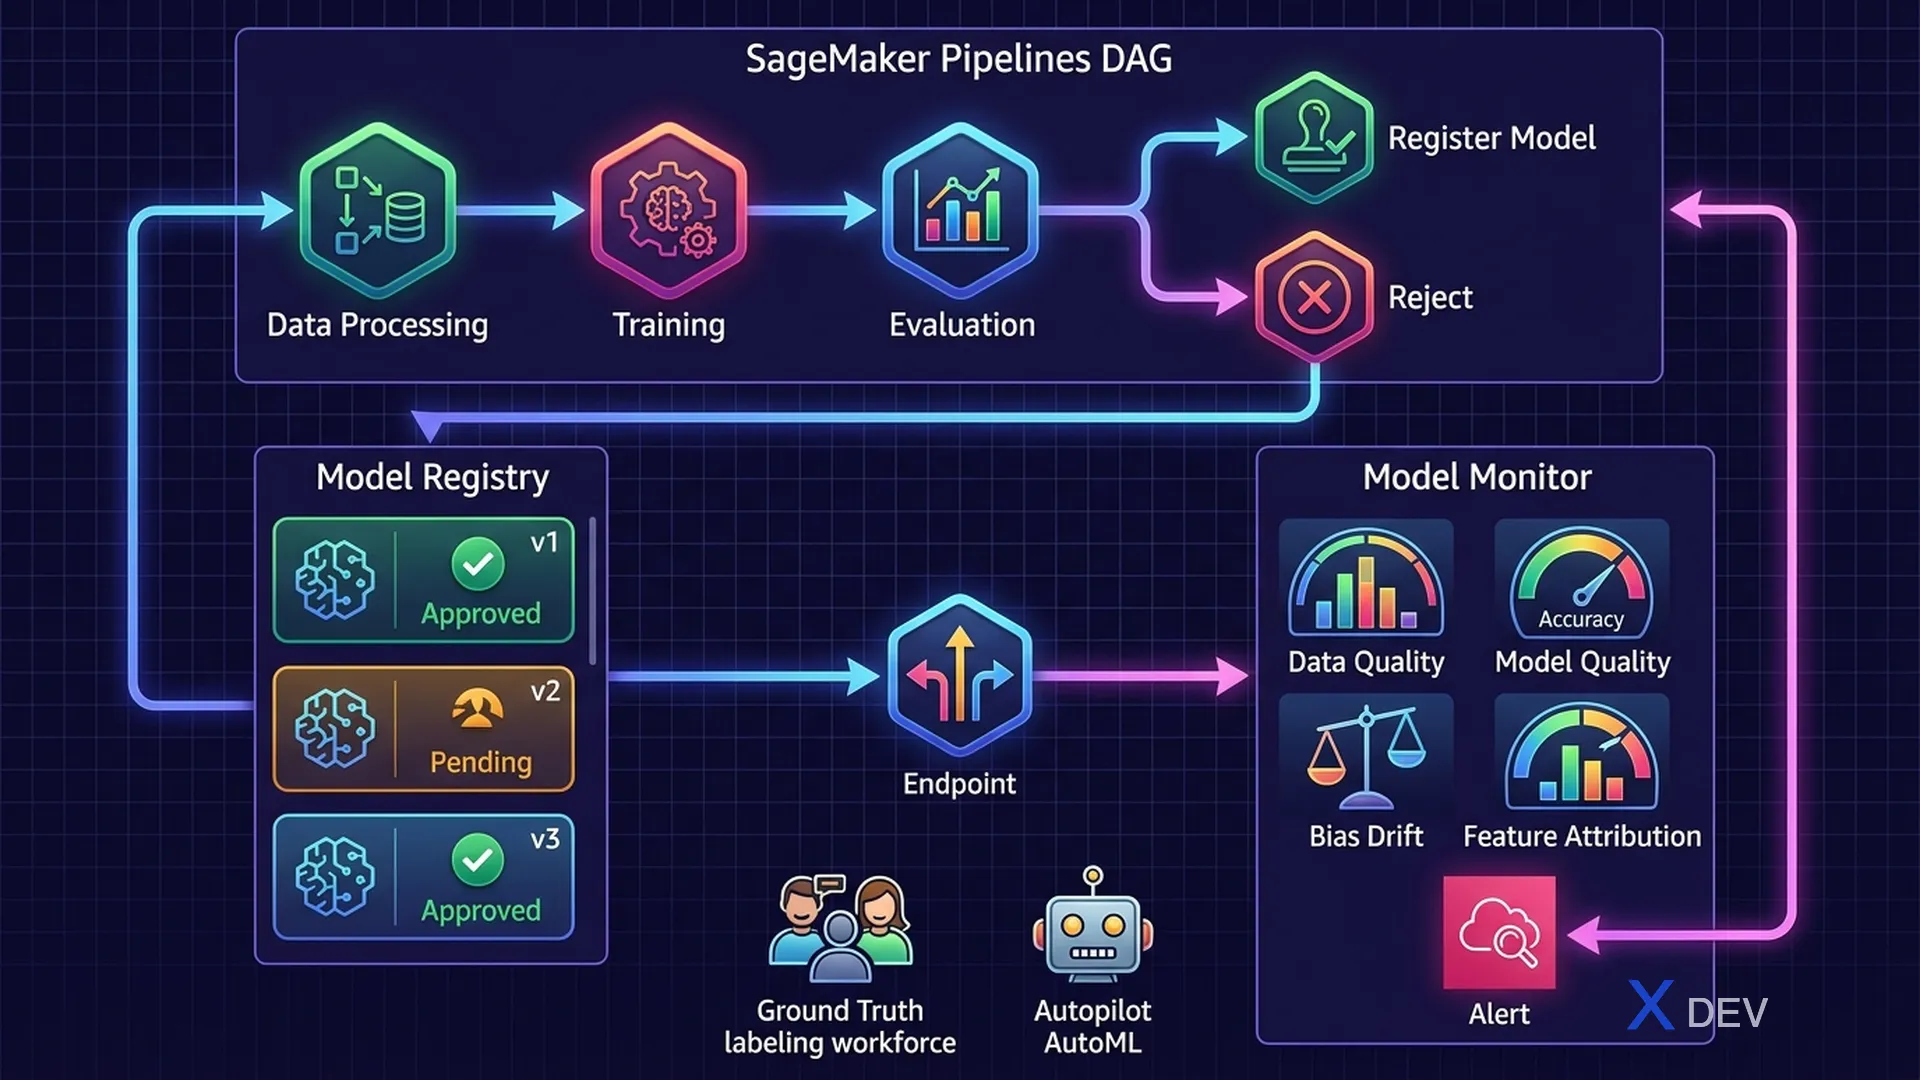
SageMaker MLOps:Model Monitor、SageMaker Pipelines、MLワークフローのCI/CD
1. SageMaker Model Monitor
SageMaker Model Monitorはデプロイされたモデルを自動監視し、本番環境での品質問題を検出します。MLOpsで最も重要なトピックの1つです。
| 監視タイプ | 検出内容 | ベースライン |
|---|---|---|
| データ品質監視 | 入力特徴量の統計的ドリフト(平均、標準偏差、完全性) | 訓練データ統計 |
| モデル品質監視 | モデルパフォーマンスの低下(accuracy、F1の低下) | グラウンドトゥルースラベル |
| バイアスドリフト監視 | 予測における公平性指標の変化 | Clarifyベースライン |
| 特徴量アトリビューションドリフト | SHAP値の変化 — 特徴量の重要度変化 | Clarifyベースライン |
試験のヒント: Model Monitorは比較のためのベースラインが必要です。ベースラインはデプロイ時に訓練データから作成されます。スケジュール(時間単位/日次)で実行され、受信データをベースラインと比較し、ドリフトが閾値を超えた場合にアラートを発信します。
1.1. ドリフトの種類
Data Drift Types:

┌─────────────────────────────────────────────────────┐
│  Covariate Shift (Input Drift):                     │
│  Input distribution P(X) changes                   │
│  Example: model trained on summer data,             │
│  production gets winter data                        │
│                                                     │
│  Concept Drift (Label Drift):                       │
│  Relationship P(Y|X) changes                        │
│  Example: fraud patterns evolve over time          │
│                                                     │
│  Prior Probability Shift:                           │
│  P(Y) class distribution changes                    │
│  Example: seasonal products change target balance   │
└─────────────────────────────────────────────────────┘
2. SageMaker Pipelines — MLOps CI/CD
SageMaker PipelinesはMLOpsワークフローオーケストレーションツールで、再現可能で自動化可能なMLパイプラインを作成します。
SageMaker Pipeline Example:

  ProcessingStep ──→ TrainingStep ──→ EvaluationStep ──→ ConditionStep
       ↓                  ↓                ↓                   ↓
   Clean Data         Train Model      Compute Metrics    If accuracy > 0.85
   Feature Eng        Save Artifact    to S3              ↓           ↓
                                                     Register    Fail Pipeline
                                                      Model
| ステップタイプ | 動作 |
|---|---|
| ProcessingStep | Processing Jobsによるデータ前処理 |
| TrainingStep | Training Jobsによるモデル訓練 |
| EvaluationStep | モデル評価、メトリクス計算 |
| ConditionStep | メトリクスに基づく分岐ロジック |
| RegisterModelStep | 承認済みモデルをModel Registryに登録 |
| TransformStep | バッチ変換推論 |
3. SageMaker Model Registry
Model RegistryはMLモデルのライフサイクルを通じて追跡・管理するための一元的なカタログです。
| 機能 | 説明 |
|---|---|
| Model Groups | 同一モデルのバージョンの論理的グルーピング |
| 承認ステータス | PendingManualApproval → Approved → Rejected |
| モデルリネージ | 各バージョンの訓練ジョブ、データ、アーティファクトを追跡 |
| デプロイ | Registryから直接エンドポイントにデプロイ |
4. SageMaker Ground Truth
Ground Truthは人間のラベラーと自動ラベリングを組み合わせて高品質なラベル付き訓練データセットの作成を支援します。
Ground Truth Workflow:

Raw Data (S3) ──→ Labeling Job
                       ↓
             ┌─── Auto Labeling ───┐
             │   (ML model labels  │
             │   easy examples)    │
             │                     │
             └─── Human Labeling ──┘
                   (Mechanical Turk
                    or private team
                    for hard examples)
                       ↓
               Labeled Dataset (S3)
5. SageMaker Autopilot — AutoML
AutopilotはMLモデルを自動的に訓練・チューニングする完全なAutoMLと説明可能性を提供します。
| Autopilotの機能 | 詳細 |
|---|---|
| 自動特徴量エンジニアリング | データタイプ検出、欠損値処理、エンコーディング |
| アルゴリズム選択 | 複数アルゴリズム試行(XGBoost、Deep Learning、Linear) |
| ハイパーパラメータチューニング | アルゴリズムごとのベイズ最適化 |
| 説明可能性 | SageMaker Clarify統合 — SHAP値 |
| リーダーボード | ターゲット指標によるモデルランキング |
試験のヒント: Autopilotはテーブルデータのみをサポートします。「非技術者向けにモデル構築を自動化」→ Autopilot。SageMaker JumpStart(事前構築モデル)やCanvas(ビジネスユーザー向けノーコード)とは異なります。
6. チートシート — MLOpsサービス
| シナリオ | サービス |
|---|---|
| 本番環境のデータドリフト検出 | SageMaker Model Monitor(データ品質) |
| 自動化MLパイプラインCI/CD | SageMaker Pipelines |
| モデルバージョンの追跡・管理 | SageMaker Model Registry |
| 大規模な訓練データラベリング | SageMaker Ground Truth |
| コーディングなしのAutoML | SageMaker Autopilot |
| 実験の追跡(メトリクス、パラメータ) | SageMaker Experiments |
| モデルパフォーマンス低下アラート | Model Monitor + CloudWatch Alarms |
7. 練習問題
Q1: デプロイされた不正検知モデルのaccuracyが3ヶ月後に大幅に低下しました。調査の結果、入力特徴量の分布が変化していることがわかりました。今後これを自動検出するためにどのツールを使用すべきですか?
- A) SageMaker Clarify
- B) SageMaker Experiments
- C) SageMaker Model Monitor — データ品質監視 ✓
- D) SageMaker Ground Truth
解説:SageMaker Model Monitorのデータ品質監視は、受信する推論データの統計量を訓練データのベースラインと継続的に比較します。特徴量ドリフト(分布の変化)を検出し、閾値を超えた場合にCloudWatchアラートを送信します。
Q2: チームが新しいデータが到着したときに自動的にモデルを再訓練・デプロイする再現可能なMLパイプラインを作成し、本番デプロイ前に人間の承認ステップを設けたいと考えています。これを提供するサービスはどれですか?
- A) SageMaker Autopilot
- B) SageMaker Pipelines + Model Registry ✓
- C) AWS Step Functionsのみ
- D) SageMaker Ground Truth
解説:SageMaker PipelinesがMLワークフローを調整し(データ準備→訓練→評価→登録)、Model Registryが承認ワークフロー(PendingManualApproval → Approved)を提供します。この組み合わせがAWSの標準MLOpsソリューションです。
Q3: ある企業が物体検出訓練のために100,000枚の画像にラベルを付ける必要があります。MLを使用して簡単な例を自動的にラベル付けすることでコストを最小化したいと考えています。どのサービスを使用すべきですか?
- A) SageMaker Autopilot
- B) Amazon Rekognition Custom Labels
- C) 自動ラベリング付きSageMaker Ground Truth ✓
- D) AWS Glue DataBrew
解説:SageMaker Ground Truthは自動ラベリングを使用し、MLモデルが高信頼度の例を自動的にラベル付けし、不確実な例のみを人間のワーカーに送信します。これによりラベリングコストを最大70%削減できます。