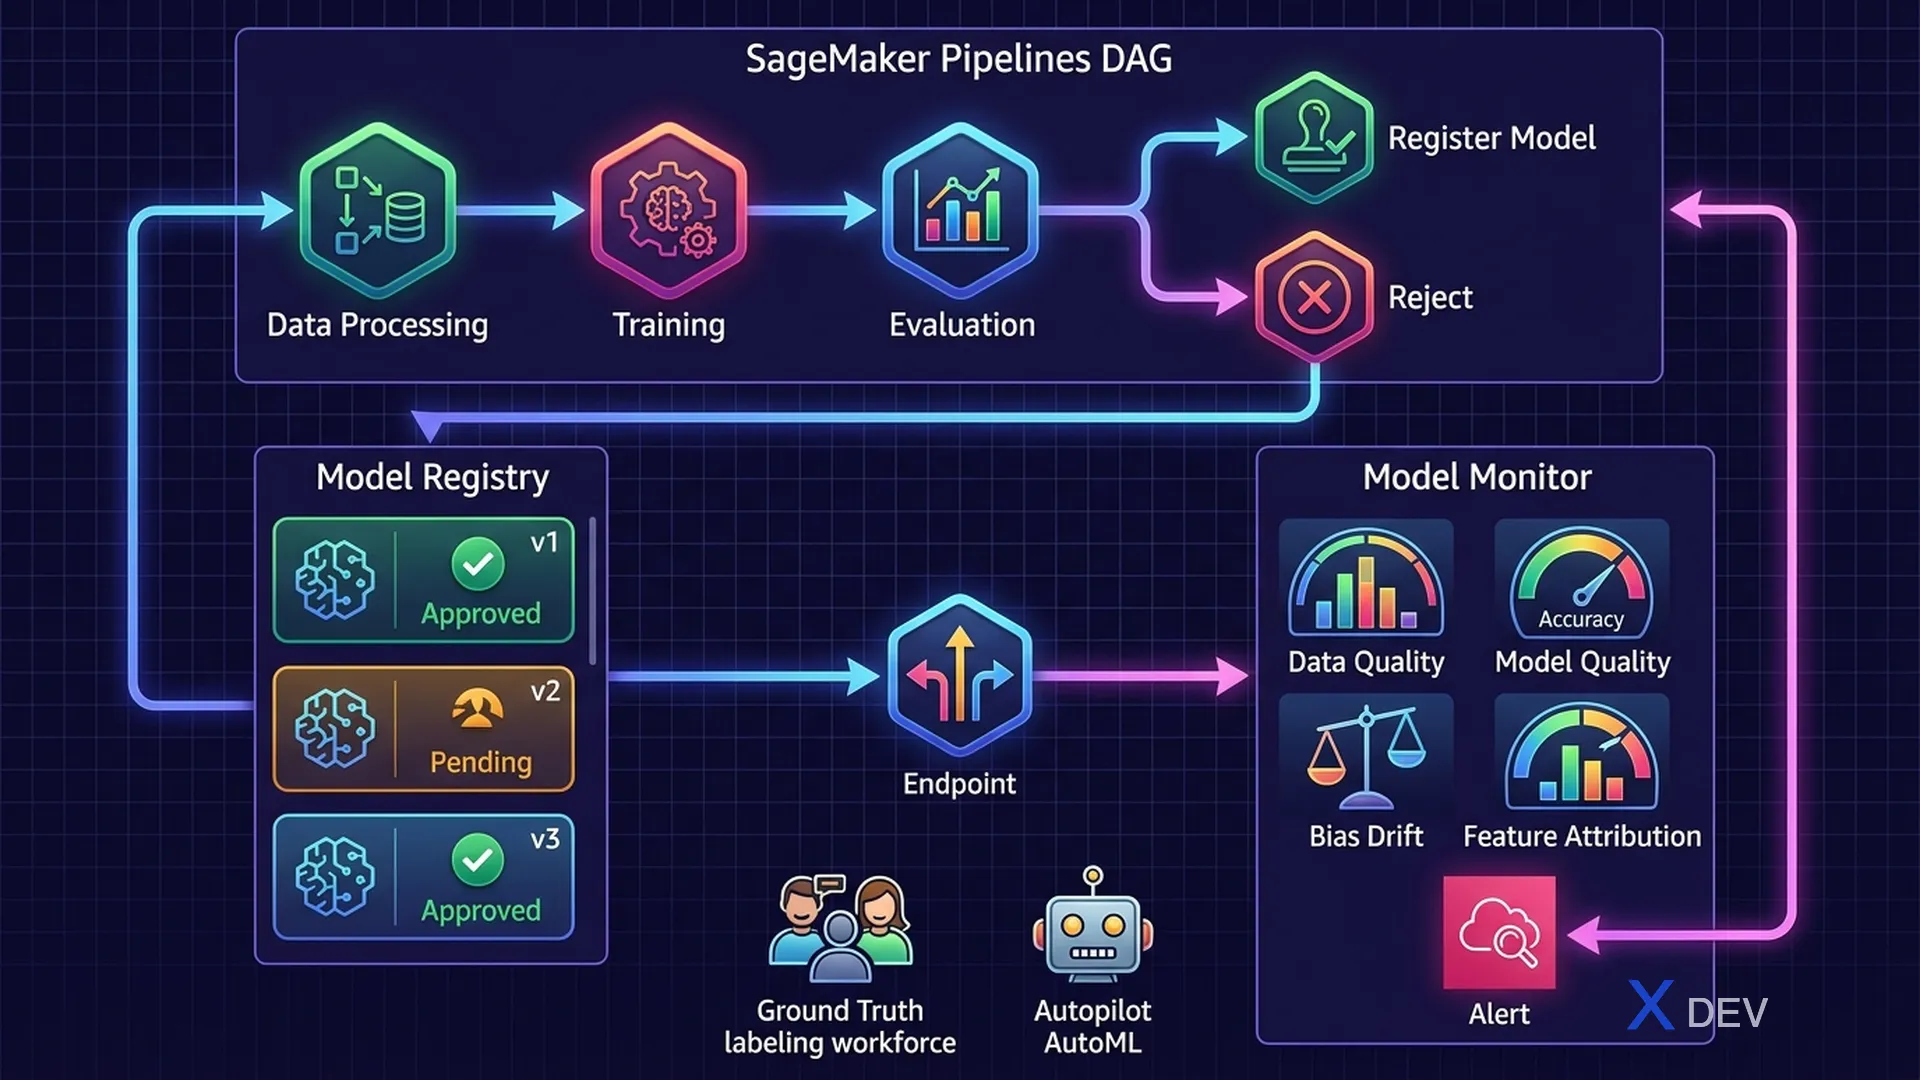
SageMaker MLOps:Model Monitor、SageMaker Pipelines與ML工作流的CI/CD
1. SageMaker Model Monitor
SageMaker Model Monitor自動監控已部署的模型,以檢測正式環境中的品質問題。這是MLOps最重要的主題之一。
| 監控類型 | 檢測內容 | 基準線來源 |
|---|---|---|
| 數據品質監控 | 輸入特徵的統計漂移(均值、標準差、完整性) | 訓練數據統計 |
| 模型品質監控 | 模型效能下降(accuracy、F1下降) | 真實標籤 |
| 偏差漂移監控 | 預測中公平性指標的偏移 | Clarify基準線 |
| 特徵歸因漂移 | SHAP值變化 — 特徵重要性改變 | Clarify基準線 |
考試提示: Model Monitor需要基準線來進行比較。基準線在部署時從訓練數據建立。監控按排程執行(每小時/每天),將傳入數據與基準線比較,如果漂移超過閾值則發出警報。
1.1. 漂移類型
Data Drift Types:

┌─────────────────────────────────────────────────────┐
│  Covariate Shift(輸入漂移):                        │
│  輸入分佈P(X)改變                                    │
│  例如:模型在夏季數據上訓練,                          │
│  正式環境收到冬季數據                                  │
│                                                     │
│  Concept Drift(概念漂移):                          │
│  關係P(Y|X)改變                                      │
│  例如:欺詐模式隨時間演變                              │
│                                                     │
│  Prior Probability Shift(先驗機率偏移):             │
│  P(Y)類別分佈改變                                     │
│  例如:季節性產品改變目標平衡                           │
└─────────────────────────────────────────────────────┘
2. SageMaker Pipelines — MLOps CI/CD
SageMaker Pipelines是MLOps工作流編排工具 — 建立可重現、可自動化的ML管線。
SageMaker Pipeline Example:

  ProcessingStep ──→ TrainingStep ──→ EvaluationStep ──→ ConditionStep
       ↓                  ↓                ↓                   ↓
   Clean Data         Train Model      Compute Metrics    If accuracy > 0.85
   Feature Eng        Save Artifact    to S3              ↓           ↓
                                                     Register    Fail Pipeline
                                                      Model
| 步驟類型 | 功能 |
|---|---|
| ProcessingStep | 透過Processing Jobs進行數據預處理 |
| TrainingStep | 透過Training Jobs進行模型訓練 |
| EvaluationStep | 模型評估、計算指標 |
| ConditionStep | 基於指標的分支邏輯 |
| RegisterModelStep | 將核准的模型註冊至Model Registry |
| TransformStep | 批次轉換推論 |
3. SageMaker Model Registry
Model Registry是追蹤和治理ML模型整個生命週期的集中目錄。
| 功能 | 說明 |
|---|---|
| 模型群組 | 相同模型各版本的邏輯分組 |
| 核准狀態 | PendingManualApproval → Approved → Rejected |
| 模型譜系 | 追蹤每個版本的訓練工作、數據、產出物 |
| 部署 | 從Registry直接部署至端點 |
4. SageMaker Ground Truth
Ground Truth結合人工標註者和自動標註,協助建立高品質標註訓練數據集。
Ground Truth Workflow:

Raw Data (S3) ──→ Labeling Job
                       ↓
             ┌─── Auto Labeling ───┐
             │   (ML model labels  │
             │   easy examples)    │
             │                     │
             └─── Human Labeling ──┘
                   (Mechanical Turk
                    or private team
                    for hard examples)
                       ↓
               Labeled Dataset (S3)
5. SageMaker Autopilot — AutoML
Autopilot自動訓練和調校ML模型 — 具備可解釋性的完整AutoML。
| Autopilot功能 | 詳情 |
|---|---|
| 自動特徵工程 | 檢測數據類型、處理缺失值、編碼 |
| 演算法選擇 | 嘗試多種演算法(XGBoost、深度學習、線性) |
| 超參數調校 | 每種演算法的貝葉斯最佳化 |
| 可解釋性 | 整合SageMaker Clarify — SHAP值 |
| 排行榜 | 按目標指標排序的模型 |
考試提示: Autopilot僅支援表格數據。當題目問「為非技術用戶自動化建模」→ Autopilot。與SageMaker JumpStart(預建模型)和Canvas(商業用戶的無程式碼工具)不同。
6. 速查表 — MLOps服務
| 情境 | 服務 |
|---|---|
| 檢測正式環境中的數據漂移 | SageMaker Model Monitor(數據品質) |
| 自動化ML管線CI/CD | SageMaker Pipelines |
| 追蹤和治理模型版本 | SageMaker Model Registry |
| 大規模標註訓練數據 | SageMaker Ground Truth |
| 無需編碼的AutoML | SageMaker Autopilot |
| 追蹤實驗(指標、參數) | SageMaker Experiments |
| 模型效能下降警報 | Model Monitor + CloudWatch Alarms |
7. 練習題
Q1: 已部署的欺詐檢測模型的accuracy在3個月後大幅下降。調查顯示輸入特徵分佈已改變。應該使用什麼工具來自動檢測這種情況?
- A) SageMaker Clarify
- B) SageMaker Experiments
- C) SageMaker Model Monitor — 數據品質監控 ✓
- D) SageMaker Ground Truth
解析:SageMaker Model Monitor的數據品質監控持續將傳入推論數據統計與訓練數據基準線進行比較。它檢測特徵漂移(改變的分佈)並在超過閾值時發送CloudWatch警報。
Q2: 團隊想要建立一個可重現的ML管線,當新數據到達時自動重新訓練和部署模型,並在正式環境部署前有人工核准步驟。哪個服務提供此功能?
- A) SageMaker Autopilot
- B) SageMaker Pipelines + Model Registry ✓
- C) 僅AWS Step Functions
- D) SageMaker Ground Truth
解析:SageMaker Pipelines編排ML工作流(數據準備 → 訓練 → 評估 → 註冊)。Model Registry提供核准工作流(PendingManualApproval → Approved),在部署前設置人工閘門 — 兩者的組合是AWS上的標準MLOps解決方案。
Q3: 一家公司需要為物體檢測訓練標註100,000張圖片。他們希望通過使用ML自動標註簡單範例來最小化標註成本。應該使用哪個服務?
- A) SageMaker Autopilot
- B) Amazon Rekognition Custom Labels
- C) SageMaker Ground Truth搭配自動標註 ✓
- D) AWS Glue DataBrew
解析:SageMaker Ground Truth使用自動標註,其中ML模型自動標註高信心度的範例,僅將不確定的範例發送給人工標註者。這可以將標註成本降低高達70%。