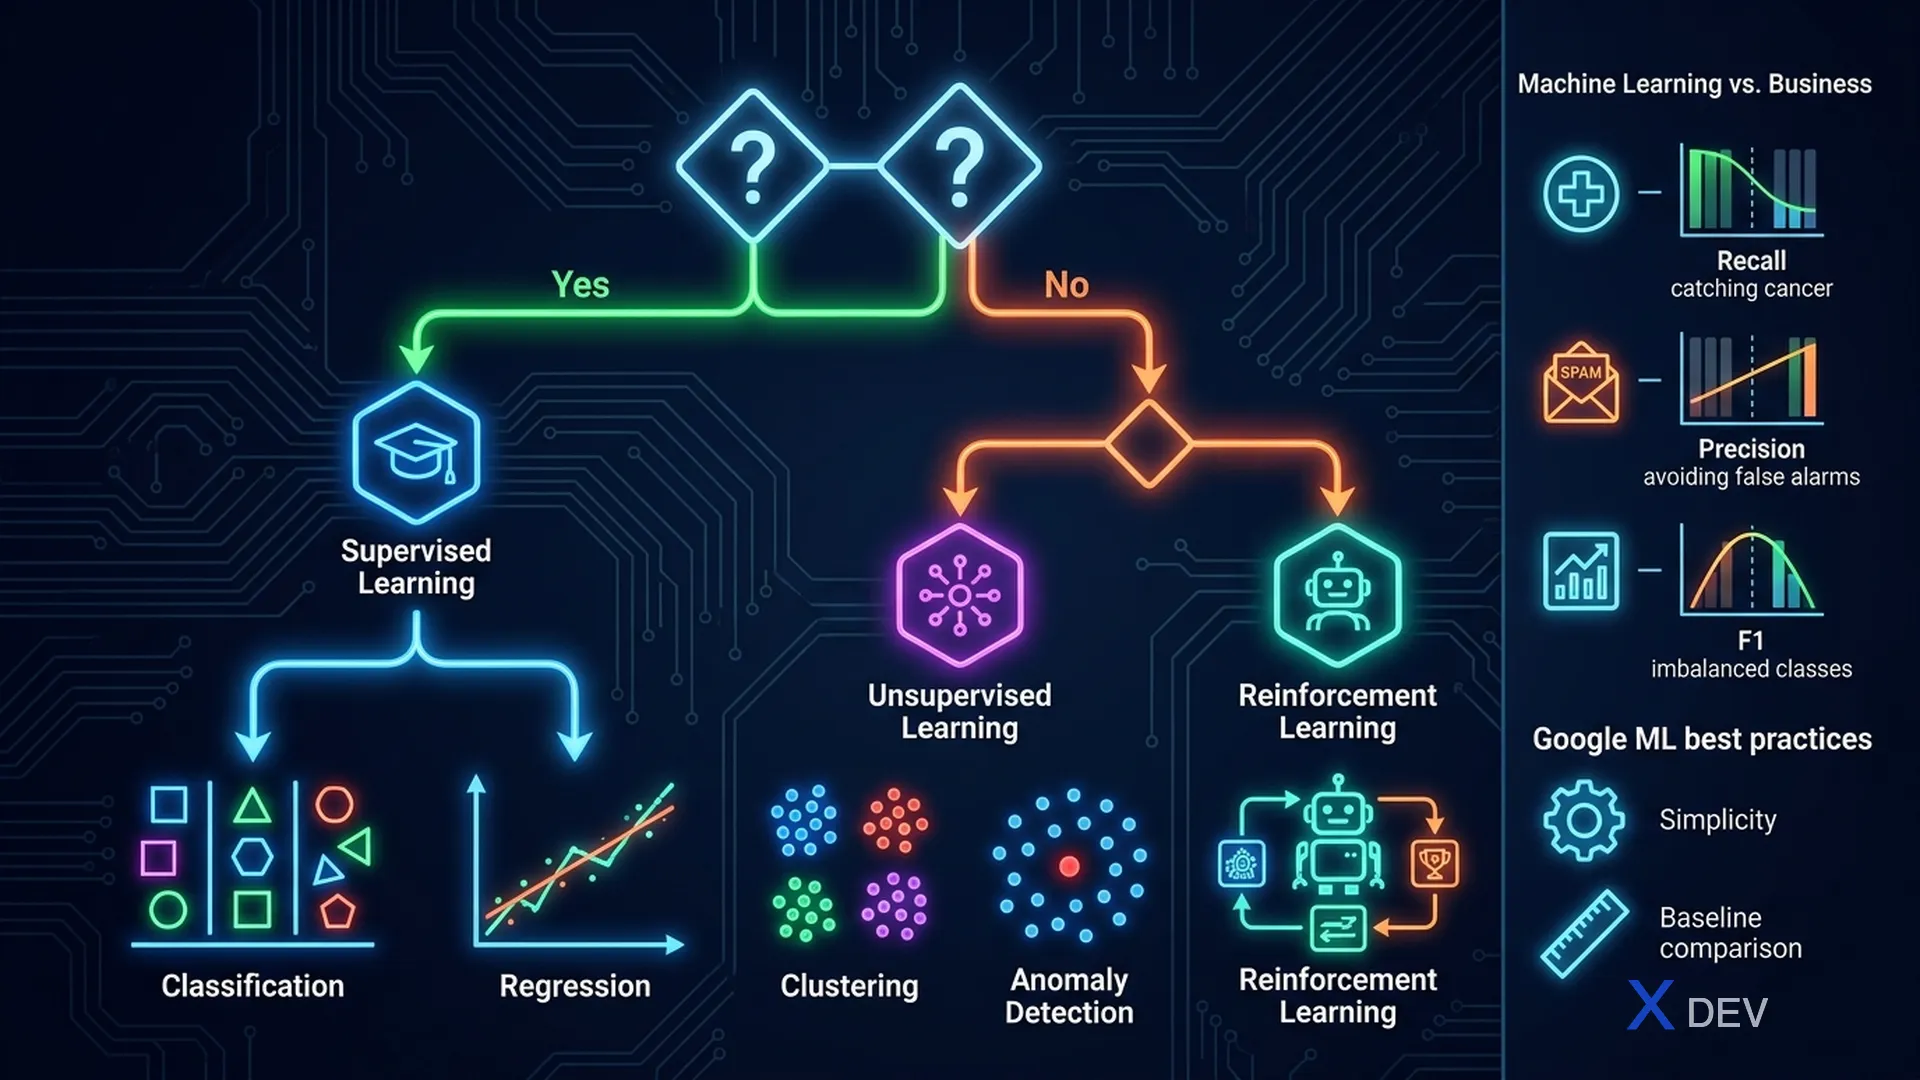
ML問題のフレーミング:問題の特定、モデルタイプの選択、Google標準に基づくメトリクスの定義
1. いつMLを使うべきか?
Google ML認定試験では問題のフレーミングに関する問題が頻出します。つまり、その問題がMLの適用に適しているかどうか、適している場合はどの種類のMLを使うべきかを判断する能力です。これはプロフェッショナルMLエンジニアにとって重要なスキルです。
| 確認すべき質問 | 「はい」の場合 | 「いいえ」の場合 |
|---|---|---|
| データに複雑なパターンがあるか? | MLが有効 | ルールベースのロジックで十分 |
| 十分なデータ(ラベル)があるか? | 教師あり学習 | 教師なし学習、またはデータ追加収集 |
| 出力を明確に定義できるか? | 教師ありML | ステークホルダーとの要件確認が必要 |
| エージェントが環境と対話する必要があるか? | 強化学習 | 教師あり/教師なし学習 |
2. MLの種類と使い分け
Problem Framing Decision Tree:

Has labeled training data?
    YES → Supervised Learning
           ├── Output is category? → Classification
           └── Output is number? → Regression

    NO → Has examples, no labels?
           YES → Unsupervised Learning
                  ├── Find groups? → Clustering
                  └── Find patterns/anomalies? → Density estimation
           NO → Agent in environment?
                  YES → Reinforcement Learning
                  NO → Reconsider problem definition
| MLの種類 | 使用場面 | GCPサービス |
|---|---|---|
| 教師あり分類 | メールスパム検出、画像ラベリング、解約予測 | Vertex AI AutoML、BigQuery ML |
| 教師あり回帰 | 価格予測、需要予測 | Vertex AI、BigQuery ML BQML_REGRESSOR |
| 教師なしクラスタリング | 顧客セグメンテーション、トピック発見 | Vertex AI Custom Training(k-means) |
| 強化学習 | ゲームエージェント、ロボティクス、広告入札 | Vertex AI + カスタム環境 |
| 自己教師あり学習 | LLM、基盤モデル | Vertex AI Model Garden |
3. ビジネス指標 vs. ML指標
よくある間違いの一つは、誤った指標を最適化することです。MLの目標はビジネスの目標と一致している必要があります。
| ビジネス目標 | 誤ったML指標 | 正しいML指標 |
|---|---|---|
| 不正による収益損失の削減 | Accuracy(99%!) | Recall(より多くの不正を検出) |
| スパムメールによるユーザー体験の低下を防ぐ | Recall | Precision(偽陽性を少なく) |
| 在庫の需要予測 | MSE | MAPE(スケール非依存) |
| 検索結果の商品ランキング | Accuracy | NDCG、MRR(ランキング指標) |
試験のヒント: Professional ML Engineer試験では「ビジネス目標に最も合致する指標はどれか」という問題が頻出します。不正検知/医療診断 → Recall。スパム/精度重視 → Precision。クラス不均衡 → F1またはAUC-ROC。
4. データ可用性の評価
| データの状況 | MLアプローチ |
|---|---|
| ラベル付きデータが豊富 | 完全教師あり学習、ゼロからトレーニング |
| ラベル付きデータが少ない(1000未満) | 転移学習(事前学習済みモデル + ファインチューニング) |
| ラベルなし | 教師なし学習、またはラベル収集(Vertex AI Data Labeling) |
| ラベル付けが高コスト | 能動学習 — 不確実なサンプルを優先的にラベル付け |
| データの不均衡 | オーバーサンプリング、アンダーサンプリング、クラス重み付け |
5. GoogleのMLベストプラクティス
- シンプルに始める:最もシンプルなモデルから始め、徐々に複雑化する
- ベースラインを確立する:MLを使う前にヒューリスティック/ルールと比較する
- データ品質を最優先:MLプロジェクトの80%の時間はデータ準備に費やされる
- 再現性:パイプラインは同じデータで再現可能でなければならない
- 本番環境でのモニタリング:モデルは時間とともに劣化する — 継続的なモニタリングが必要
6. 練習問題
Q1: ある企業が、今後30日以内にサブスクリプションをキャンセルする可能性が最も高い顧客を特定したいと考えています。解約イベントが記録された3年分の顧客行動履歴データがあります。どのMLアプローチを使用すべきでしょうか?
- A) 教師なしクラスタリングで顧客グループを発見する
- B) 強化学習でリテンションキャンペーンを最適化する
- C) 過去の解約ラベルを使った教師あり二値分類 ✓
- D) 異常検知で異常な行動を発見する
解説:これは典型的な教師あり分類問題です(解約 = はい/いいえ)。既知の結果(解約/非解約)を持つ過去のデータがラベルを提供します。クラスタリングでは個々の解約確率を予測できません。強化学習は予測ではなく、逐次的な意思決定に適しています。
Q2: 医療画像MLモデルがテストデータで98%の精度を達成しましたが、ビジネスチームは満足していません。タスクは稀ながん細胞の検出(発生率1%)です。最も可能性の高い問題は何でしょうか?
- A) モデルがトレーニングデータに過学習している
- B) Accuracyは誤った指標 — モデルがすべてに対して「がんなし」と予測している可能性がある ✓
- C) モデルにさらなるトレーニングイテレーションが必要
- D) テストデータセットが小さすぎる
解説:発生率1%の場合、常に「がんなし」と予測するモデルでも99%のAccuracyを達成しますが、Recallは0% — すべてのがん症例を見逃します。稀なクラスの問題では、AccuracyではなくRecall(感度)が重要な指標です。
Q3: あるスタートアップが、新しいカスタム分類タスク用に500枚のラベル付き商品画像を持っています。最も適切なトレーニングアプローチはどれでしょうか?
- A) 500枚の画像でディープラーニングCNNをゼロからトレーニングする
- B) 画像メタデータにAutoML Tabularを使用する
- C) 事前学習済み画像モデルからの転移学習を使用する ✓
- D) データセットが小さいのでK-Meansクラスタリングを適用する
解説:ラベル付き例が500枚しかない場合、ゼロからのトレーニングは深刻な過学習を引き起こします。転移学習は、数百万枚の画像(例:ImageNet)で事前学習されたモデルの特徴量を再利用し、新しいタスクで良好な精度を達成するために必要なデータ量を大幅に削減します。