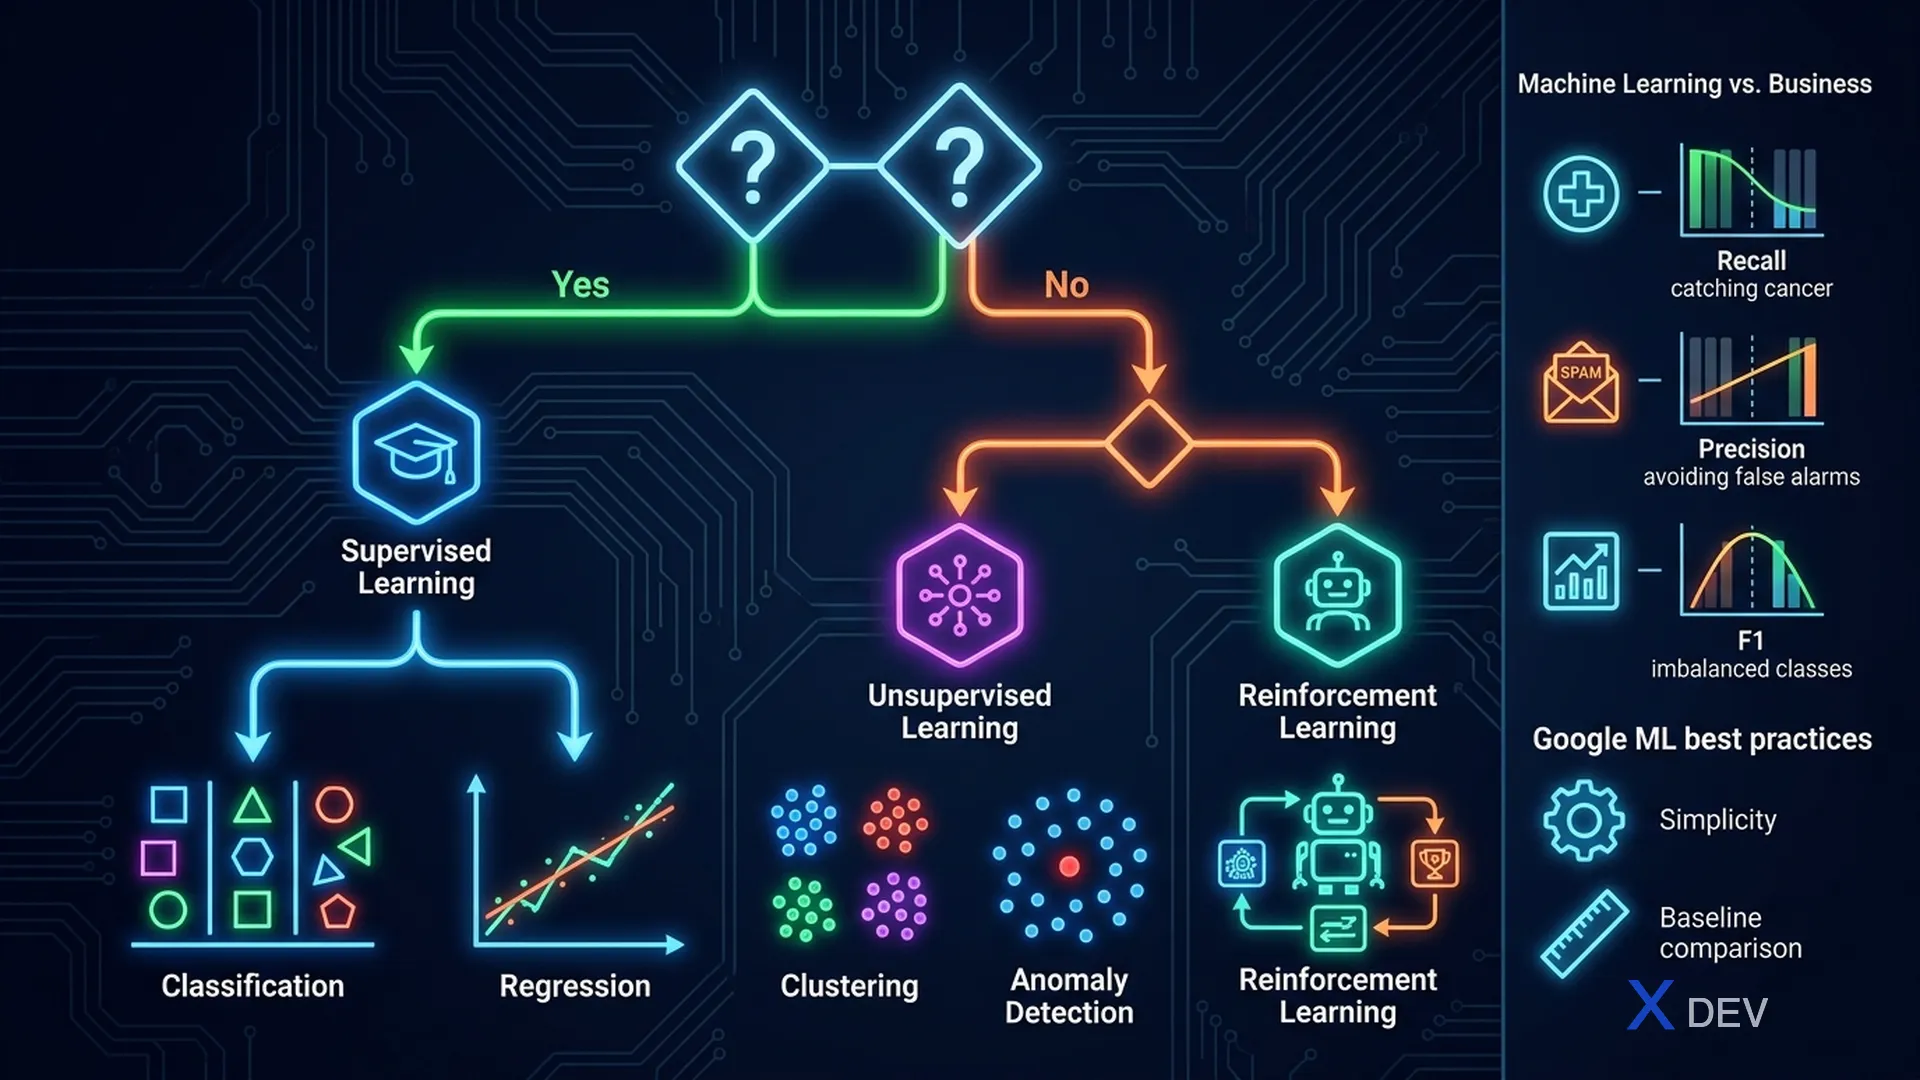
ML問題框架:確定問題、選擇模型類型、依照Google標準定義指標
1. 何時需要使用ML?
Google ML認證考試經常考察問題框架——即判斷問題是否適合應用ML,如果適合則應使用哪種類型的ML。這是專業ML工程師的重要技能。
| 需要提出的問題 | 如果「是」 | 如果「否」 |
|---|---|---|
| 資料中是否有複雜模式? | ML可以幫助 | 規則式邏輯就足夠了 |
| 是否有足夠的資料(標籤)? | 監督式學習 | 非監督式學習,或收集更多資料 |
| 輸出是否可以明確定義? | 監督式ML | 需要與利害關係人確認需求 |
| 問題是否需要代理與環境互動? | 強化學習 | 監督式/非監督式學習 |
2. ML的類型與使用時機
Problem Framing Decision Tree:

Has labeled training data?
    YES → Supervised Learning
           ├── Output is category? → Classification
           └── Output is number? → Regression

    NO → Has examples, no labels?
           YES → Unsupervised Learning
                  ├── Find groups? → Clustering
                  └── Find patterns/anomalies? → Density estimation
           NO → Agent in environment?
                  YES → Reinforcement Learning
                  NO → Reconsider problem definition
| ML類型 | 使用場景 | GCP服務 |
|---|---|---|
| 監督式分類 | 電子郵件垃圾郵件、影像標籤、客戶流失預測 | Vertex AI AutoML、BigQuery ML |
| 監督式迴歸 | 價格預測、需求預測 | Vertex AI、BigQuery ML BQML_REGRESSOR |
| 非監督式聚類 | 客戶分群、主題發現 | Vertex AI Custom Training(k-means) |
| 強化學習 | 遊戲代理、機器人、廣告競價 | Vertex AI + 自訂環境 |
| 自監督式學習 | LLM、基礎模型 | Vertex AI Model Garden |
3. 商業指標 vs. ML指標
最常見的錯誤之一是最佳化了錯誤的指標。ML目標必須與商業目標一致。
| 商業目標 | 錯誤的ML指標 | 正確的ML指標 |
|---|---|---|
| 減少詐欺造成的營收損失 | Accuracy(99%!) | Recall(捕捉更多詐欺) |
| 減少垃圾郵件影響使用者體驗 | Recall | Precision(減少誤判) |
| 庫存需求預測 | MSE | MAPE(不受規模影響) |
| 搜尋結果中的商品排名 | Accuracy | NDCG、MRR(排名指標) |
考試提示: Professional ML Engineer考試常問「哪個指標最符合商業目標」。看到詐欺檢測/醫療診斷 → Recall。看到垃圾郵件/精確度重要 → Precision。看到類別不平衡 → F1或AUC-ROC。
4. 資料可用性評估
| 資料狀況 | ML方法 |
|---|---|
| 大量標籤資料 | 完全監督式學習,從頭訓練 |
| 少量標籤資料(少於1000筆) | 遷移學習(預訓練模型 + 微調) |
| 沒有標籤 | 非監督式學習,或收集標籤(Vertex AI Data Labeling) |
| 標籤成本高 | 主動學習 — 優先標註不確定的樣本 |
| 資料不平衡 | 過取樣、欠取樣、類別權重 |
5. Google的ML最佳實踐
- 從簡單開始:從最簡單的模型開始,然後逐步增加複雜度
- 建立基準線:使用ML之前先與啟發式/規則進行比較
- 資料品質優先:ML專案80%的時間花在資料準備上
- 可重現性:管線必須能以相同資料重現結果
- 生產環境監控:模型隨時間衰退 — 需要持續監控
6. 練習題
Q1: 一家公司想要找出未來30天內最可能取消訂閱的客戶。他們有3年的客戶行為歷史資料,其中包含已知的流失事件。應該使用哪種ML方法?
- A) 非監督式聚類來發現客戶群組
- B) 強化學習來最佳化留存活動
- C) 使用歷史流失標籤的監督式二元分類 ✓
- D) 異常偵測來發現異常行為
解說:這是典型的監督式分類問題(流失 = 是/否)。具有已知結果(流失/未流失)的歷史資料提供了標籤。聚類無法預測個別的流失機率。強化學習適用於序列決策,而非預測。
Q2: 醫療影像ML模型在測試資料上達到98%的準確率,但業務團隊不滿意。任務是偵測罕見的癌細胞(盛行率1%)。最可能的問題是什麼?
- A) 模型對訓練資料過擬合
- B) Accuracy是錯誤的指標 — 模型可能對所有情況都預測「無癌症」 ✓
- C) 模型需要更多訓練迭代
- D) 測試資料集太小
解說:盛行率僅1%時,一個總是預測「無癌症」的模型也能達到99%的Accuracy,但Recall為0% — 它漏掉了所有癌症病例。對於罕見類別問題,Recall(敏感度)才是關鍵指標,而非Accuracy。
Q3: 一個新創公司有500張標籤商品影像用於新的自訂分類任務。最合適的訓練方法是哪個?
- A) 用500張影像從頭訓練深度學習CNN
- B) 對影像中繼資料使用AutoML Tabular
- C) 使用預訓練影像模型進行遷移學習 ✓
- D) 因為資料集太小所以使用K-Means聚類
解說:僅有500個標籤範例時,從頭訓練會嚴重過擬合。遷移學習重複使用在數百萬張影像(如ImageNet)上預訓練的模型特徵,大幅減少在新任務上達到良好準確率所需的資料量。