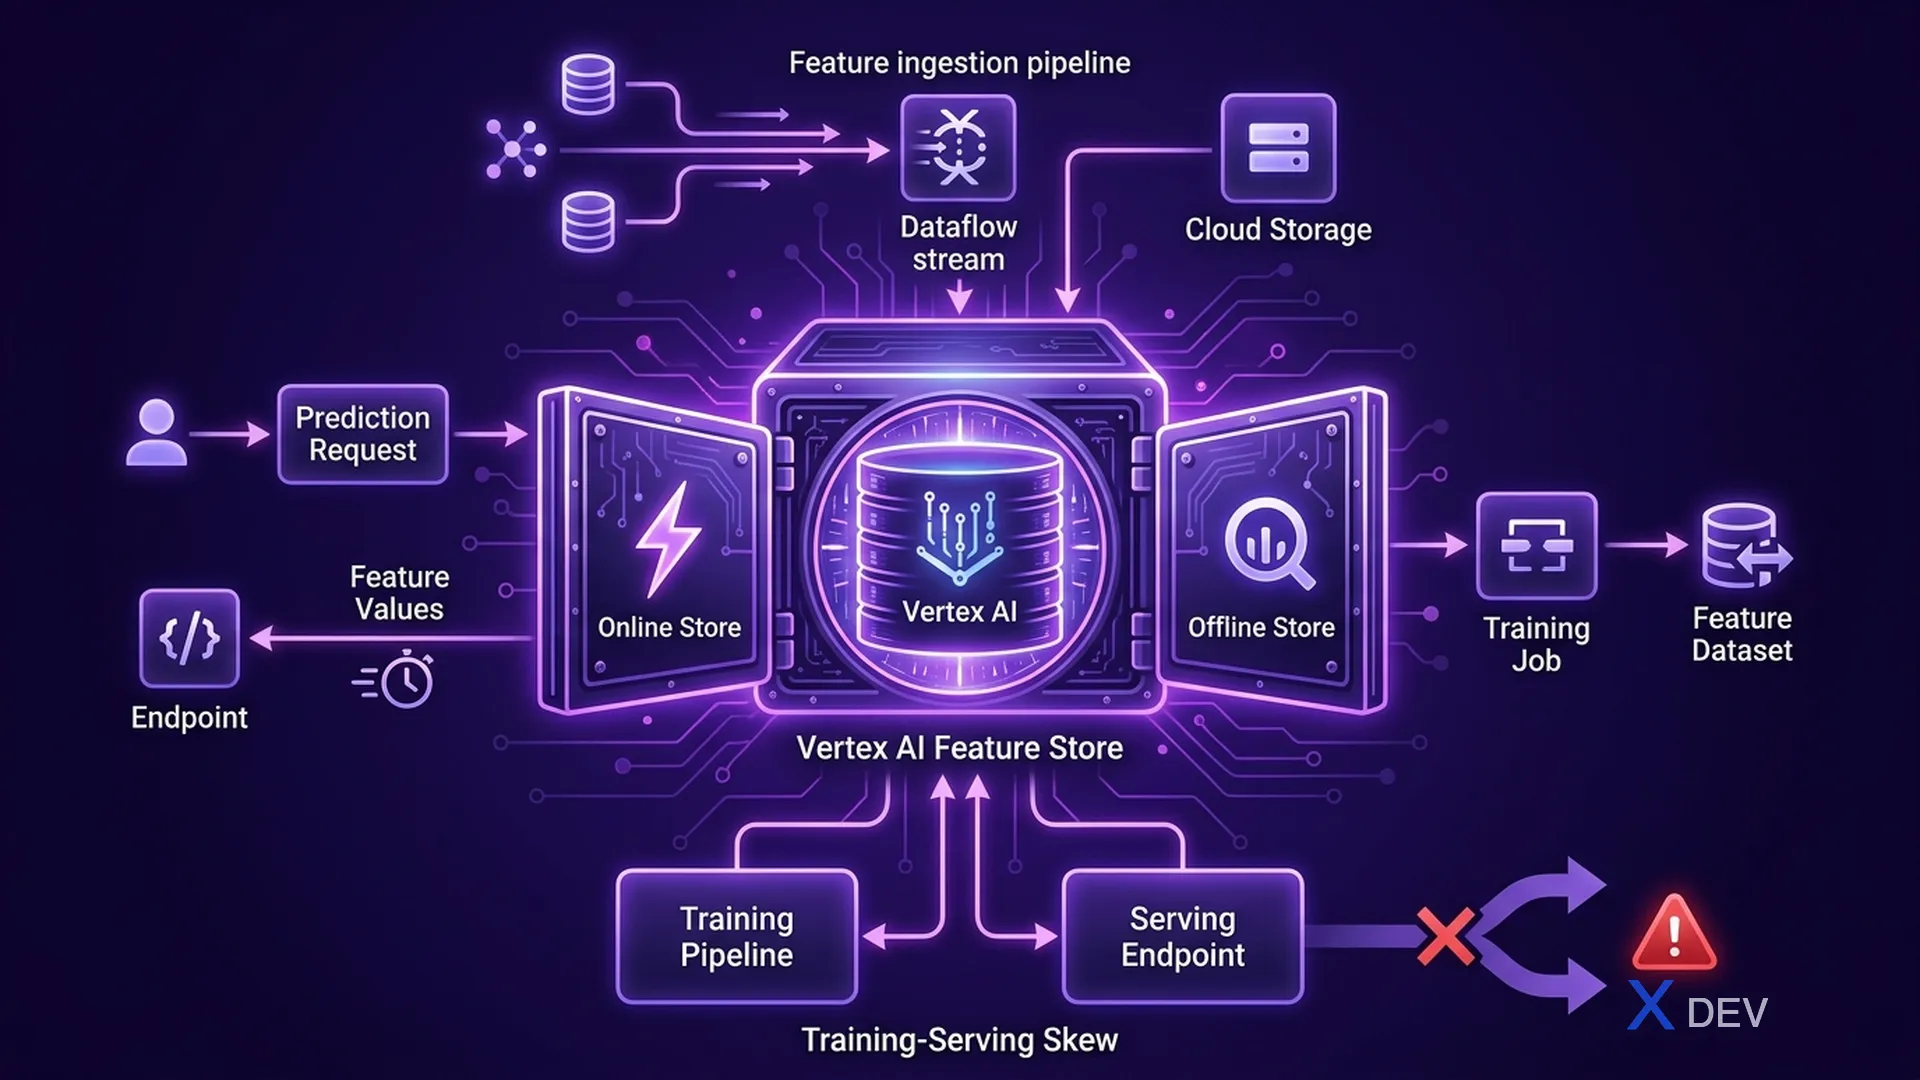
特徴量エンジニアリングとVertex AI Feature Store:ML向け特徴量の作成、保存、再利用
1. 特徴量エンジニアリング技法
| 技法 | 使用場面 | 例 |
|---|---|---|
| 正規化(Min-Max) | 有界範囲が必要(0-1) | 画像ピクセル、確率 |
| 標準化(Zスコア) | 正規分布に近い、境界なし | 顧客年齢、取引金額 |
| 対数変換 | 偏った分布(価格、給与) | 住宅のLog(price) |
| One-Hotエンコーディング | 名義カテゴリカル(順序なし) | 国、ブランド、色 |
| ラベルエンコーディング | 順序カテゴリカル(順序あり) | Low/Medium/High → 0/1/2 |
| 特徴量クロス | 特徴量間の相互作用を捕捉 | city × day_of_week |
| バケット化 | 連続値をカテゴリカルに変換 | Age → age_group |
| エンベディング | 高カーディナリティのカテゴリカル | UserID、ProductID |
2. 欠損値の処理
| 戦略 | 使用場面 |
|---|---|
| 平均値/中央値補完 | 数値型、欠損率が低い場合 |
| 最頻値補完 | カテゴリカル特徴量 |
| モデルベースの補完 | 欠損率が高い、複雑なパターン |
| インジケータ変数 | 欠損自体が情報を持つ(is_missingフラグを追加) |
| 行の削除 | ターゲットの欠損/影響を受ける行が非常に少ない |
| 列の削除 | 80%以上が欠損 |
3. 学習-推論スキュー
学習-推論スキューは深刻な問題です。特徴量が学習時と推論時で異なる方法で計算されるため、テスト指標が良好でも本番環境でモデルのパフォーマンスが低下します。
Training-Serving Skew Example:

TRAINING TIME:
  avg_purchase_last_30d = mean(all purchases in batch)  ← computed over full period

SERVING TIME:
  avg_purchase_last_30d = mean(last 5 purchases)        ← computed differently!

Result: Feature distribution mismatch → poor predictions

SOLUTION: Vertex AI Feature Store
  Same feature serve logic used at training AND serving time
4. Vertex AI Feature Store
| コンポーネント | 説明 |
|---|---|
| Feature Store | ML特徴量の集中型リポジトリ |
| Entity Type | 追跡する対象のカテゴリ(User、Product) |
| Feature | エンティティの名前付き属性(user.avg_spend) |
| Online Store | 低レイテンシサービング(ms)、リアルタイム予測用 |
| Offline Store | BigQueryバックエンド、バッチトレーニングデータ取得用 |
Vertex AI Feature Store Architecture:

Feature Ingestion (Batch or Streaming)
        ↓
┌──── Feature Store ────────────────┐
│  Offline Store (BigQuery)          │  ← Training data export
│  Online Store (Bigtable-backed)    │  ← Serving (ms latency)
└───────────────────────────────────┘
        ↑ Same features ↑
  Training      Inference
  Pipeline      Endpoint
5. BigQueryによる特徴量エンジニアリング
BigQueryはGCP上で大規模データセットから集約特徴量を計算するための最適なツールです。
| 特徴量パターン | BigQueryのアプローチ |
|---|---|
| ローリングウィンドウ集約 | ウィンドウ関数:AVG() OVER (PARTITION BY ... ORDER BY ... ROWS BETWEEN ...) |
| ユーザーアクティビティカウント | COUNT() GROUP BY user_id |
| カテゴリカルエンコーディング | CASE WHEN ... または ML.ONE_HOT_ENCODE() |
| ハッシュエンベディング(高カーディナリティ) | FARM_FINGERPRINT() mod N |
| 特徴量の正規化 | BigQuery MLのML.STANDARD_SCALER() |
試験のヒント: 「学習-推論の一貫性」や「複数モデル間での特徴量の再利用」→ Vertex AI Feature Store。「BigQueryデータから大規模に特徴量を計算」→ BigQueryウィンドウ関数 + スケジュールクエリ。
6. 特徴量ドリフトモニタリング
| タイプ | 何が変化するか | 検出方法 |
|---|---|---|
| 特徴量スキュー | 学習時と推論時の特徴量分布が異なる | 学習ベースラインと推論統計の比較 |
| 特徴量ドリフト | 推論時の特徴量が時間とともに変化する | 推論時の特徴量分布を毎日モニタリング |
| ラベルドリフト | ターゲット変数の分布が変化する | 予測分布のシフトを追跡 |
7. 練習問題
Q1: チームのMLモデルはテスト時に優れた精度を示しましたが、本番環境ではパフォーマンスが低下しています。調査の結果、平均購入額の特徴量がトレーニング時(過去のバッチデータを使用)とサービング時(リアルタイムルックアップを使用)で異なる方法で計算されていることが判明しました。この問題は何と呼ばれ、どのように解決すべきでしょうか?
- A) モデルドリフト — モデルをより頻繁に再トレーニングする
- B) 学習-推論スキュー — Vertex AI Feature Storeを使用する ✓
- C) データリーケージ — 購入額の特徴量を削除する
- D) 過学習 — ドロップアウト層を追加する
解説:学習-推論スキューは、特徴量が学習時と推論時で異なる方法で計算される場合に発生します。Vertex AI Feature Storeは、特徴量計算のための単一の信頼できるソースを提供し、学習データのエクスポートとオンラインサービングの両方で同じロジックが使用されることを保証します。
Q2: ある特徴量の値が$10から$10,000,000の範囲で、強い右偏りの分布を持っています。線形モデルで使用する前に最も適切な変換はどれでしょうか?
- A) One-Hotエンコーディング
- B) Min-Max正規化
- C) 対数変換 ✓
- D) ラベルエンコーディング
解説:対数変換は偏った分布のスケールを圧縮し、より正規分布に近い形にして線形モデルに適したものにします。Min-Max正規化では偏りが保持されます。One-Hotエンコーディングはカテゴリカルデータ用です。
Q3: リアルタイム予測エンドポイントにミリ秒レベルのレイテンシで特徴量を提供するために最適化されたVertex AI Feature Storeのストアタイプはどれでしょうか?
- A) Offline Store(BigQuery)
- B) Online Store(Bigtableバックエンド) ✓
- C) Feature Catalog
- D) Cloud Memorystore
解説:Vertex AI Feature StoreのOnline StoreはBigtableバックエンドで、100ms未満のレイテンシルックアップ向けに設計されており、リアルタイム予測エンドポイントに最新の特徴量値を提供します。Offline StoreはBigQueryを使用し、バッチトレーニングデータの取得用です。