特徵工程與Vertex AI Feature Store:為ML建立、儲存與重複使用特徵
1. 特徵工程技術
| 技術 | 使用時機 | 範例 |
|---|---|---|
| 正規化(Min-Max) | 需要有界範圍(0-1) | 影像像素、機率 |
| 標準化(Z分數) | 接近常態分佈、無界限 | 客戶年齡、交易金額 |
| 對數轉換 | 偏態分佈(價格、薪資) | 住宅的Log(price) |
| One-Hot編碼 | 名目類別(無順序) | 國家、品牌、顏色 |
| 標籤編碼 | 有序類別(有順序) | Low/Medium/High → 0/1/2 |
| 特徵交叉 | 捕捉特徵間的交互作用 | city × day_of_week |
| 桶化 | 將連續值轉換為類別 | Age → age_group |
| 嵌入 | 高基數類別 | UserID、ProductID |
2. 缺失值處理
| 策略 | 使用時機 |
|---|---|
| 平均值/中位數填補 | 數值型、缺失率低 |
| 眾數填補 | 類別型特徵 |
| 基於模型的填補 | 缺失率高、複雜模式 |
| 指標變數 | 缺失本身具有資訊價值(新增is_missing旗標) |
| 刪除列 | 目標缺失/受影響的列非常少 |
| 刪除欄 | 超過80%缺失 |
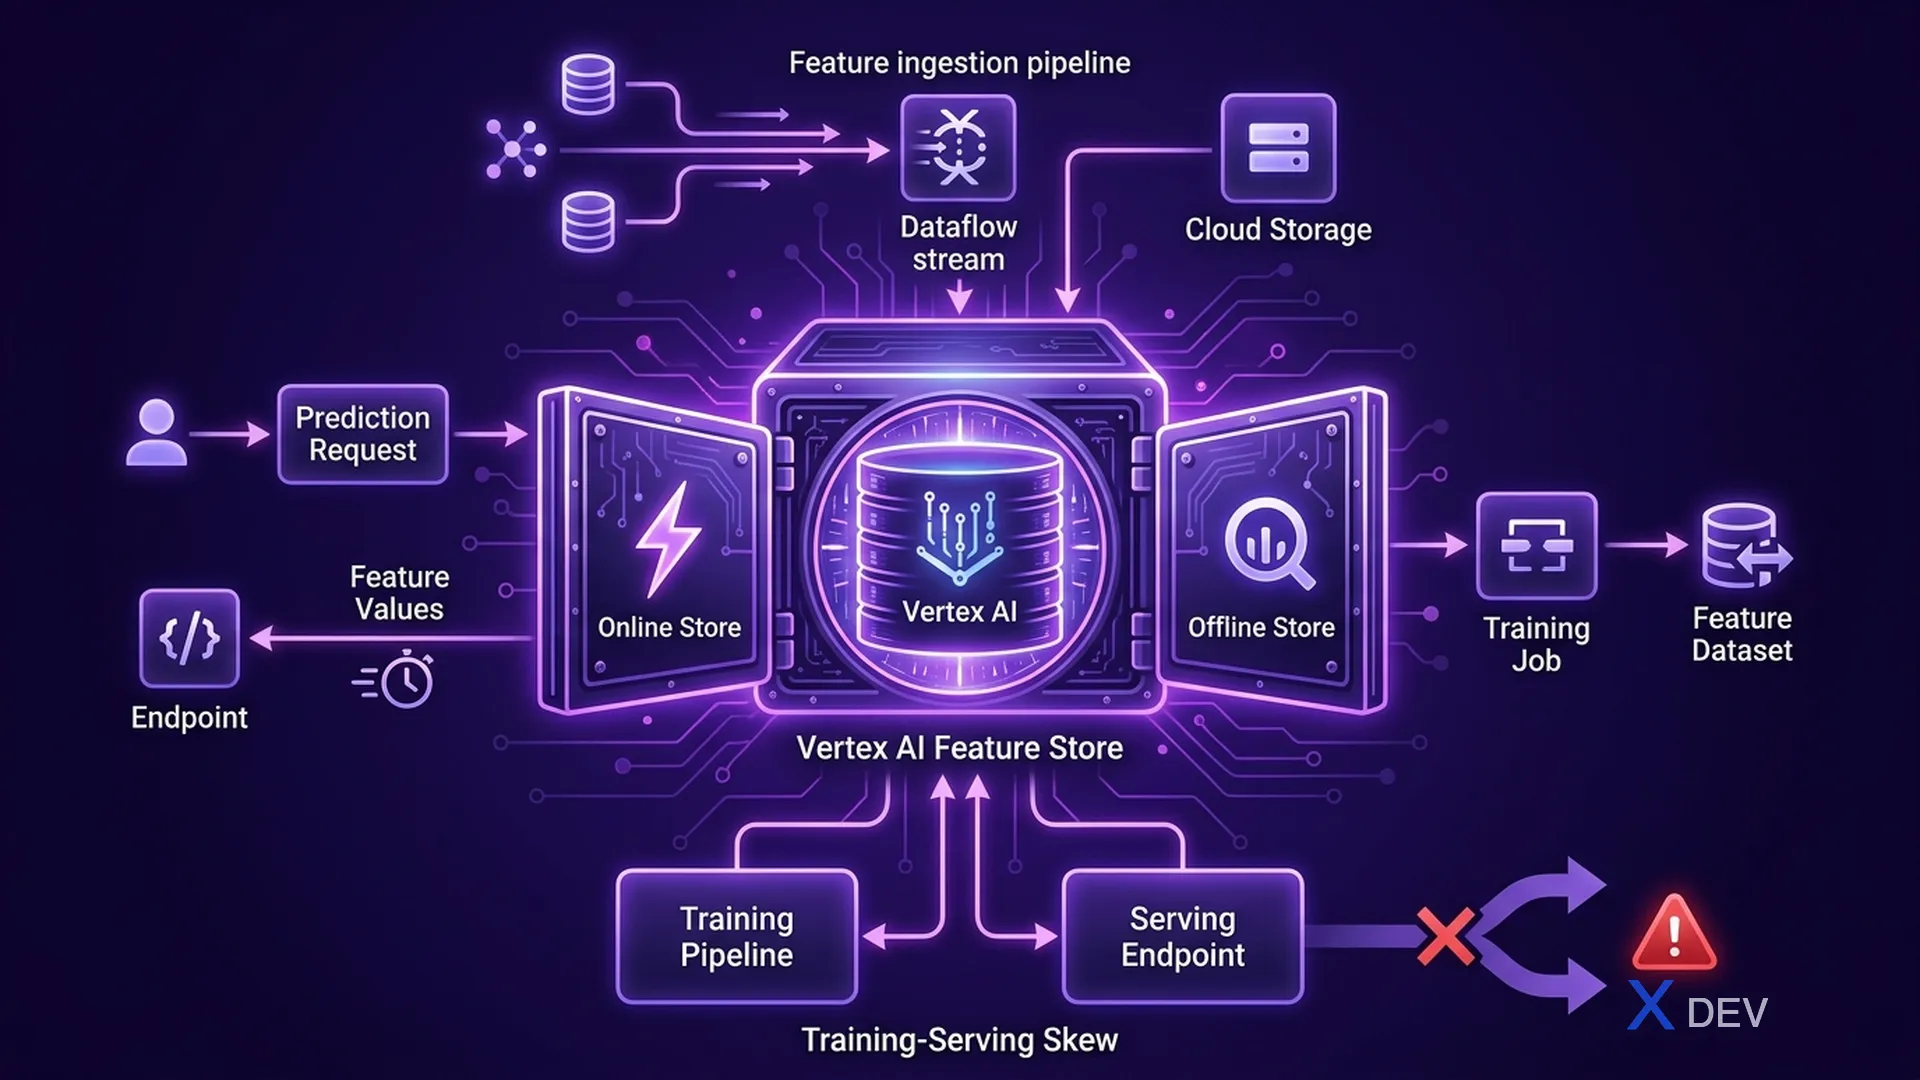
3. 訓練-推論偏移
訓練-推論偏移是一個嚴重的問題:特徵在訓練和推論時以不同方式計算,導致模型在生產環境中表現不佳,即使測試指標很好。
Training-Serving Skew Example:

TRAINING TIME:
  avg_purchase_last_30d = mean(all purchases in batch)  ← computed over full period

SERVING TIME:
  avg_purchase_last_30d = mean(last 5 purchases)        ← computed differently!

Result: Feature distribution mismatch → poor predictions

SOLUTION: Vertex AI Feature Store
  Same feature serve logic used at training AND serving time
4. Vertex AI Feature Store
| 元件 | 說明 |
|---|---|
| Feature Store | ML特徵的集中式儲存庫 |
| Entity Type | 追蹤對象的類別(User、Product) |
| Feature | 實體的命名屬性(user.avg_spend) |
| Online Store | 低延遲服務(毫秒),用於即時預測 |
| Offline Store | BigQuery支援,用於批次訓練資料擷取 |
Vertex AI Feature Store Architecture:

Feature Ingestion (Batch or Streaming)
        ↓
┌──── Feature Store ────────────────┐
│  Offline Store (BigQuery)          │  ← Training data export
│  Online Store (Bigtable-backed)    │  ← Serving (ms latency)
└───────────────────────────────────┘
        ↑ Same features ↑
  Training      Inference
  Pipeline      Endpoint
5. BigQuery進行特徵工程
BigQuery是GCP上從大型資料集計算聚合特徵的最佳工具。
| 特徵模式 | BigQuery方法 |
|---|---|
| 滾動視窗聚合 | 視窗函數:AVG() OVER (PARTITION BY ... ORDER BY ... ROWS BETWEEN ...) |
| 使用者活動計數 | COUNT() GROUP BY user_id |
| 類別編碼 | CASE WHEN ... 或 ML.ONE_HOT_ENCODE() |
| 雜湊嵌入(高基數) | FARM_FINGERPRINT() mod N |
| 特徵正規化 | BigQuery ML的ML.STANDARD_SCALER() |
考試提示: 「訓練-推論一致性」或「跨多個模型重複使用特徵」→ Vertex AI Feature Store。「從BigQuery資料大規模計算特徵」→ BigQuery視窗函數 + 排程查詢。
6. 特徵漂移監控
| 類型 | 什麼改變了 | 偵測方法 |
|---|---|---|
| 特徵偏移 | 訓練與推論的特徵分佈不同 | 比較訓練基準線與推論統計 |
| 特徵漂移 | 推論特徵隨時間變化 | 每日監控推論特徵分佈 |
| 標籤漂移 | 目標變數分佈改變 | 追蹤預測分佈的變化 |
7. 練習題
Q1: 團隊的ML模型在測試期間表現出色,但在生產環境中表現不佳。調查發現,平均購買金額特徵在訓練時(使用歷史批次資料)和推論時(使用即時查詢)的計算方式不同。這個問題叫什麼?應如何解決?
- A) 模型漂移 — 更頻繁地重新訓練模型
- B) 訓練-推論偏移 — 使用Vertex AI Feature Store ✓
- C) 資料洩漏 — 移除購買金額特徵
- D) 過擬合 — 新增dropout層
解說:訓練-推論偏移發生在特徵在訓練時和推論時以不同方式計算。Vertex AI Feature Store透過提供特徵計算的單一事實來源來解決此問題,確保訓練資料匯出和線上服務都使用相同的邏輯。
Q2: 某個特徵的值範圍從$10到$10,000,000,分佈嚴重右偏。在線性模型中使用此特徵之前,最合適的轉換是什麼?
- A) One-Hot編碼
- B) Min-Max正規化
- C) 對數轉換 ✓
- D) 標籤編碼
解說:對數轉換壓縮高度偏態分佈的尺度,使其更接近常態分佈,適合線性模型。Min-Max正規化仍然保留偏態。One-Hot編碼用於類別資料。
Q3: Vertex AI Feature Store中哪種儲存類型針對以毫秒級延遲向即時預測端點提供特徵進行了最佳化?
- A) Offline Store(BigQuery)
- B) Online Store(Bigtable支援) ✓
- C) Feature Catalog
- D) Cloud Memorystore
解說:Vertex AI Feature Store的Online Store由Bigtable支援,專為100毫秒以下的延遲查詢而設計,向即時預測端點提供最新的特徵值。Offline Store使用BigQuery,用於批次訓練資料擷取。