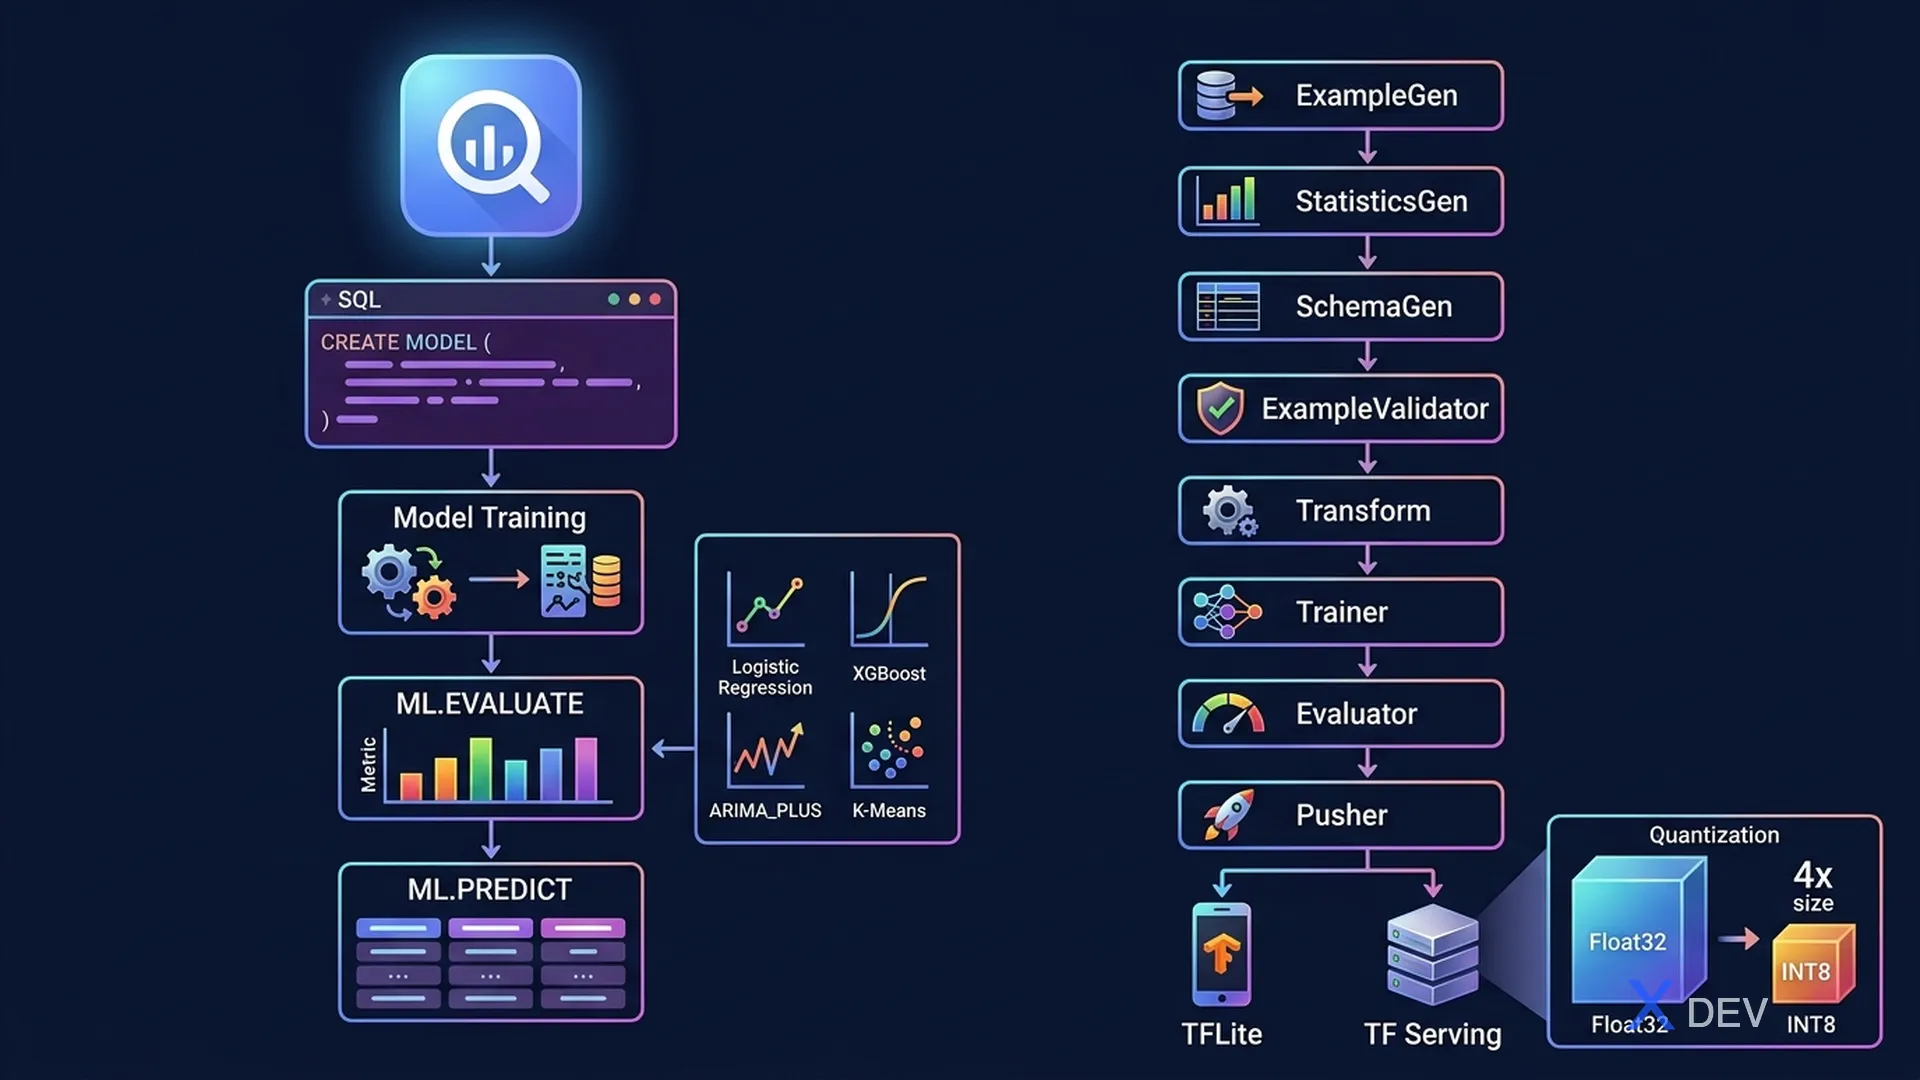
BigQuery MLとTFXパイプライン:SQLによるモデルトレーニング、モデル最適化、本番MLパイプライン
1. BigQuery ML(BQML)
BigQuery MLは、データアナリストがBigQuery内でSQLを使用してMLモデルのトレーニングとサービングを行えるようにします — データのエクスポートやMLフレームワークの知識は不要です。
BigQuery ML Workflow:

1. CREATE MODEL → train
2. ML.EVALUATE() → evaluate metrics
3. ML.PREDICT() → generate predictions
4. ML.EXPLAIN_PREDICT() → SHAP-based explanations
5. EXPORT MODEL → export to Cloud Storage (TF SavedModel format)
| モデルタイプ | BQMLオプション | タスク |
|---|---|---|
| 線形回帰 | LINEAR_REG | 回帰 |
| ロジスティック回帰 | LOGISTIC_REG | 二値/多値分類 |
| K-Means | KMEANS | クラスタリング |
| XGBoost | BOOSTED_TREE_CLASSIFIER / BOOSTED_TREE_REGRESSOR | テーブルデータの分類/回帰 |
| Random Forest | RANDOM_FOREST_CLASSIFIER / RANDOM_FOREST_REGRESSOR | テーブルデータの分類/回帰 |
| DNN | DNN_CLASSIFIER / DNN_REGRESSOR | 複雑なパターン |
| Wide & Deep | WIDE_AND_DEEP_CLASSIFIER | レコメンデーション(記憶 + 汎化) |
| AutoML | AUTOML_CLASSIFIER / AUTOML_REGRESSOR | 自動モデル選択 |
| 時系列 | ARIMA_PLUS | 予測 |
| 行列分解 | MATRIX_FACTORIZATION | 協調フィルタリング |
試験のヒント: BQML ARIMA_PLUSは季節性、休日効果、トレンド分解を自動的に処理します。「BigQueryデータを使って予測」→ ARIMA_PLUS。「BigQueryでのレコメンデーションシステム」→ MATRIX_FACTORIZATION。
2. TensorFlow Extended(TFX)
TFXはTensorFlow向けの本番MLパイプラインライブラリです。MLライフサイクルの各ステップに標準コンポーネントを提供します。
| TFXコンポーネント | 目的 |
|---|---|
| ExampleGen | CSV、BigQuery、Avro、Parquetからのデータ取り込み |
| StatisticsGen | トレーニングデータの統計情報を計算 |
| SchemaGen | 統計情報からスキーマを推論 |
| ExampleValidator | 異常の検出:欠損、分布スキュー |
| Transform | 特徴量エンジニアリング(Apache Beamベース) |
| Trainer | TFモデルのトレーニング(EvalSpec + TrainSpec) |
| Tuner | ハイパーパラメータチューニング(KerasTuner) |
| Evaluator | ベースラインに対するモデルの評価 |
| ModelValidator | モデルが品質閾値を満たしているか検証 |
| Pusher | サービングへのモデルプッシュ(TF Serving、Vertex AI) |
TFX Pipeline (simplified):

ExampleGen → StatisticsGen → SchemaGen → ExampleValidator
                ↓
            Transform (feature engineering)
                ↓
            Trainer (model training)
                ↓
            Evaluator (metrics vs baseline)
                ↓ (if pass)
            Pusher → TF Serving / Vertex AI Endpoint
3. TF ServingとTFLite
| オプション | ユースケース |
|---|---|
| TF Serving | サーバー/クラウドでの高性能サービング(gRPCまたはREST) |
| TFLite | モバイルデバイス、エッジデバイス、マイクロコントローラー |
| TF.js | ブラウザベースの推論 |
4. モデル最適化技法
| 技法 | 説明 | トレードオフ |
|---|---|---|
| 量子化 | Float32 → INT8の重み変換 | 4倍小さく、約2倍高速、わずかな精度低下 |
| 枝刈り | 低い重みの接続を削除 | モデルの小型化、精度を維持 |
| 知識蒸留 | 大きな「教師」モデルから小さな「生徒」モデルを訓練 | より小さく高速、わずかな精度低下 |
| TensorRT | NVIDIA GPU最適化(レイヤー融合) | NVIDIA GPUで推論3-5倍高速化 |
5. 練習問題
Q1: データアナリストチームがBigQueryに既にあるデータで売上予測モデルを構築する必要があります。SQLに精通していますが、Python/MLフレームワークの経験はありません。時系列予測にどのBigQuery MLモデルタイプを使用すべきでしょうか?
- A) KMEANS
- B) LOGISTIC_REG
- C) ARIMA_PLUS ✓
- D) MATRIX_FACTORIZATION
解説:BigQuery ML ARIMA_PLUSは時系列予測用に設計されており、季節性、トレンド、休日効果を自動的に処理します。SQLの簡単なCREATE MODEL文でトレーニングでき、Pythonの専門知識は不要です。
Q2: TFXパイプラインが、新しい本番データの「age」特徴量の分布がトレーニングデータの分布と大きく異なることを検出しています。この異常の検出を担当するTFXコンポーネントはどれでしょうか?
- A) StatisticsGen
- B) SchemaGen
- C) ExampleValidator ✓
- D) Transform
解説:ExampleValidatorはデータ統計を期待されるスキーマと比較し、分布スキュー(トレーニングデータとサービングデータの分布の顕著な差異)を含む異常をフラグします。StatisticsGenは統計を計算し、SchemaGenはスキーマを作成し、Transformは特徴量エンジニアリングを行います。
Q3: チームが計算リソースが限られたモバイルデバイスにTensorFlow画像分類モデルをデプロイする必要があります。精度の損失を最小限に抑えながらモデルサイズを4倍に削減する必要があります。どの技法を適用すべきでしょうか?
- A) 知識蒸留
- B) モデル枝刈り
- C) 学習後量子化(INT8) ✓
- D) TensorRT最適化
解説:学習後量子化はFloat32の重みをINT8に変換し、モデルサイズを約4倍削減し、推論速度を2倍向上させます。ほとんどのモデルで精度の損失は最小限です。TFLiteはモバイル/エッジデプロイメント向けのINT8量子化をサポートしています。TensorRTはモバイルではなくNVIDIA GPU向けです。