BigQuery ML與TFX管線:使用SQL訓練模型、模型最佳化與生產ML管線
1. BigQuery ML(BQML)
BigQuery ML允許資料分析師使用SQL在BigQuery中訓練和服務ML模型——不需要匯出資料,不需要了解ML框架。
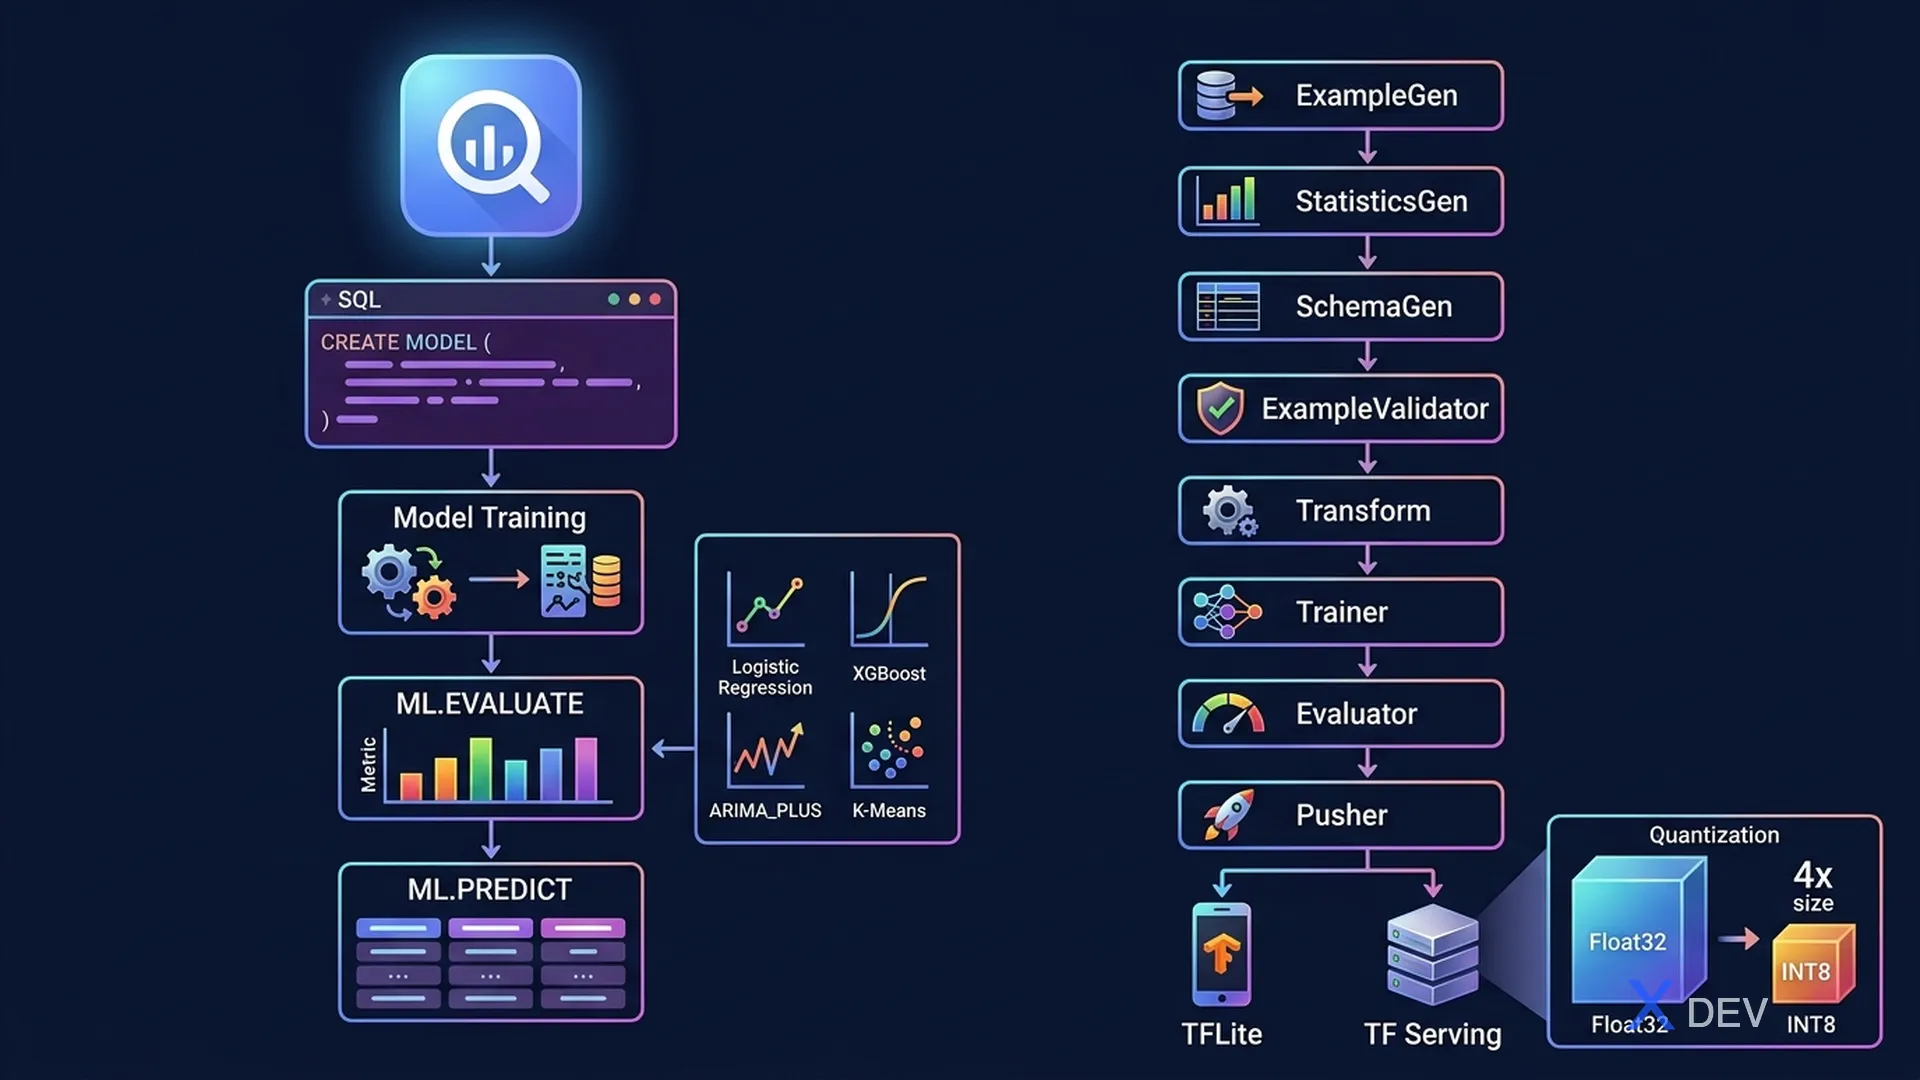
BigQuery ML Workflow:

1. CREATE MODEL → train
2. ML.EVALUATE() → evaluate metrics
3. ML.PREDICT() → generate predictions
4. ML.EXPLAIN_PREDICT() → SHAP-based explanations
5. EXPORT MODEL → export to Cloud Storage (TF SavedModel format)
| 模型類型 | BQML選項 | 任務 |
|---|---|---|
| 線性迴歸 | LINEAR_REG | 迴歸 |
| 邏輯迴歸 | LOGISTIC_REG | 二元/多類別分類 |
| K-Means | KMEANS | 聚類 |
| XGBoost | BOOSTED_TREE_CLASSIFIER / BOOSTED_TREE_REGRESSOR | 表格資料分類/迴歸 |
| 隨機森林 | RANDOM_FOREST_CLASSIFIER / RANDOM_FOREST_REGRESSOR | 表格資料分類/迴歸 |
| DNN | DNN_CLASSIFIER / DNN_REGRESSOR | 複雜模式 |
| Wide & Deep | WIDE_AND_DEEP_CLASSIFIER | 推薦系統(記憶 + 泛化) |
| AutoML | AUTOML_CLASSIFIER / AUTOML_REGRESSOR | 自動模型選擇 |
| 時間序列 | ARIMA_PLUS | 預測 |
| 矩陣分解 | MATRIX_FACTORIZATION | 協同過濾 |
考試提示: BQML ARIMA_PLUS自動處理季節性、假日效應、趨勢分解。題目問「使用BigQuery資料進行預測」→ ARIMA_PLUS。問「BigQuery中的推薦系統」→ MATRIX_FACTORIZATION。
2. TensorFlow Extended(TFX)
TFX是TensorFlow的生產ML管線函式庫。為ML生命週期中的每個步驟提供標準元件。
| TFX元件 | 用途 |
|---|---|
| ExampleGen | 從CSV、BigQuery、Avro、Parquet擷取資料 |
| StatisticsGen | 計算訓練資料的統計資訊 |
| SchemaGen | 從統計資訊推斷綱要 |
| ExampleValidator | 偵測異常:缺失、分佈偏移 |
| Transform | 特徵工程(基於Apache Beam) |
| Trainer | 訓練TF模型(EvalSpec + TrainSpec) |
| Tuner | 超參數調優(KerasTuner) |
| Evaluator | 與基準線比較評估模型 |
| ModelValidator | 驗證模型是否滿足品質閾值 |
| Pusher | 將模型推送到服務端(TF Serving、Vertex AI) |
TFX Pipeline (simplified):

ExampleGen → StatisticsGen → SchemaGen → ExampleValidator
                ↓
            Transform (feature engineering)
                ↓
            Trainer (model training)
                ↓
            Evaluator (metrics vs baseline)
                ↓ (if pass)
            Pusher → TF Serving / Vertex AI Endpoint
3. TF Serving與TFLite
| 選項 | 使用場景 |
|---|---|
| TF Serving | 伺服器/雲端的高效能服務(gRPC或REST) |
| TFLite | 行動裝置、邊緣裝置、微控制器 |
| TF.js | 瀏覽器端推論 |
4. 模型最佳化技術
| 技術 | 說明 | 權衡 |
|---|---|---|
| 量化 | Float32 → INT8權重 | 4倍縮小、約2倍加速、輕微精確度損失 |
| 剪枝 | 移除低權重的連接 | 更小的模型、保留精確度 |
| 知識蒸餾 | 從大型「教師」模型訓練小型「學生」模型 | 更小更快、輕微精確度損失 |
| TensorRT | NVIDIA GPU最佳化(層融合) | 在NVIDIA GPU上3-5倍推論加速 |
5. 練習題
Q1: 資料分析團隊需要對BigQuery中的資料建構銷售預測模型。他們熟悉SQL但沒有Python/ML框架經驗。應使用哪種BigQuery ML模型類型進行時間序列預測?
- A) KMEANS
- B) LOGISTIC_REG
- C) ARIMA_PLUS ✓
- D) MATRIX_FACTORIZATION
解說:BigQuery ML ARIMA_PLUS專為時間序列預測設計,自動處理季節性、趨勢和假日效應。可以用簡單的SQL CREATE MODEL語句訓練,不需要Python專業知識。
Q2: TFX管線偵測到新的生產資料中「age」特徵的分佈與訓練資料分佈有顯著差異。哪個TFX元件負責偵測此異常?
- A) StatisticsGen
- B) SchemaGen
- C) ExampleValidator ✓
- D) Transform
解說:ExampleValidator將資料統計與預期的綱要進行比較,並標記包括分佈偏移(訓練和服務資料分佈之間的顯著差異)在內的異常。StatisticsGen計算統計資訊;SchemaGen建立綱要;Transform進行特徵工程。
Q3: 團隊需要將TensorFlow影像分類模型部署到運算資源有限的行動裝置。需要將模型大小縮小4倍且精確度損失最小。應使用哪種技術?
- A) 知識蒸餾
- B) 模型剪枝
- C) 訓練後量化(INT8) ✓
- D) TensorRT最佳化
解說:訓練後量化將Float32權重轉換為INT8,將模型大小縮小約4倍,推論速度提高2倍,對大多數模型的精確度損失最小。TFLite支援INT8量化用於行動/邊緣部署。TensorRT是針對NVIDIA GPU,不適用於行動裝置。