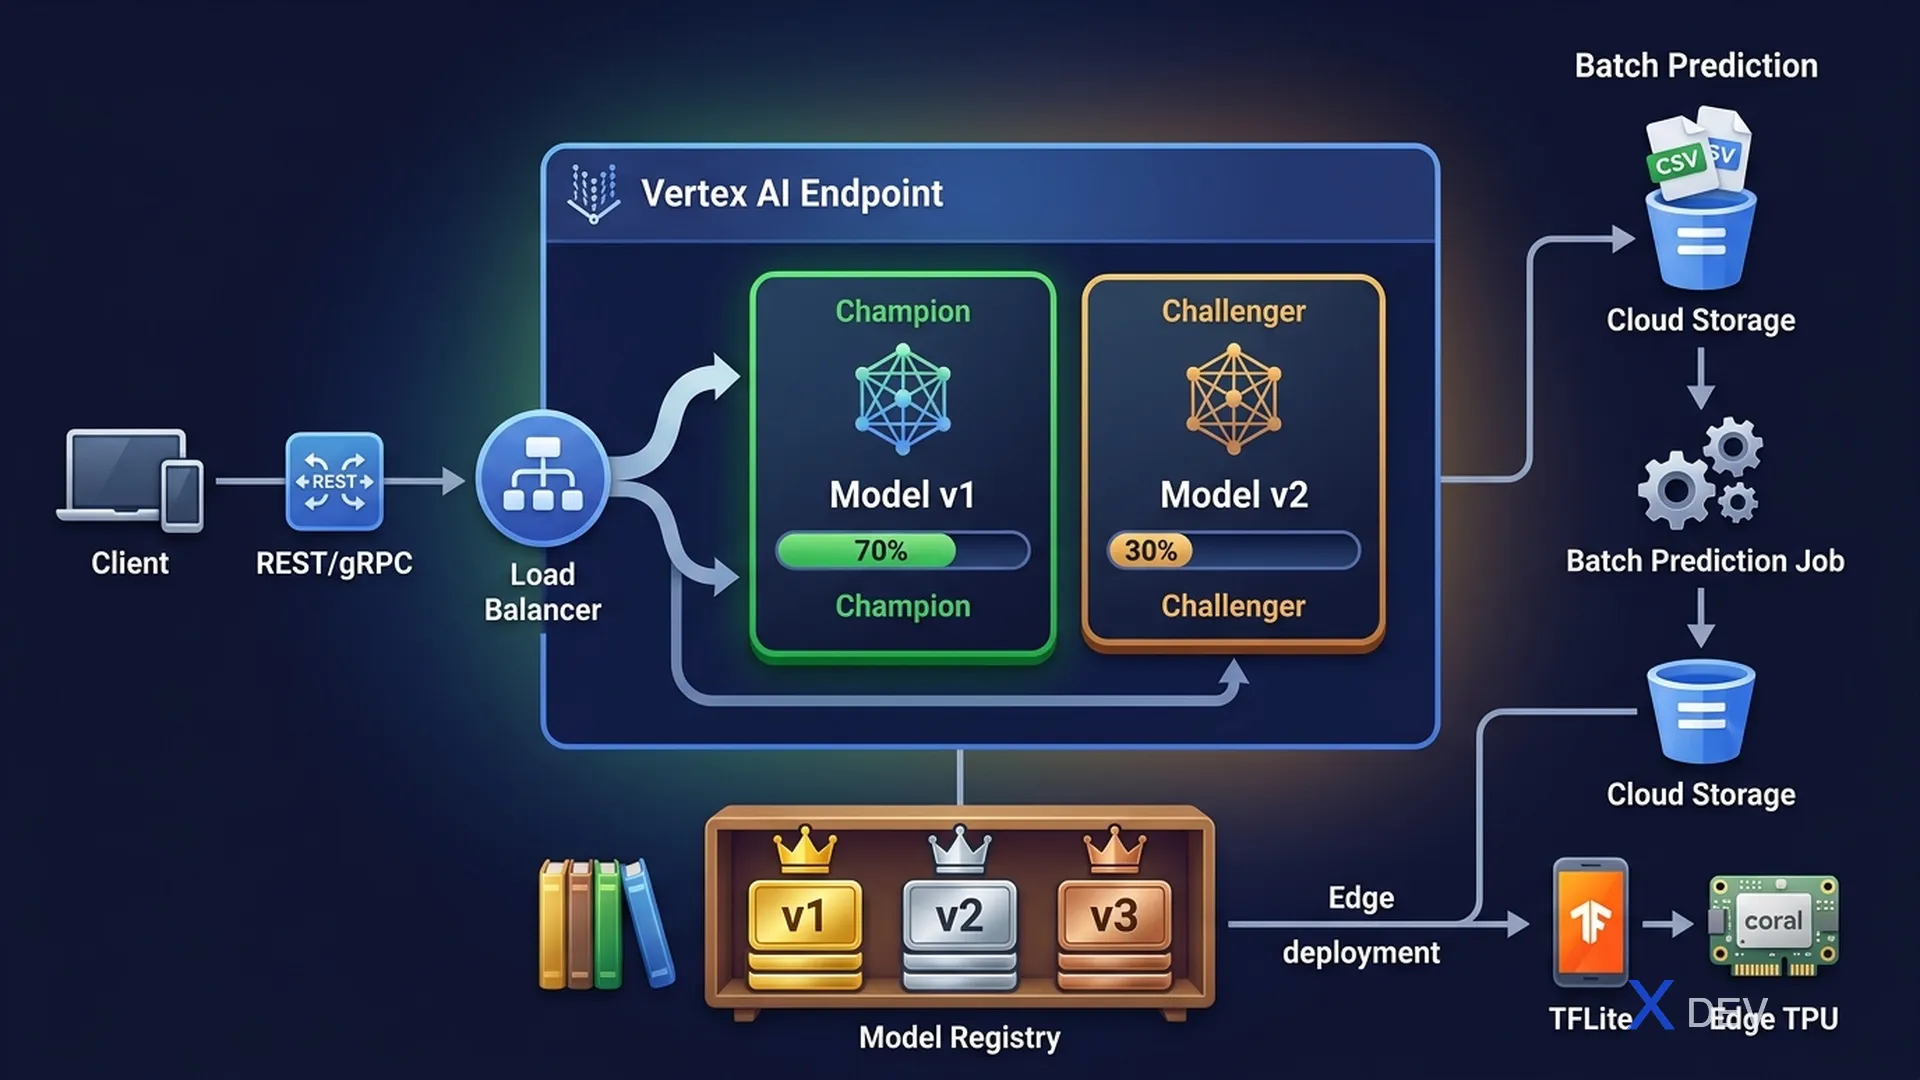
Vertex AIデプロイメント:オンライン予測、バッチ予測、トラフィック分割、エッジデプロイメント
1. Vertex AIの予測タイプ
| タイプ | レイテンシ | 使用場面 |
|---|---|---|
| オンライン予測 | ミリ秒(同期) | リアルタイムアプリ、ユーザー向けAPI |
| バッチ予測 | 分/時間(非同期) | 大規模データセット、スケジュールされたスコアリング |
| ストリーミング予測 | 準リアルタイム | Pub/Subイベント + Dataflow + Vertex AI |
2. Vertex AI Endpoints
Vertex AI Endpoint Architecture:

Client Request
    ↓
Vertex AI Endpoint (load balancer)
    ├── Model Version A (70% traffic)
    │       └── Deployed Model (e.g., v1.0)
    └── Model Version B (30% traffic)  ← Canary/A-B test
            └── Deployed Model (e.g., v1.1)
各Endpointは複数のモデルバージョンとトラフィック分割を持つことができ、A/Bテストやカナリアデプロイメントに使用されます。
| 機能 | 詳細 |
|---|---|
| 専用Endpoint | 専用リソース、最低レイテンシ、高コスト |
| 共有Endpoint | マルチテナント、低コスト、コールドスタートの可能性 |
| 説明可能性 | デプロイされたモデルごとにVertex Explainabilityを有効化 |
| 最小/最大レプリカ | リクエストレートに基づくオートスケーリング |
| GPU割り当て | デプロイメントごとにGPUタイプ(NVIDIA T4、A100)を指定 |
試験のヒント: Vertex AI Endpointsのトラフィック分割は、カナリアデプロイメントやA/Bテストの実装方法です。「新しいモデルバージョンを安全にロールアウト」→ トラフィック分割(例:90% 旧版、10% 新版)。
3. バッチ予測
| プロパティ | 値 |
|---|---|
| 入力 | Cloud Storage(CSV、JSON、JSONL、TFRecords、Avro) |
| 出力 | Cloud Storage(JSON/CSVとしての予測結果) |
| Endpoint不要 | Model Registryから直接実行、永続的なEndpoint不要 |
| オートスケーリング | 完了時にゼロにスケール(コスト効率的) |
| アクセラレータ | バッチ推論用にGPU/TPUをサポート |
4. モデルバージョニングとRegistry
Vertex AI Model Registry:

Model: churn-predictor
├── v1 (Logistic Regression)  ← Champion in production
│   - Accuracy: 0.87
│   - Deployed to: endpoint/prod (70% traffic)
│
└── v2 (XGBoost)              ← Challenger
    - Accuracy: 0.91
    - Deployed to: endpoint/prod (30% traffic)

After validation: promote v2 to Champion
5. エッジデプロイメント
| プラットフォーム | ソリューション |
|---|---|
| モバイル(Android/iOS) | TFLite + Vertex AIモデルエクスポート |
| エッジデバイス(IoT) | TFLite Micro / Edge TPU(Coral) |
| オンプレミスサーバー | Dockerコンテナ内のTF Serving |
| Kubernetes | GKE上のKServe(旧KFServing) |
6. 練習問題
Q1: ある企業が5,000万件の顧客レコードの解約リスクをスコアリングする必要があります。結果は2時間以内に必要ですが、リアルタイムである必要はありません。最もコスト効率的なVertex AI予測オプションはどれでしょうか?
- A) 高レプリカ数のオンライン予測
- B) バッチ予測 ✓
- C) Dataflowによるストリーミング予測
- D) 専用GPUエンドポイントにデプロイ
解説:バッチ予測は大規模な非同期スコアリング向けに設計されています。ジョブ中にコンピュートリソースをスケールアップし、完了時にゼロに戻すため、永続的なエンドポイントコストがかかりません。バッチスコアリングにリアルタイム応答は不要なので、オンライン予測は無駄です。
Q2: チームが新しいモデルバージョンをデプロイしています。本番トラフィックの10%を新バージョンにルーティングし、旧バージョンが90%を処理するようにして、完全なロールアウト前にパフォーマンス指標を比較したいと考えています。これを可能にするVertex AI機能はどれでしょうか?
- A) Model Registryバージョニング
- B) Vertex AI Endpointsのトラフィック分割 ✓
- C) バッチ予測の比較
- D) Vertex AI Experiments
解説:Vertex AI Endpointsは、設定可能なトラフィック分割(例:90%/10%)で複数のモデルバージョンの同時デプロイをサポートしています。これにより、完全なロールアウトを行う前にライブパフォーマンスを比較するカナリアデプロイメントやA/Bテストが可能になります。
Q3: 小売企業が、クラウドへのネットワーク接続なしで工場フロアの製品欠陥を検出したいと考えています。どのデプロイメントアプローチを使用すべきでしょうか?
- A) Vertex AIオンライン予測Endpoint
- B) TFLiteを使用してデバイスにデプロイされたAutoML Edgeモデル ✓
- C) BigQuery MLバッチ予測
- D) Cloud Run上のTF Serving
解説:TFLite(またはAutoML Edgeモデル)によるエッジデプロイメントは、ネットワーク接続なしでデバイス上でローカルに推論を実行します。TFLiteはコンピュータービジョンモデルのオンデバイス推論をサポートし、インターネットアクセスのない工場フロアの機器に適しています。