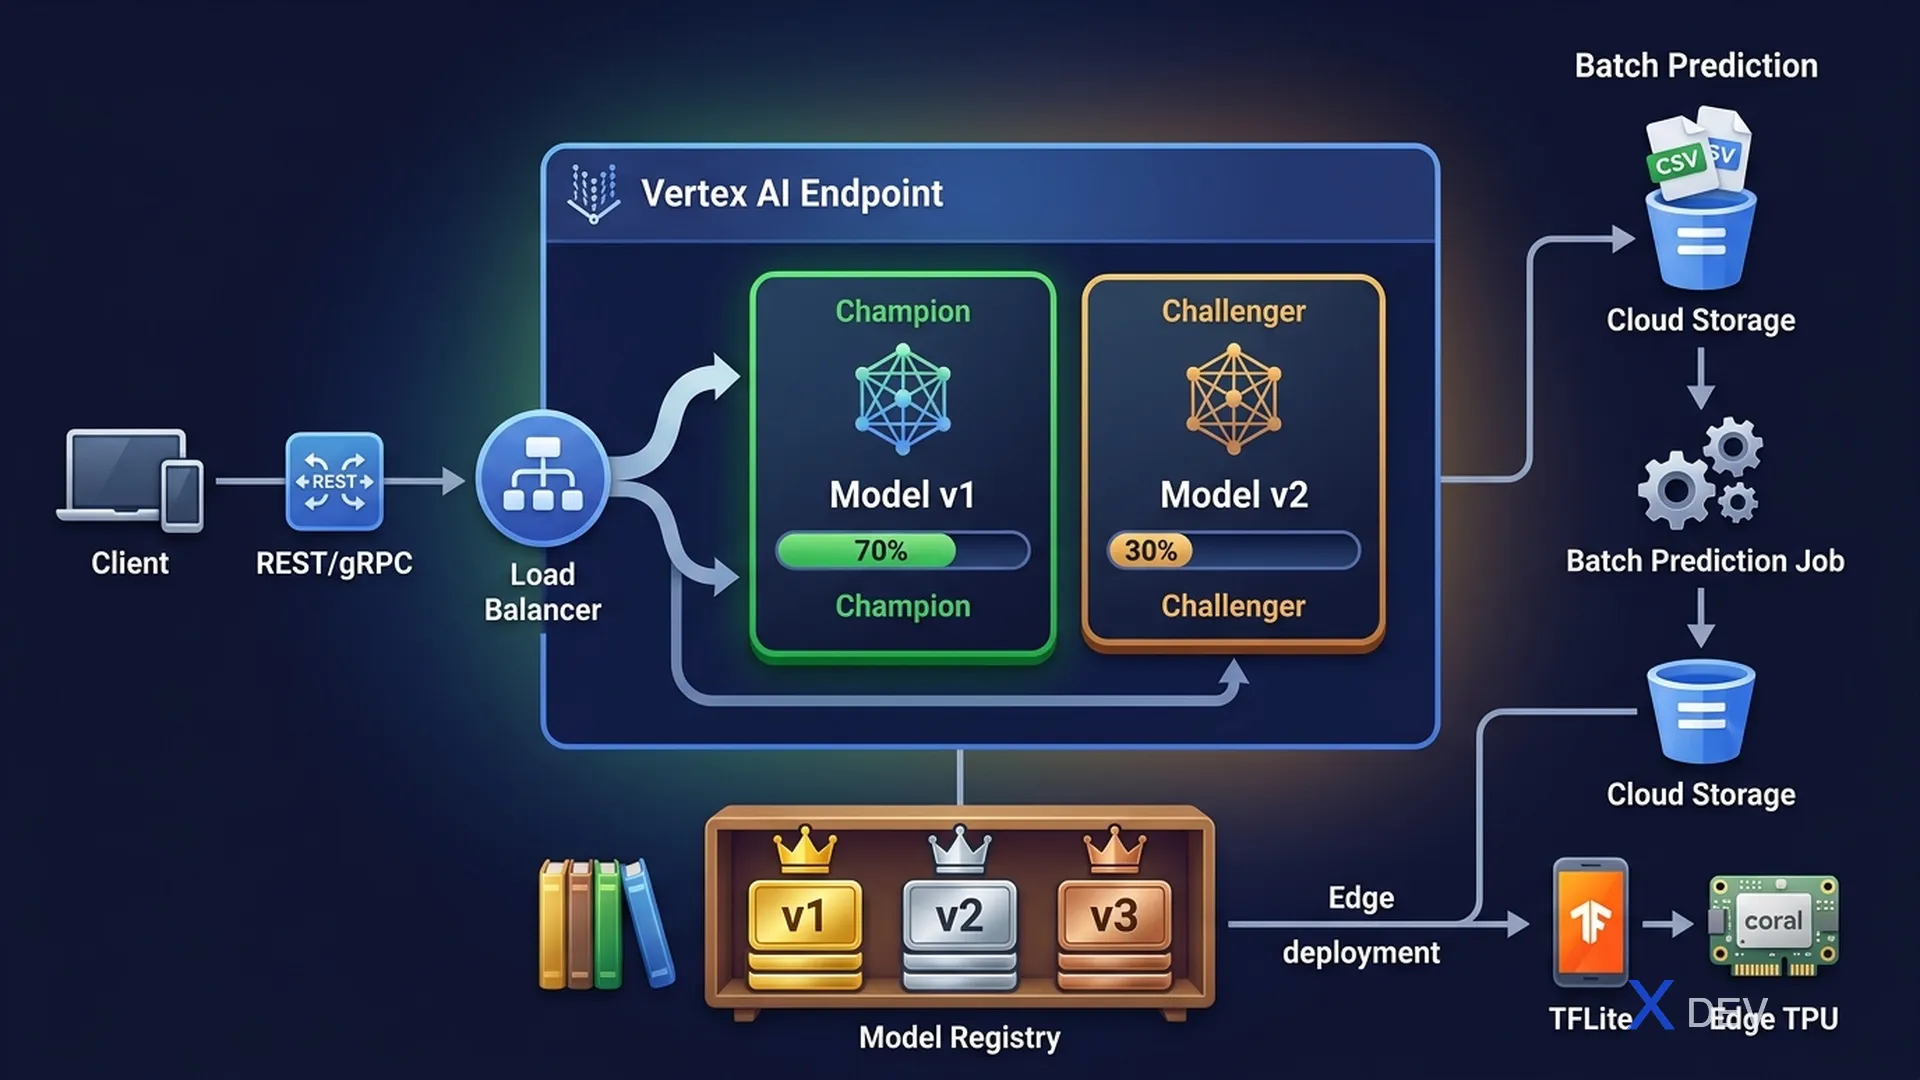
Vertex AI部署:線上預測、批次預測、流量分割與邊緣部署
1. Vertex AI上的預測類型
| 類型 | 延遲 | 使用時機 |
|---|---|---|
| 線上預測 | 毫秒級(同步) | 即時應用程式、面向使用者的API |
| 批次預測 | 分鐘/小時(非同步) | 大型資料集、排程評分 |
| 串流預測 | 近即時 | Pub/Sub事件 + Dataflow + Vertex AI |
2. Vertex AI Endpoints
Vertex AI Endpoint Architecture:

Client Request
    ↓
Vertex AI Endpoint (load balancer)
    ├── Model Version A (70% traffic)
    │       └── Deployed Model (e.g., v1.0)
    └── Model Version B (30% traffic)  ← Canary/A-B test
            └── Deployed Model (e.g., v1.1)
每個Endpoint可以有多個模型版本配合流量分割——用於A/B測試和金絲雀部署。
| 功能 | 詳細 |
|---|---|
| 專用端點 | 專用資源、最低延遲、較高成本 |
| 共享端點 | 多租戶、較低成本、可能有冷啟動 |
| 可解釋性 | 為每個部署的模型啟用Vertex Explainability |
| 最小/最大副本數 | 根據請求率自動擴展 |
| GPU分配 | 為每次部署指定GPU類型(NVIDIA T4、A100) |
考試提示: Vertex AI Endpoints的流量分割是實作金絲雀部署或A/B測試的方式。題目問「安全推出新模型版本」→ 流量分割(例如:90%舊版、10%新版)。
3. 批次預測
| 屬性 | 值 |
|---|---|
| 輸入 | Cloud Storage(CSV、JSON、JSONL、TFRecords、Avro) |
| 輸出 | Cloud Storage(JSON/CSV格式的預測結果) |
| 不需要端點 | 直接從Model Registry執行,不需要持久化端點 |
| 自動擴展 | 完成後縮減至零(成本效益高) |
| 加速器 | 支援GPU/TPU進行批次推論 |
4. 模型版本管理與Registry
Vertex AI Model Registry:

Model: churn-predictor
├── v1 (Logistic Regression)  ← Champion in production
│   - Accuracy: 0.87
│   - Deployed to: endpoint/prod (70% traffic)
│
└── v2 (XGBoost)              ← Challenger
    - Accuracy: 0.91
    - Deployed to: endpoint/prod (30% traffic)

After validation: promote v2 to Champion
5. 邊緣部署
| 平台 | 解決方案 |
|---|---|
| 行動裝置(Android/iOS) | TFLite + Vertex AI模型匯出 |
| 邊緣裝置(IoT) | TFLite Micro / Edge TPU(Coral) |
| 本地伺服器 | Docker容器中的TF Serving |
| Kubernetes | GKE上的KServe(前身KFServing) |
6. 練習題
Q1: 一家公司需要對5,000萬筆客戶記錄進行流失風險評分。結果需要在2小時內完成,但不需要即時。哪種Vertex AI預測選項最具成本效益?
- A) 高副本數的線上預測
- B) 批次預測 ✓
- C) 透過Dataflow的串流預測
- D) 部署在專用GPU端點上
解說:批次預測專為大規模非同步評分設計。在工作期間擴展運算資源,完成後縮減至零,無持久化端點成本。既然不需要即時回應,線上預測會是浪費。
Q2: 團隊正在部署新的模型版本。他們想逐步將10%的生產流量路由到新版本,而舊版本處理90%,在全面推出前比較效能指標。哪個Vertex AI功能實現此目的?
- A) Model Registry版本管理
- B) Vertex AI Endpoints流量分割 ✓
- C) 批次預測比較
- D) Vertex AI Experiments
解說:Vertex AI Endpoints支援同時部署多個模型版本,配合可設定的流量分割(例如90%/10%)。這使得金絲雀部署和A/B測試能夠在全面推出前比較即時效能。
Q3: 一家零售公司想在沒有雲端網路連線的工廠車間偵測產品缺陷。應使用哪種部署方式?
- A) Vertex AI線上預測端點
- B) 使用TFLite部署到裝置的AutoML Edge Model ✓
- C) BigQuery ML批次預測
- D) Cloud Run上的TF Serving
解說:使用TFLite(或AutoML Edge Model)的邊緣部署可以在裝置上本地執行推論,不需要網路連線。TFLite支援電腦視覺模型的裝置端推論,適合沒有網路的工廠車間設備。