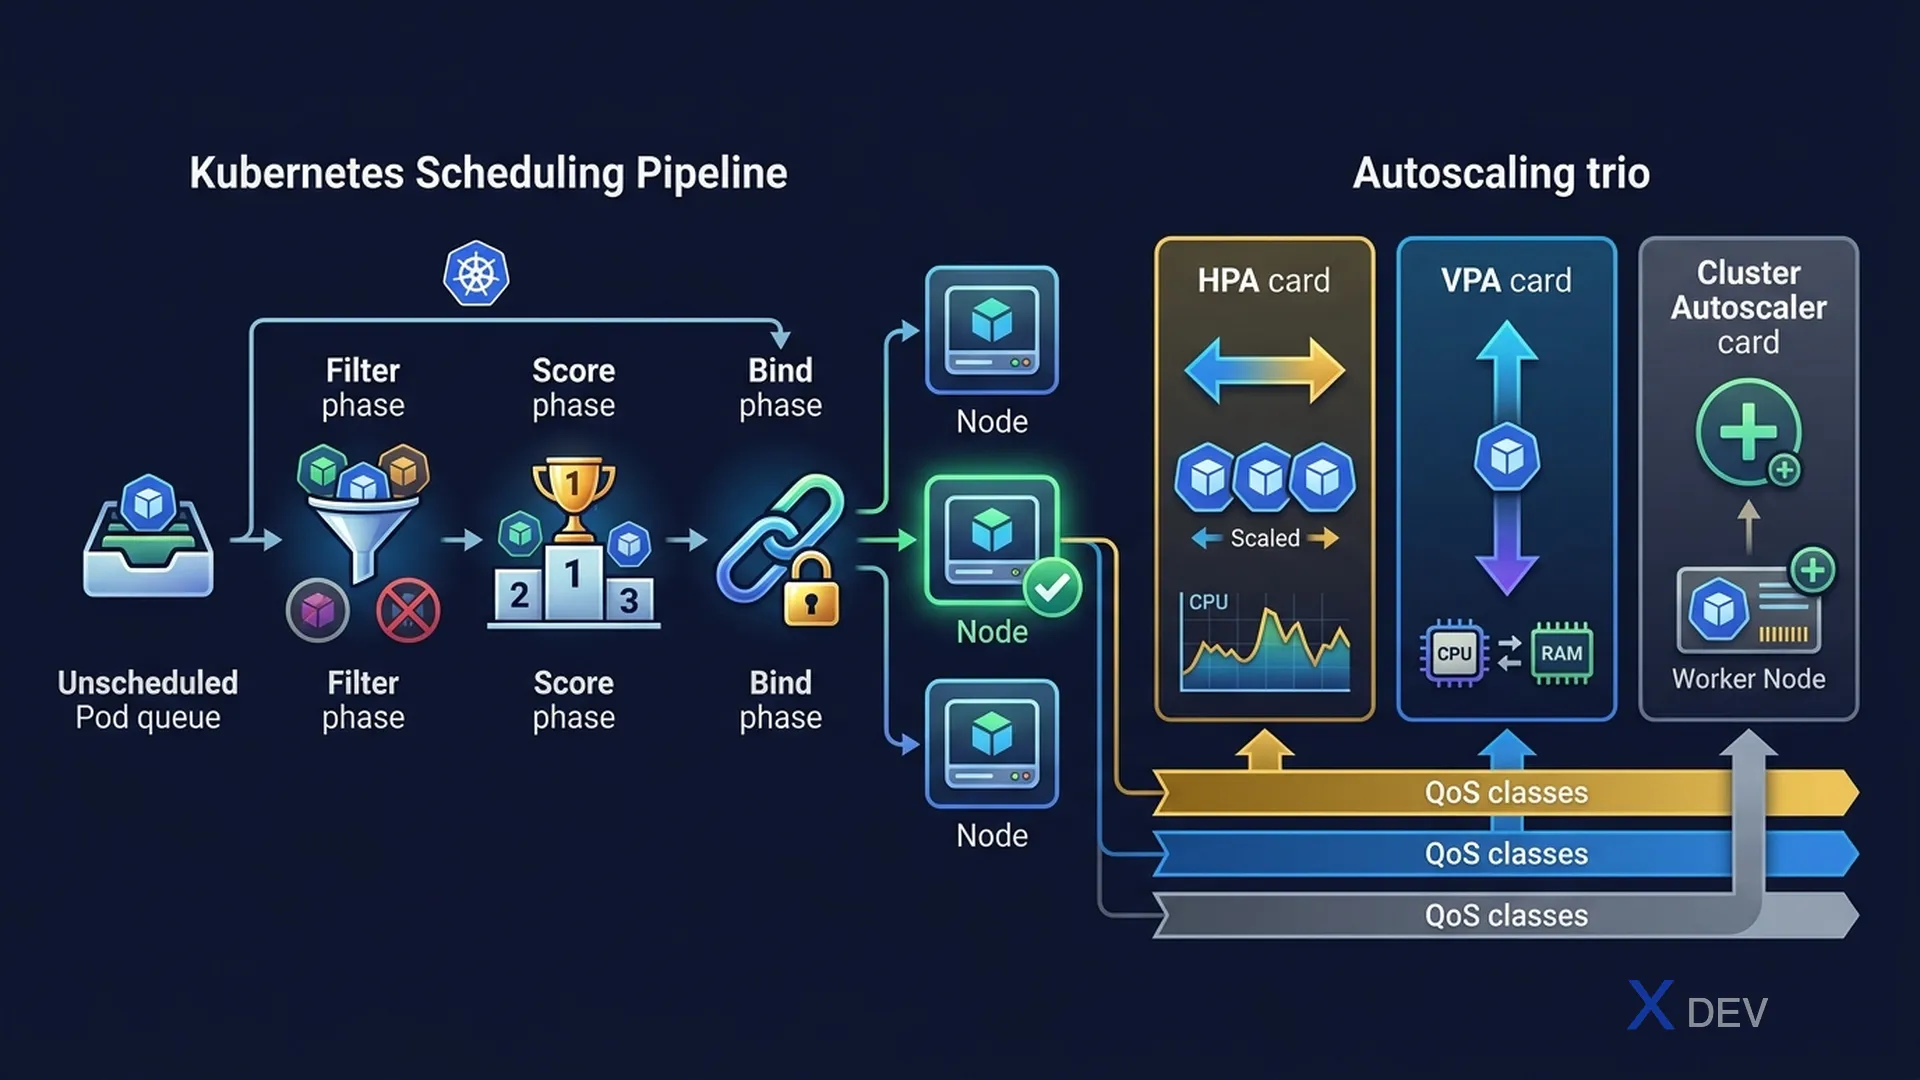
1. Kubernetesスケジューリング
Podが作成されると、kube-schedulerが2つのステップで適切なノードを選択します:
Scheduling Pipeline:
  New Pod
    │
    ▼
  1. FILTERING: 条件を満たさないノードを除外
     - CPU/メモリ不足
     - TaintにTolerationが一致しない
     - Node Affinityが一致しない
     │
    ▼
  2. SCORING: 残ったノードにスコアリング
     - リソースバランス
     - Affinityの優先度
     │
    ▼
Bind Pod → 最高スコアのNode| メカニズム | 目的 | 例 |
|---|---|---|
| NodeSelector | ラベルを持つノードにPodをスケジュール | disktype: ssd |
| Affinity/Anti-affinity | 優先/必須のノードルール | zone-aを優先、別のpodと同じノードを避ける |
| Taints & Tolerations | PodにTolerationがない限りPodを排除 | GPUワークロード専用ノード |
| Resource requests | スケジュールに必要な最小CPU/メモリ | requests.cpu: 500m |
試験のポイント: TaintsはNode側(Podを排除)。TolerationsはPod側(Taintを受け入れ)。Taintのeffect:NoSchedule(新しいPodをスケジュールしない)、PreferNoSchedule(できれば避ける)、NoExecute(実行中のPodも退去させる)。
2. Resource RequestsとLimits
| 設定 | 影響対象 | 超過した場合 |
|---|---|---|
| requests.cpu | スケジューリング(schedulerがノード選択に使用) | スロットリング(killされない) |
| limits.cpu | Cgroups CPUクォータ | CPUスロットリング |
| requests.memory | スケジューリング | limitを超えるとOOM Kill |
| limits.memory | Cgroups メモリリミット | コンテナがOOM Killされる |
QoS Classes:
  Guaranteed: requests == limits (最高品質、最後に退去)
  Burstable:  requests < limits (中間)
  BestEffort: requestsもlimitsもなし (最初に退去)
3. オートスケーリング
| スケーラー | スケール対象 | メトリクス |
|---|---|---|
| HPA(Horizontal Pod Autoscaler) | Podレプリカ数 | CPU%、Memory%、カスタムメトリクス |
| VPA(Vertical Pod Autoscaler) | PodのCPU/Memory requests | 実際の使用履歴 |
| Cluster Autoscaler | クラスター内のノード数 | Pending Pods(スケジュール不可) |
| KEDA | レプリカ数(0まで) | イベント駆動(キュー深度、Kafka) |
HPA integration:
  metrics-server → kubelet → Node/Pod metrics
       ↓
  HPA controller (checks every 15s)
       ↓
  Scale up: replicas++  (traffic spike)
  Scale down: replicas-- (traffic drops, 5 min cooldown)
試験のポイント: HPAが機能するにはmetrics-serverが必要です。VPAとHPAは同じDeploymentを管理する場合に競合する可能性があります。同じリソースに対して同時に使用すべきではありません(KEDAのマルチディメンションを除く)。
4. Namespaceとマルチテナンシー
Namespaceは仮想クラスター分離を提供します:RBACのスコープ、ResourceQuota、NetworkPolicy、DNS解決。
| Namespace | 目的 | 備考 |
|---|---|---|
default | namespaceを指定しないオブジェクト | 開発で使用、本番では使用しない |
kube-system | Kubernetesシステムコンポーネント | CoreDNS、kube-proxy、metrics-server |
kube-public | パブリック、全ユーザー読み取り可能 | クラスター情報ConfigMap |
kube-node-lease | ノードのハートビートリース | Kubeletハートビートのパフォーマンス |
5. チートシート
| 試験の質問 | 回答 |
|---|---|
| CPUに基づいてPod数をスケールするには? | HPA |
| クラスター内のノード数をスケールするには? | Cluster Autoscaler |
| GPU専用ノード、何を使う? | Taint + PodのToleration |
| コンテナがOOM Killされる原因は? | limits.memoryを超過 |
| 最初に退去されるQoSクラスは? | BestEffort |
6. 練習問題
Q1: ノードにkey=gpu:NoScheduleのTaintが設定されています。このノードにスケジュールできるPodはどれですか?
- A) クラスター内のすべてのPod
- B) そのTaintに一致するTolerationを持つPod ✓
- C) kube-system namespaceのPodのみ
- D) クラスター管理者が作成したPodのみ
解説:NoSchedule Taintは、Podが一致するtolerationを指定しない限り、新しいPodがそのノードにスケジュールされることを防ぎます。既存のPodは退去されません(それにはNoExecuteを使用します)。
Q2: アプリケーションのPodがトラフィックスパイク時にOOM-killされ続けています。最も適切な解決策は何ですか?
- A) PodのCPU requestsを増やす
- B) メモリ使用量に基づいてスケールするようにHPAを構成する ✓
- C) アプリを新しいnamespaceに移動する
- D) DeploymentをStatefulSetに変更する
解説:OOM killはメモリ需要がlimitsを超えていることを意味します。HPAでスケールアウト(より多くのPodレプリカ)すると負荷が分散され、Pod当たりのメモリプレッシャーが軽減されます。または、メモリlimitsを増やすかVPAを使用します。
Q3: HPAがスケーリングの判断に使用するCPUとメモリのメトリクスを提供するKubernetesコンポーネントはどれですか?
- A) kube-proxy
- B) kube-scheduler
- C) metrics-server ✓
- D) etcd
解説:metrics-serverはkubeletからリソースメトリクス(CPU、メモリ)を収集するオプションのクラスターアドオンです。HPAコントローラーはmetrics-serverが公開するメトリクスAPIをクエリしてスケーリングの判断を行います。