1. Kubernetes 排程
當 Pod 被建立時,kube-scheduler 透過 2 個步驟選擇合適的節點:
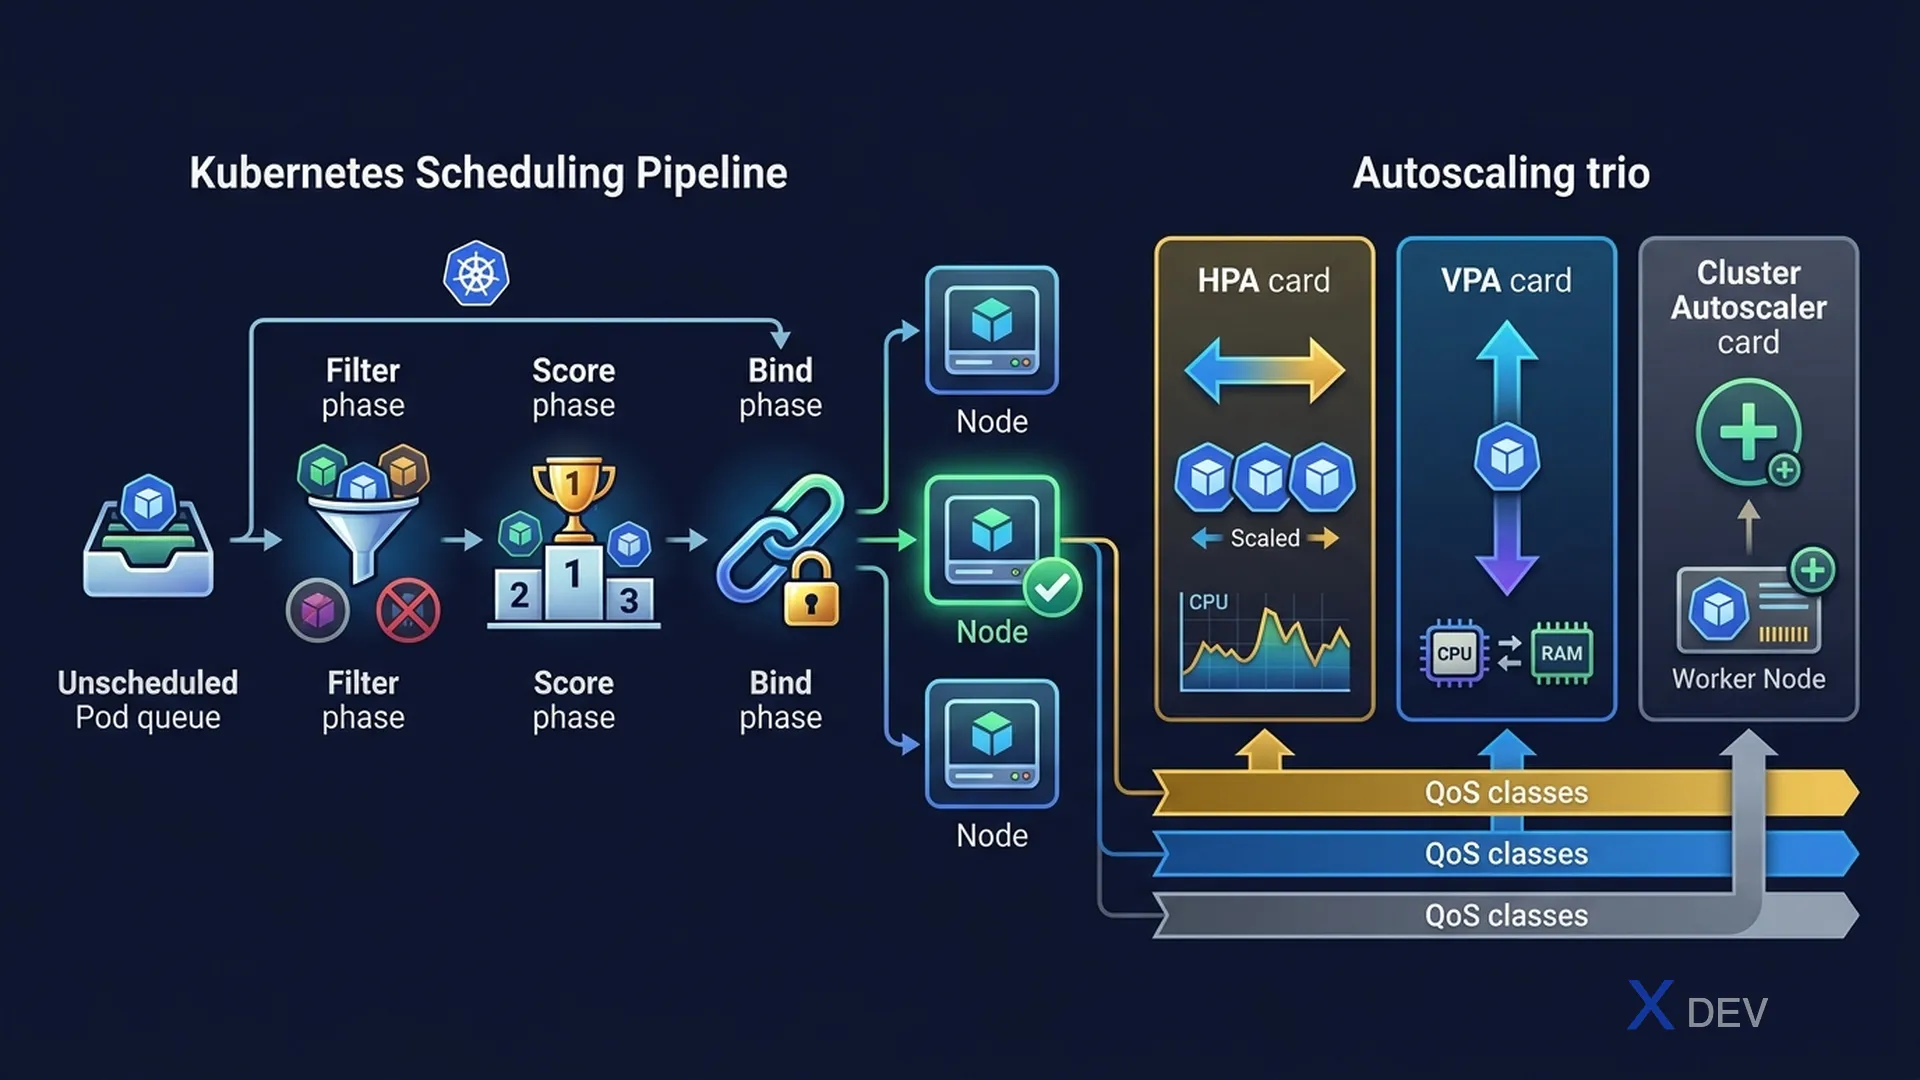
Scheduling Pipeline:
  New Pod
    │
    ▼
  1. FILTERING: 排除不符條件的節點
     - CPU/Memory 不足
     - Taint 與 Toleration 不匹配
     - Node Affinity 不匹配
     │
    ▼
  2. SCORING: 為剩餘節點評分
     - 資源平衡
     - Affinity 偏好
     │
    ▼
Bind Pod → Highest score Node| 機制 | 目的 | 範例 |
|---|---|---|
| NodeSelector | 將 Pod 排程到有特定標籤的節點 | disktype: ssd |
| Affinity/Anti-affinity | 偏好/必需的節點規則 | 偏好 zone-a,避免與另一個 Pod 在同一節點 |
| Taints & Tolerations | 排斥 Pod 除非 Pod 有 Toleration | 節點專用於 GPU 工作負載 |
| Resource requests | 排程所需的最低 CPU/Memory | requests.cpu: 500m |
考試重點: Taint 套用在 Node 上(排斥 Pod)。Toleration 套用在 Pod 上(接受 Taint)。Taint 效果:NoSchedule(不排程新 Pod)、PreferNoSchedule(優先不排程)、NoExecute(驅逐正在執行的 Pod)。
2. 資源 Requests 與 Limits
| 設定 | 影響 | 超出時 |
|---|---|---|
| requests.cpu | 排程(scheduler 用來選擇節點) | 被節流(不會被終止) |
| limits.cpu | Cgroups CPU 配額 | CPU 被節流 |
| requests.memory | 排程 | 超出 limit 時 OOM Kill |
| limits.memory | Cgroups 記憶體限制 | 容器被 OOM Kill |
QoS Classes:
  Guaranteed: requests == limits (best quality, last to be evicted)
  Burstable:  requests < limits (middle)
  BestEffort: no requests, no limits (first to be evicted)
3. 自動擴展
| 擴展器 | 擴展什麼 | 指標 |
|---|---|---|
| HPA(Horizontal Pod Autoscaler) | Pod 副本數量 | CPU%、Memory%、自訂指標 |
| VPA(Vertical Pod Autoscaler) | Pod 的 CPU/Memory requests | 實際使用歷史記錄 |
| Cluster Autoscaler | 叢集中的節點數量 | Pending Pod(無法排程) |
| KEDA | 副本數量(可到 0) | 事件驅動(佇列深度、Kafka) |
HPA integration:
  metrics-server → kubelet → Node/Pod metrics
       ↓
  HPA controller (checks every 15s)
       ↓
  Scale up: replicas++  (traffic spike)
  Scale down: replicas-- (traffic drops, 5 min cooldown)
考試重點: HPA 需要 metrics-server 才能運作。VPA 和 HPA 同時管理一個 Deployment 可能產生衝突——不建議同時用於同一資源(除非 KEDA 搭配多維度)。
4. Namespace 與多租戶
Namespace 提供虛擬叢集隔離:範圍包含 RBAC、ResourceQuota、NetworkPolicy 和 DNS 解析。
| Namespace | 用途 | 備註 |
|---|---|---|
default | 未指定 namespace 的物件 | 用於開發,不建議用於生產 |
kube-system | Kubernetes 系統元件 | CoreDNS、kube-proxy、metrics-server |
kube-public | 公開,所有人可讀 | 叢集資訊 ConfigMap |
kube-node-lease | 節點心跳租約 | Kubelet 心跳效能 |
5. 速查表
| 考試問題 | 答案 |
|---|---|
| 根據 CPU 擴展 Pod 數量? | HPA |
| 擴展叢集中的節點數量? | Cluster Autoscaler |
| 節點專用於 GPU,用什麼? | Taint + Pod Toleration |
| 容器被 OOM Kill,原因? | 超出 limits.memory |
| 哪個 QoS 等級最先被驅逐? | BestEffort |
6. 練習題
Q1: 一個節點被加上 Taint key=gpu:NoSchedule。哪些 Pod 可以排程到此節點?
- A) 叢集中的任何 Pod
- B) 具有匹配 Toleration 的 Pod ✓
- C) 僅 kube-system namespace 中的 Pod
- D) 僅叢集管理員建立的 Pod
解析:NoSchedule taint 防止任何新 Pod 排程到該節點,除非 Pod 指定了匹配的 toleration。現有 Pod 不會被驅逐(使用 NoExecute 才會)。
Q2: 應用程式的 Pod 在流量高峰期持續被 OOM-Kill。最合適的解決方案是什麼?
- A) 增加 Pod CPU requests
- B) 設定 HPA 根據記憶體使用量擴展 ✓
- C) 將應用移到新的 namespace
- D) 使用 StatefulSet 取代 Deployment
解析:OOM Kill 意味著記憶體需求超過限制。HPA 水平擴展(更多 Pod 副本)分散負載,減少每個 Pod 的記憶體壓力。或者增加記憶體限制或使用 VPA。
Q3: 哪個 Kubernetes 元件提供 HPA 用於擴展決策的 CPU 和記憶體指標?
- A) kube-proxy
- B) kube-scheduler
- C) metrics-server ✓
- D) etcd
解析:metrics-server 是可選的叢集附加元件,從 kubelet 收集資源指標(CPU、記憶體)。HPA 控制器查詢 metrics-server 暴露的 metrics API 來做出擴展決策。