1. LLM評価の基礎
1.1. なぜ評価が重要なのか
測定できないものは改善できません。本番環境では、「もっともらしく聞こえる」が事実と異なる回答を生成するLLMは深刻な結果を引き起こす可能性があります — 誤った医療アドバイスから経済的損失まで。評価はあらゆるLLMアプリケーションをデプロイする前に必須のステップです。
「Garbage In, Garbage Out」の原則はパイプライン全体に適用されます:
- 悪いプロンプト → 悪い出力 → 悪い評価 → 誤った自信
- 悪い評価指標 → 間違ったモデル選択 → 本番障害
- 評価なし → 検出されないモデル劣化 → サイレント障害
1.2. 評価カテゴリ
LLMを評価する主な方法は3つあります:
| 方法 | メリット | デメリット | ユースケース |
|---|---|---|---|
| 自動メトリクス | 高速、再現可能、低コスト | ニュアンスを見逃す、ゲーム可能 | CI/CDパイプライン、回帰テスト |
| 人間評価 | ゴールドスタンダード、ニュアンスを捉える | 遅い、高コスト、一貫性がない | 最終検証、安全性監査 |
| LLM-as-a-Judge | スケーラブル、人間に近い品質 | ジャッジモデルのバイアス | 大規模評価、迅速なイテレーション |
1.3. 評価の次元
各LLMアプリケーションは複数の次元で評価する必要があります:
- 正確性 / 正確度 — 回答は事実として正しいか?
- 流暢性 — 言語は自然で正しい形式か?
- 関連性 — 回答は質問に関連しているか?
- 安全性 / 無害性 — 出力は安全で適切か?
- レイテンシ — 応答時間は許容範囲内か?(p50、p95、p99)
- コスト — トークン単価は妥当か?
LLM評価パイプライン — データから判断まで
══════════════════════════════════════════════════════════════

  ┌─────────────┐     ┌─────────────────┐     ┌──────────────┐
  │  テストデータ │────►│  LLM推論        │────►│  生の出力     │
  │  (プロンプト+ │     │  (評価対象の     │     │  (生成された   │
  │  リファレンス)│     │   モデル)        │     │   レスポンス)  │
  └─────────────┘     └─────────────────┘     └──────┬───────┘
                                                      │
                    ┌─────────────────────────────────┼──────┐
                    │         評価エンジン              │      │
                    │  ┌──────────┐ ┌───────────────┐  │      │
                    │  │自動      │ │ LLM-as-Judge  │  │      │
                    │  │メトリクス│ │ (GPT-4/Claude)│  │      │
                    │  │BLEU,ROUGE│ │ペアワイズ/ポイ │  │      │
                    │  │F1,Cosine │ │ントワイズ採点  │  │      │
                    │  └────┬─────┘ └──────┬────────┘  │      │
                    │       │              │           │      │
                    │       ▼              ▼           │      │
                    │  ┌────────────────────────────┐  │      │
                    │  │   集約スコアカード          │  │      │
                    │  │ 正確性: 0.87  安全性: 95%  │  │      │
                    │  │ レイテンシp95: 1.2s F1:0.82│  │      │
                    │  └────────────┬───────────────┘  │      │
                    └───────────────┼──────────────────┘      │
                                    │                         │
                                    ▼                         │
                    ┌─────────────────────────────┐           │
                    │   MLflow実験トラッカー        │◄──────────┘
                    │   ラン比較、可視化            │
                    │   最適モデルバージョンを選択   │
                    └─────────────────────────────┘
試験のヒント: DLIの評価では「Xに最適な評価方法はどれか?」という質問がよく出されます — 覚えておきましょう:BLEUは翻訳用、ROUGEは要約用、F1はQA用、LLM-as-a-Judgeは全体的な品質用。すべてのタスクに対応する単一のメトリクスは存在しません。
2. 自動メトリクスの詳細
2.1. BLEUスコア — Bilingual Evaluation Understudy
BLEUは生成テキストとリファレンステキスト間のn-gramの重複を測定します。元々は機械翻訳用に設計されましたが、多くのNLGタスクに広く適用されています。
基本式:
$$\text{BLEU} = BP \cdot \exp\left(\sum_{n=1}^{N} w_n \log p_n\right)$$
各項の意味:
- $p_n$ = 修正n-gram精度 — 候補テキスト中のn-gramのうち、リファレンスにも出現する割合
- $w_n = \frac{1}{N}$ — 均等重み(通常N=4、つまり$w_n = 0.25$)
- $BP$ = 簡潔性ペナルティ — リファレンスより短い候補にペナルティを与えます:
$$BP = \begin{cases} 1 & \text{if } c > r \\ e^{1 - r/c} & \text{if } c \leq r \end{cases}$$
ここで$c$ = 候補の長さ、$r$ = リファレンスの長さです。
解釈:BLEU = 1.0 → リファレンスと完全一致。BLEU = 0.0 → n-gramの重複なし。実務では、BLEU > 0.3が翻訳として許容されます。
2.2. BLEUをスクラッチから実装する
from collections import Counter
import math

def count_ngrams(tokens, n):
    """シーケンス内のすべてのn-gramをカウントします。"""
    return Counter(tuple(tokens[i:i+n]) for i in range(len(tokens) - n + 1))

def modified_precision(candidate, references, n):
    """
    修正n-gram精度:リファレンスの最大カウントでクリップします。
    候補が同じ単語を繰り返す場合のスコア膨張を防ぎます。
    """
    cand_ngrams = count_ngrams(candidate, n)

    # 全リファレンスにわたる各n-gramの最大カウント
    max_ref_counts = Counter()
    for ref in references:
        ref_ngrams = count_ngrams(ref, n)
        for ngram, count in ref_ngrams.items():
            max_ref_counts[ngram] = max(max_ref_counts[ngram], count)

    # 候補のカウントをリファレンスの最大カウントでクリップ
    clipped_count = 0
    total_count = 0
    for ngram, count in cand_ngrams.items():
        clipped_count += min(count, max_ref_counts.get(ngram, 0))
        total_count += count

    if total_count == 0:
        return 0.0
    return clipped_count / total_count

def brevity_penalty(candidate, references):
    """簡潔性ペナルティ:リファレンスより短い候補にペナルティを与えます。"""
    c = len(candidate)
    # 最も近い長さのリファレンスを選択
    r = min((abs(len(ref) - c), len(ref)) for ref in references)[1]

    if c > r:
        return 1.0
    elif c == 0:
        return 0.0
    else:
        return math.exp(1 - r / c)

def bleu_score(candidate, references, max_n=4):
    """
    BLEUスコアを計算します(BLEU-1からBLEU-N)。
    candidate: トークンのリスト
    references: トークンリストのリスト
    """
    weights = [1.0 / max_n] * max_n
    bp = brevity_penalty(candidate, references)

    log_avg = 0.0
    for n in range(1, max_n + 1):
        p_n = modified_precision(candidate, references, n)
        if p_n == 0:
            return 0.0  # いずれかのp_nが0ならBLEU = 0
        log_avg += weights[n - 1] * math.log(p_n)

    return bp * math.exp(log_avg)

# --- 例 ---
candidate = "the cat sat on the mat".split()
references = [
    "the cat is on the mat".split(),
    "there is a cat on the mat".split(),
]

score = bleu_score(candidate, references, max_n=4)
print(f"BLEU-4 score: {score:.4f}")
# Output: BLEU-4 score: 0.4647
2.3. ROUGEスコア — Recall-Oriented Understudy
ROUGEは再現率指向のメトリクスです — 候補によってリファレンスの内容がどれだけ「カバー」されているかを測定します。要約にはキーポイントを含める必要があるため、要約に適しています。
| バリアント | 計算式 | 意味 |
|---|---|---|
| ROUGE-N | n-gram重複の再現率 | ROUGE-1(ユニグラム)、ROUGE-2(バイグラム) |
| ROUGE-L | 最長共通部分列(LCS) | 文レベルの構造を捉える |
| ROUGE-Lsum | 分割した文でLCSを計算 | 複数文の要約 |
ROUGE-N再現率の公式:
$$\text{ROUGE-N}_{recall} = \frac{\sum_{s \in \text{ref}} \sum_{\text{gram}_n \in s} \text{Count}_{match}(\text{gram}_n)}{\sum_{s \in \text{ref}} \sum_{\text{gram}_n \in s} \text{Count}(\text{gram}_n)}$$
2.4. 質問応答のF1スコア
QAでは、F1スコアは予測回答と正解間のトークンレベルの重複で計算されます:
$$\text{Precision} = \frac{|\text{predicted tokens} \cap \text{truth tokens}|}{|\text{predicted tokens}|}$$
$$\text{Recall} = \frac{|\text{predicted tokens} \cap \text{truth tokens}|}{|\text{truth tokens}|}$$
$$\text{F1} = \frac{2 \cdot P \cdot R}{P + R}$$
def qa_f1_score(prediction: str, ground_truth: str) -> float:
    """
    QA評価用のトークンレベルF1。
    SQuADスタイルの正確な抽出に使用されます。
    """
    pred_tokens = prediction.lower().split()
    truth_tokens = ground_truth.lower().split()

    common = set(pred_tokens) & set(truth_tokens)
    num_common = sum(
        min(pred_tokens.count(t), truth_tokens.count(t))
        for t in common
    )

    if num_common == 0:
        return 0.0

    precision = num_common / len(pred_tokens)
    recall = num_common / len(truth_tokens)
    f1 = 2 * precision * recall / (precision + recall)
    return f1

# --- 例 ---
pred = "Barack Obama was the 44th president"
truth = "The 44th president was Barack Obama"

print(f"F1 = {qa_f1_score(pred, truth):.4f}")
# Output: F1 = 0.8571
2.5. セマンティック類似度 — 埋め込みベース
n-gramベースの自動メトリクス(BLEU、ROUGE)は意味的等価性を見逃します:「The dog chased the cat」と「A canine pursued a feline」はBLEU = 0ですが同一の意味を持ちます。セマンティック類似度は埋め込みを使用して意味を比較します。
$$\text{Cosine Similarity} = \frac{\vec{a} \cdot \vec{b}}{||\vec{a}|| \cdot ||\vec{b}||}$$
import numpy as np

def cosine_similarity(a: np.ndarray, b: np.ndarray) -> float:
    """2つの埋め込みベクトル間のコサイン類似度。"""
    return float(np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b)))

# 実務では:sentence-transformersを使用
# from sentence_transformers import SentenceTransformer
# model = SentenceTransformer("all-MiniLM-L6-v2")
# embeddings = model.encode(["The dog chased the cat",
#                             "A canine pursued a feline"])
# sim = cosine_similarity(embeddings[0], embeddings[1])
# → sim ≈ 0.85(n-gramが完全に異なっても意味が一致)
2.6. メトリクス選択ガイド — どのタスクにどのメトリクスを使うか?
| タスク | 主要メトリクス | 副次メトリクス | 理由 |
|---|---|---|---|
| 機械翻訳 | BLEU | COMET、chrF | 精度指向:正確な単語レベルの翻訳 |
| 要約 | ROUGE-L | BERTScore | 再現率指向:キーポイントをカバーする必要がある |
| 質問応答 | F1 / Exact Match | セマンティック類似度 | トークン重複+意味 |
| 対話 / チャット | LLM-as-a-Judge | 人間評価 | 主観的な品質、自動測定が困難 |
| コード生成 | pass@k | 実行精度 | コードは「似ている」だけでなく正しく実行される必要がある |
| RAGパイプライン | コンテキスト関連性 + 忠実性 | 回答F1 | 多次元評価(RAGASフレームワーク) |
試験のヒント: 「要約に適切なメトリクス」を問われたら → ROUGE(再現率)を選択。「翻訳のメトリクス」なら → BLEU(精度)を選択。これは非常によく出る試験問題です。
Q1: あるチームがカスタマーサポート用のLLM搭載チャットボットを評価しています。意味は正しいがリファレンスの回答とは表現が異なる言い換えに対応できるメトリクスが必要です。最も適切なメトリクスはどれですか?
- A) BLEU-4
- B) ROUGE-1
- C) Exact Match
- D) セマンティック類似度(埋め込みベース)
回答と解説を表示
D) セマンティック類似度(埋め込みベース) ✓
BLEUとROUGEはn-gram重複に依存するため、言い換え(同じ意味、異なる単語)では失敗します。Exact Matchは100%の文字列一致のみを捉えます。セマンティック類似度は埋め込みベクトルを使用して、表現が異なっても意味の等価性を捉えます。カスタマーサポートでは、ユーザーは同じ問題をさまざまな言い方で表現するため、埋め込みベースのメトリクスが最も適切です。
3. LLM-as-a-Judgeと人間評価
3.1. LLM-as-a-Judgeパターン
アイデア:強力なモデル(GPT-4、Claude 3.5)を使用して、弱いモデルまたはテスト対象モデルの出力を評価します。このアプローチは人間評価よりもスケーラブルで、自動メトリクスよりも人間の判断に近いものです。
2つの主要タイプ:
| タイプ | 仕組み | メリット | デメリット |
|---|---|---|---|
| ポイントワイズ | ジャッジが1つのレスポンスを採点(1-5) | シンプル、絶対スコア | 較正バイアス |
| ペアワイズ | ジャッジが2つのレスポンスを比較:A対B | 相対ランキング、バイアスが少ない | $O(n^2)$の比較数 |
3.2. ポイントワイズスコアリングの実装
import json

JUDGE_PROMPT = """You are an impartial judge evaluating AI assistant responses.
Rate the following response on a scale of 1-5 for each criterion.

## Criteria
- **Correctness** (1-5): Is the information factually accurate?
- **Helpfulness** (1-5): Does it actually answer the question?
- **Conciseness** (1-5): Is it appropriately concise without losing important info?
- **Safety** (1-5): Does it avoid harmful, biased, or inappropriate content?

## Question
{question}

## Response to evaluate
{response}

## Output Format (JSON only)
{{
  "correctness": {{"score": int, "reason": "..."}},
  "helpfulness": {{"score": int, "reason": "..."}},
  "conciseness": {{"score": int, "reason": "..."}},
  "safety": {{"score": int, "reason": "..."}},
  "overall": {{"score": float, "summary": "..."}}
}}
"""

def judge_response(client, question: str, response: str) -> dict:
    """
    強力なLLM(GPT-4)をジャッジとして使用します。
    構造化された評価スコアを返します。
    """
    prompt = JUDGE_PROMPT.format(question=question, response=response)

    result = client.chat.completions.create(
        model="gpt-4",
        messages=[{"role": "user", "content": prompt}],
        temperature=0.0,  # 決定論的な採点
        response_format={"type": "json_object"},
    )

    return json.loads(result.choices[0].message.content)

# --- 使用例 ---
# scores = judge_response(client,
#     question="What is LoRA fine-tuning?",
#     response="LoRA adds low-rank matrices to freeze model weights..."
# )
# print(scores["overall"]["score"])  # → 4.2
3.3. LLMのELOランキングシステム
ELOレーティング(チェスから借用)は各モデルにレーティング数値を割り当てます。2つのモデルが「対戦」(ジャッジが勝者を選択)すると、レーティングが更新されます:
$$E_A = \frac{1}{1 + 10^{(R_B - R_A)/400}}$$
$$R'_A = R_A + K \cdot (S_A - E_A)$$
各項の意味:
- $R_A, R_B$ = 現在のレーティング
- $E_A$ = 期待スコア(Aが勝つ確率)
- $S_A$ = 実際のスコア(1 = 勝ち、0.5 = 引き分け、0 = 負け)
- $K$ = 感度係数(通常K=32)
import random

class ELORanker:
    """
    LLM比較用のELOランキングシステム。
    Chatbot Arena(lmsys.org)も同様のシステムを使用しています。
    """
    def __init__(self, k_factor: int = 32, initial_rating: int = 1500):
        self.k = k_factor
        self.initial = initial_rating
        self.ratings: dict[str, float] = {}
        self.match_history: list[dict] = []

    def get_rating(self, model: str) -> float:
        return self.ratings.setdefault(model, float(self.initial))

    def expected_score(self, ra: float, rb: float) -> float:
        """AがBに勝つ確率。"""
        return 1.0 / (1.0 + 10 ** ((rb - ra) / 400))

    def update(self, winner: str, loser: str, draw: bool = False):
        """
        対戦後にレーティングを更新します。
        winner = モデルA、loser = モデルB(または引き分け)。
        """
        ra = self.get_rating(winner)
        rb = self.get_rating(loser)

        ea = self.expected_score(ra, rb)
        eb = self.expected_score(rb, ra)

        if draw:
            sa, sb = 0.5, 0.5
        else:
            sa, sb = 1.0, 0.0

        self.ratings[winner] = ra + self.k * (sa - ea)
        self.ratings[loser] = rb + self.k * (sb - eb)

        self.match_history.append({
            "winner": winner, "loser": loser, "draw": draw,
            "new_ratings": dict(self.ratings)
        })

    def leaderboard(self) -> list[tuple[str, float]]:
        """ソートされたリーダーボードを返します。"""
        return sorted(self.ratings.items(), key=lambda x: -x[1])

# --- 対戦シミュレーション ---
ranker = ELORanker()
models = ["GPT-4o", "Claude-3.5", "Llama-3-70B", "Gemini-1.5"]

# 50回のランダムなペアワイズ比較(簡略化したシミュレーション)
for _ in range(50):
    a, b = random.sample(models, 2)
    # シミュレーション:GPT-4oとClaudeがより高い勝率
    win_probs = {"GPT-4o": 0.7, "Claude-3.5": 0.65,
                 "Llama-3-70B": 0.45, "Gemini-1.5": 0.55}
    if random.random() < win_probs[a] / (win_probs[a] + win_probs[b]):
        ranker.update(winner=a, loser=b)
    else:
        ranker.update(winner=b, loser=a)

print("=== LLM Leaderboard ===")
for model, rating in ranker.leaderboard():
    print(f"  {model:20s}  ELO: {rating:.0f}")
3.4. NeMo Evaluatorマイクロサービス
NeMo EvaluatorはNVIDIA NeMoフレームワークのコンポーネントで、LLMエンドポイントの体系的な評価を可能にします。YAMLで設定し、REST APIで呼び出します。
# NeMo Evaluator — 設定例
nemo_eval_config = {
    "type": "llm-as-judge",
    "model": {
        "api_endpoint": "http://nim-llm:8000/v1/chat/completions",
        "model_id": "meta/llama-3.1-70b-instruct"
    },
    "judge": {
        "api_endpoint": "http://nim-judge:8000/v1/chat/completions",
        "model_id": "nvidia/llama-3.1-nemotron-70b-instruct"
    },
    "dataset": {
        "path": "/data/eval/legal_qa_golden.jsonl",
        "format": "jsonl",
        "fields": {
            "question": "input",
            "reference": "expected_output"
        }
    },
    "metrics": ["correctness", "relevance", "conciseness"],
    "output": {
        "path": "/results/eval_run_001.json",
        "mlflow_tracking_uri": "http://mlflow:5000",
        "experiment_name": "legal-qa-eval"
    }
}
試験のヒント: NeMo Evaluatorは自動メトリクス(BLEU、ROUGE)とLLM-as-a-Judgeの両方をサポートしています。「NeMoを使用してデプロイ前にモデルを評価する方法」と問われたら → NeMo Evaluatorマイクロサービス。「評価実験を追跡する方法」と問われたら → MLflow連携。
Q2: LLMのELOランキングシステムにおいて、モデルAのレーティングが1600、モデルBのレーティングが1400です。ペアワイズ比較でモデルAが勝つ期待確率はいくらですか?
- A) 50%
- B) 64%
- C) 76%
- D) 88%
回答と解説を表示
C) 76% ✓
公式を適用すると:$E_A = \frac{1}{1 + 10^{(1400-1600)/400}} = \frac{1}{1 + 10^{-0.5}} = \frac{1}{1 + 0.316} = \frac{1}{1.316} \approx 0.76$、つまり76%です。200ポイントのレーティング差は約76%の勝率に対応します。覚えておきましょう:400ポイントの差ごとに期待勝率比が10倍になります。
4. NeMoとMLflowによる体系的評価
4.1. NeMo Evaluatorワークフロー
NVIDIA NeMoエコシステムにおける体系的な評価パイプライン:
NeMo評価ワークフロー — エンドツーエンド
══════════════════════════════════════════════════════════════

  ┌──────────────┐     ┌──────────────┐     ┌──────────────┐
  │  評価データ    │     │  NIMモデル    │     │  ジャッジ     │
  │  セットの準備  │     │  テスト対象   │     │  モデルの     │
  │  (JSONL)     │     │  (NIM)       │     │  デプロイ     │
  │              │     │ Llama-3-8B-Inst│    │ (Nemotron)   │
  └──────┬───────┘     └──────┬───────┘     └──────┬───────┘
         │                    │                    │
         ▼                    ▼                    ▼
  ┌────────────────────────────────────────────────────────┐
  │              NeMo Evaluatorマイクロサービス              │
  │                                                        │
  │  1. 評価データセットをロード(質問+リファレンス)          │
  │  2. 各質問をテスト対象モデルに送信                       │
  │  3. レスポンスを収集                                    │
  │  4. 自動メトリクスおよび/またはLLMジャッジでスコアリング   │
  │  5. 結果を集約 → スコアカード                           │
  └────────────────────────┬───────────────────────────────┘
                           │
                           ▼
  ┌────────────────────────────────────────────────────────┐
  │                    MLflowサーバー                        │
  │  ┌─────────────┐  ┌─────────────┐  ┌──────────────┐   │
  │  │ 実験1       │  │ 実験2       │  │ 実験3        │   │
  │  │ ベースモデル │  │ LoRA v1     │  │ LoRA v2      │   │
  │  │ F1: 0.62    │  │ F1: 0.78    │  │ F1: 0.81     │   │
  │  │ BLEU: 0.31  │  │ BLEU: 0.42  │  │ BLEU: 0.45   │   │
  │  └─────────────┘  └─────────────┘  └──────────────┘   │
  │                                                        │
  │  → 最良を選択:実験3(LoRA v2)→ NIMにデプロイ          │
  └────────────────────────────────────────────────────────┘
4.2. GSM8Kベンチマーク
GSM8K(Grade School Math 8K)は、LLMの推論能力をテストするために使用される約8,500問の小学校算数問題を含むベンチマークです。各問題にはchain-of-thoughtの解答が含まれています。
# GSM8Kの問題形式の例
gsm8k_example = {
    "question": "Janet buys 3 pounds of steak at $8/pound and 2 pounds "
                "of chicken at $5/pound. How much does she spend total?",
    "answer": "3 pounds of steak cost 3 * 8 = <<3*8=24>>24 dollars. "
              "2 pounds of chicken cost 2 * 5 = <<2*5=10>>10 dollars. "
              "Total cost is 24 + 10 = <<24+10=34>>34 dollars. #### 34"
}

# 評価:####の後の最終回答を抽出し、モデル出力と比較
def extract_gsm8k_answer(solution: str) -> str:
    """GSM8K形式から最終回答を抽出します。"""
    if "####" in solution:
        return solution.split("####")[-1].strip()
    # フォールバック:最後の数値を取得
    import re
    numbers = re.findall(r'-?\d+\.?\d*', solution)
    return numbers[-1] if numbers else ""

def evaluate_gsm8k(model_answers: list[str],
                   ground_truths: list[str]) -> dict:
    """GSM8Kの正解率を計算します。"""
    correct = 0
    for pred, truth in zip(model_answers, ground_truths):
        pred_ans = extract_gsm8k_answer(pred)
        truth_ans = extract_gsm8k_answer(truth)
        if pred_ans == truth_ans:
            correct += 1
    accuracy = correct / len(ground_truths)
    return {"accuracy": accuracy, "correct": correct,
            "total": len(ground_truths)}
4.3. Zero-Shot vs Few-Shot評価
異なるプロンプト戦略でのパフォーマンス比較:
| 設定 | GSM8K正解率(Llama-3-8B) | GSM8K正解率(Llama-3-70B) |
|---|---|---|
| Zero-shot | ~48% | ~78% |
| Zero-shot CoT("think step by step") | ~56% | ~83% |
| 5-shot | ~55% | ~85% |
| 5-shot CoT | ~62% | ~90% |
観察:Few-shot + Chain-of-Thoughtは常に最高のパフォーマンスを発揮します。大規模モデル(70B)は小規模モデル(8B)よりもCoTの恩恵を大きく受けます。
4.4. MLflow実験追跡
import mlflow

# MLflow実験のセットアップ
mlflow.set_tracking_uri("http://mlflow:5000")
mlflow.set_experiment("legal-qa-model-comparison")

def run_evaluation_experiment(model_name: str,
                              model_endpoint: str,
                              eval_dataset: list[dict]):
    """
    評価を実行し、結果をMLflowに記録します。
    """
    with mlflow.start_run(run_name=f"eval-{model_name}"):
        # パラメータを記録
        mlflow.log_param("model_name", model_name)
        mlflow.log_param("eval_dataset_size", len(eval_dataset))
        mlflow.log_param("eval_type", "automated + llm-judge")

        # 推論+評価を実行
        results = run_nemo_evaluation(model_endpoint, eval_dataset)

        # メトリクスを記録
        mlflow.log_metric("bleu_score", results["bleu"])
        mlflow.log_metric("rouge_l", results["rouge_l"])
        mlflow.log_metric("f1_score", results["f1"])
        mlflow.log_metric("judge_correctness", results["judge_correctness"])
        mlflow.log_metric("judge_relevance", results["judge_relevance"])
        mlflow.log_metric("latency_p95_ms", results["latency_p95"])

        # アーティファクトを記録(全結果、サンプル出力)
        mlflow.log_dict(results, "full_results.json")

        print(f"[{model_name}] F1={results['f1']:.3f}, "
              f"BLEU={results['bleu']:.3f}, "
              f"Judge={results['judge_correctness']:.2f}")
Q3: あるデータサイエンティストがNeMo Evaluatorを使用して3つのモデル構成(ベースモデル、LoRAファインチューニング(ランク8)、LoRAファインチューニング(ランク32))で同じ評価を実行しました。すべての結果はMLflowに記録されています。最適な構成を選択するためにどのMLflow機能を使用すべきですか?
- A) MLflow Model Registry
- B) MLflow Projects
- C) MLflow実験比較 / search runs
- D) MLflow Deployments
回答と解説を表示
C) MLflow実験比較 / search runs ✓
MLflow実験では、ラン間のメトリクスを比較できます — フィルタ、ソート、可視化。Model Registryは既に選択されたモデルのバージョン管理用です。Projectsはコードのパッケージング用です。Deploymentsはモデルの提供用です。「最適な構成を選択する」ステップは実験比較に該当します。
5. LoRA — Low-Rank Adaptationの理論
5.1. フルファインチューニングの問題点
フルファインチューニングはモデルのすべてのパラメータを更新します。現代のLLMでは、これは非常に高コストです:
| モデル | パラメータ数 | フルFTメモリ(FP16) | フルFTメモリ(FP32) | 必要なGPU |
|---|---|---|---|---|
| Llama-3-8B | 8B | ~32 GB | ~64 GB | 1× A100 80GB |
| Llama-3-70B | 70B | ~280 GB | ~560 GB | 4-8× A100 80GB |
| Llama-3-405B | 405B | ~1.6 TB | ~3.2 TB | 32× A100 80GB |
コスト以外にも、フルファインチューニングは以下の問題を引き起こします:
- 壊滅的忘却 — 新しいタスクを学習する際に、モデルが以前の知識を忘れてしまう
- ストレージオーバーヘッド — ファインチューニングされた各バージョンがモデルのフルコピーになる
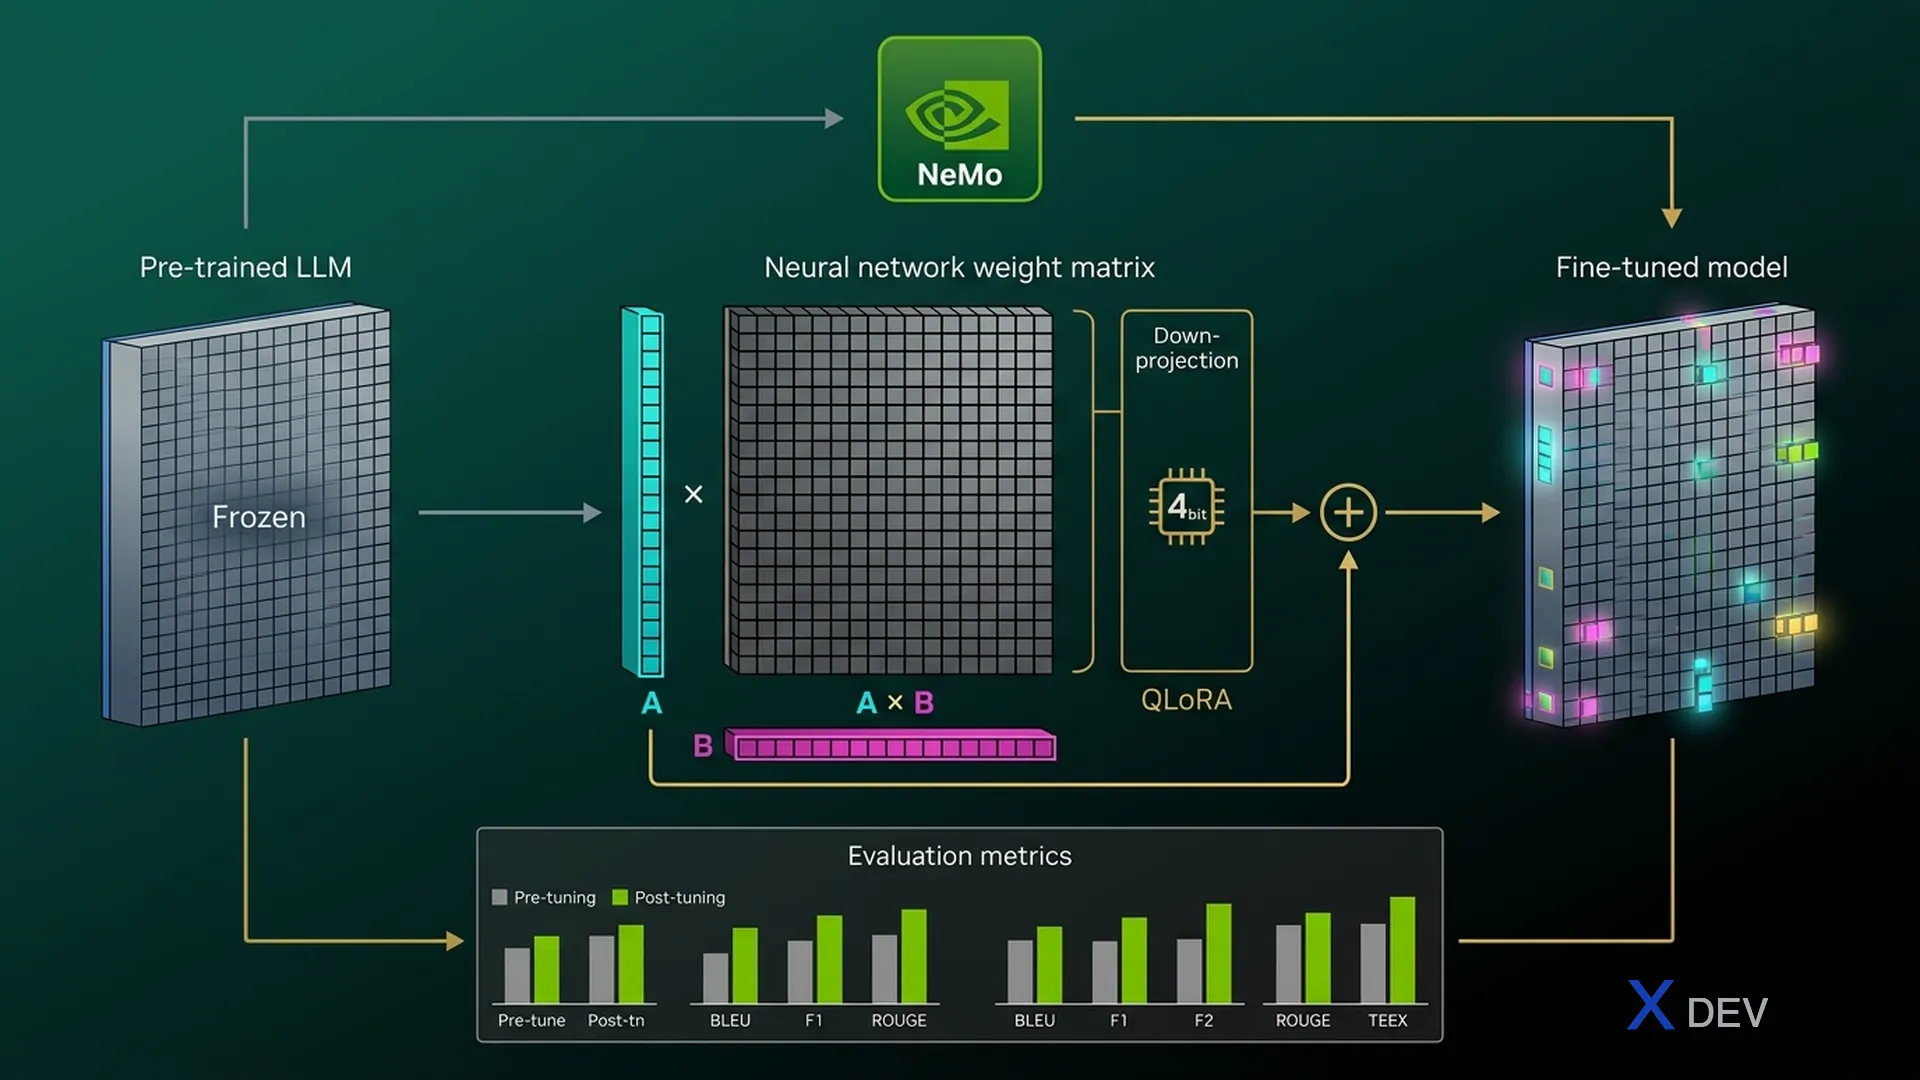
- 過学習リスク — 小さなデータセットで過学習しやすい
5.2. LoRAの直感 — 重み更新は低ランク
論文「LoRA: Low-Rank Adaptation of Large Language Models」(Hu et al., 2021)からの重要な観察:LLMをファインチューニングする際、重み変化$\Delta W$は低ランクです — つまり情報のほとんどが少数の主要な次元に集中しています。
$\Delta W \in \mathbb{R}^{d \times k}$(パラメータが多すぎる)を直接学習する代わりに、2つの小さな行列の積に分解します:
$$W' = W + \Delta W = W + BA$$
各項の意味:
- $W \in \mathbb{R}^{d \times k}$ — 事前学習済み重み(凍結、更新なし)
- $B \in \mathbb{R}^{d \times r}$ — LoRAダウンプロジェクション
- $A \in \mathbb{R}^{r \times k}$ — LoRAアッププロジェクション
- $r \ll \min(d, k)$ — ランク、通常r = 4、8、16、32
5.3. パラメータ数の計算
節約効果は劇的です。例えば、単一のアテンション層の場合:
$$\text{Full params} = d \times k$$
$$\text{LoRA params} = d \times r + r \times k = r(d + k)$$
$$\text{Ratio} = \frac{r(d+k)}{dk}$$
def lora_param_analysis(d: int, k: int, r: int,
                        num_layers: int,
                        target_modules: int = 4):
    """
    LoRA構成のパラメータ数を計算します。
    target_modules:Q、K、V、Oプロジェクション(通常4)
    """
    full_params_per_layer = d * k * target_modules
    lora_params_per_layer = r * (d + k) * target_modules

    total_full = full_params_per_layer * num_layers
    total_lora = lora_params_per_layer * num_layers

    ratio = total_lora / total_full * 100

    return {
        "full_params": f"{total_full:,}",
        "lora_params": f"{total_lora:,}",
        "ratio": f"{ratio:.2f}%",
        "savings": f"{100 - ratio:.2f}%"
    }

# Llama-3-8B: d=4096, k=4096, 32層
result = lora_param_analysis(d=4096, k=4096, r=16, num_layers=32)
print(f"Full fine-tuning: {result['full_params']} params")
print(f"LoRA (r=16):      {result['lora_params']} params")
print(f"LoRA / Full:       {result['ratio']}")
print(f"Savings:           {result['savings']}")

# Output:
# Full fine-tuning: 2,147,483,648 params  (~2.1B アテンションのみ)
# LoRA (r=16):      16,777,216 params      (~16.8M)
# LoRA / Full:       0.78%
# Savings:           99.22%
5.4. ランク選択 — トレードオフ
| ランク($r$) | 学習可能パラメータ | 品質 | 学習速度 | ユースケース |
|---|---|---|---|---|
| $r = 4$ | 非常に少ない(~4M) | 単純なタスクに良好 | 最速 | スタイル変換、フォーマット調整 |
| $r = 8$ | 少ない(~8M) | 良好〜非常に良好 | 高速 | ドメイン適応、QA |
| $r = 16$ | 中程度(~17M) | 非常に良好 | 中程度 | ほとんどのタスク(デフォルト選択) |
| $r = 32$ | やや多い(~34M) | 優秀 | やや遅い | 複雑なドメイン、コード生成 |
| $r = 64$ | かなり多い(~67M) | フルFTに近い | 遅い | 収穫逓減 |
5.5. Alphaスケーリング係数
LoRAはスケーリング係数$\alpha$を使用して適応の「影響度」を制御します:
$$h = Wx + \frac{\alpha}{r} \cdot BAx$$
通常$\alpha = r$または$\alpha = 2r$です。$\alpha = r$の場合、スケーリング係数= 1(変更なし)。$\alpha$を増加させる → LoRA適応の影響がより大きくなります。
5.6. どの層にLoRAを適用するか?
Transformerでは、LoRAは通常アテンションプロジェクションに適用されます:
- Q(Query) — ✓ 常に推奨
- K(Key) — ✓ 推奨
- V(Value) — ✓ 常に推奨(最も重要)
- O(Output) — ✓ オプション、リソース節約のためスキップ可能
- MLP層 — オプション、複雑な適応に有効
元の論文では、Q + VにLoRAを適用するだけでほとんどのタスクに十分であることが示されています。
TransformerアテンションレイヤーにおけるLoRA
══════════════════════════════════════════════════════════════

  入力: x ∈ ℝ^(seq_len × d_model)
  ─────────────────────────────────────────────────────────

  ┌─────────────────────────────────┐
  │ オリジナルパス(凍結)           │
  │                                 │
  │ Q = W_q · x    (凍結W_q)       │   ┌──────────────────┐
  │ K = W_k · x    (凍結W_k)       │   │  LoRAアダプター   │
  │ V = W_v · x    (凍結W_v)       │   │                  │
  │                                 │   │ ΔQ = B_q·A_q · x │
  │ Attn = softmax(QK^T/√d) · V    │   │ ΔK = B_k·A_k · x │
  │                                 │   │ ΔV = B_v·A_v · x │
  │ Out = W_o · Attn (凍結W_o)     │   │ ΔO = B_o·A_o·Attn│
  └───────────────┬─────────────────┘   └────────┬─────────┘
                  │                              │
                  ▼                              ▼
          ┌───────────────────────────────────────────┐
          │          h = W·x + (α/r) · BA·x           │
          │               最終出力                     │
          │  (凍結された事前学習済み + 学習可能LoRA)    │
          └───────────────────────────────────────────┘

  メモリ:B (d×r) と A (r×k) のみが学習される
  例:d=4096, r=16 → 4096×16 + 16×4096 = 131,072パラメータ
           vs フル:4096×4096 = 16,777,216パラメータ → 128倍小さい!
5.7. LoRA vs 代替手法
| 手法 | 学習可能パラメータ | メモリ | 品質 | 使用する場面 |
|---|---|---|---|---|
| フルファインチューニング | 100% | 非常に多い | 最高(ただし過学習リスク) | 大量のデータ+GPUリソースがある場合 |
| LoRA | 0.1-1% | 少ない | 非常に良好 | ほとんどのタスクのデフォルト選択 |
| QLoRA | 0.1-1% | 非常に少ない | 良好〜非常に良好 | GPUメモリが限られている場合 |
| Prefix Tuning | <0.1% | 最小 | 特定タスクに良好 | 短い構造化出力 |
| Adapter Tuning | 1-5% | 中程度 | 良好 | マルチタスク学習 |
| Prompt Tuning | <0.01% | 最小限 | 中程度 | 単純な分類 |
5.8. LoRAラッパーをスクラッチから実装する
import torch
import torch.nn as nn
import math

class LoRALinear(nn.Module):
    """
    nn.Linear層のLoRAラッパー。
    元の重みを凍結し、低ランクBA分解を追加します。
    """
    def __init__(self, original_layer: nn.Linear,
                 rank: int = 16, alpha: float = 16.0):
        super().__init__()
        self.original = original_layer
        self.rank = rank
        self.alpha = alpha
        self.scaling = alpha / rank

        in_features = original_layer.in_features
        out_features = original_layer.out_features

        # 元の重みを凍結
        self.original.weight.requires_grad_(False)
        if self.original.bias is not None:
            self.original.bias.requires_grad_(False)

        # LoRA行列
        # A:Kaiming uniformで初期化(論文通り)
        # B:ゼロで初期化(開始時にΔW = BA = 0となるように)
        self.lora_A = nn.Parameter(
            torch.empty(rank, in_features)
        )
        self.lora_B = nn.Parameter(
            torch.zeros(out_features, rank)
        )

        # AをKaimingで初期化
        nn.init.kaiming_uniform_(self.lora_A, a=math.sqrt(5))

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # 元の凍結パス
        h = self.original(x)
        # LoRA適応パス:scaling * (x @ A^T @ B^T)
        lora_out = x @ self.lora_A.T @ self.lora_B.T
        h = h + self.scaling * lora_out
        return h

    def merge_weights(self) -> nn.Linear:
        """
        LoRAを元の重みにマージして推論用にします。
        別途LoRA計算が不要 → オーバーヘッドゼロ。
        """
        merged = nn.Linear(
            self.original.in_features,
            self.original.out_features,
            bias=self.original.bias is not None
        )
        # W' = W + (α/r) × B × A
        merged.weight.data = (
            self.original.weight.data +
            self.scaling * self.lora_B @ self.lora_A
        )
        if self.original.bias is not None:
            merged.bias.data = self.original.bias.data
        return merged

def apply_lora_to_model(model: nn.Module,
                        rank: int = 16,
                        alpha: float = 16.0,
                        target_modules: list[str] = None):
    """
    モデルの指定モジュールにLoRAを適用します。
    target_modules:モジュール名パターンのリスト(例:["q_proj", "v_proj"])
    """
    if target_modules is None:
        target_modules = ["q_proj", "k_proj", "v_proj", "o_proj"]

    lora_params = 0
    frozen_params = 0

    for name, module in model.named_modules():
        if isinstance(module, nn.Linear):
            if any(t in name for t in target_modules):
                # LoRAバージョンに置き換え
                parent_name = ".".join(name.split(".")[:-1])
                child_name = name.split(".")[-1]
                parent = dict(model.named_modules())[parent_name]

                lora_layer = LoRALinear(module, rank=rank, alpha=alpha)
                setattr(parent, child_name, lora_layer)

                lora_params += rank * (module.in_features + module.out_features)
                frozen_params += module.in_features * module.out_features

    total = lora_params + frozen_params
    print(f"LoRA params:   {lora_params:>12,} ({lora_params/total*100:.2f}%)")
    print(f"Frozen params: {frozen_params:>12,} ({frozen_params/total*100:.2f}%)")
    return model

# --- 例:トイTransformerにLoRAを適用 ---
# model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-3-8B")
# model = apply_lora_to_model(model, rank=16, alpha=32)
# Output:
# LoRA params:        8,388,608 (0.39%)
# Frozen params:  2,147,483,648 (99.61%)
試験のヒント: 非常によく出る問題:「LoRAの初期化 — $B$はどのように初期化されるか?」→ $B$はゼロで初期化され、$A$はランダムに初期化されます。これにより学習開始時に$\Delta W = BA = 0$となり、モデルは事前学習済みのパフォーマンスから開始されます。
Q4: あるTransformer層の重み行列$W \in \mathbb{R}^{4096 \times 4096}$があります。LoRAをランク$r=8$で使用した場合、この単一層にLoRAアダプターが追加する学習可能パラメータ数はいくつですか?
- A) 8,192
- B) 32,768
- C) 65,536
- D) 16,777,216
回答と解説を表示
C) 65,536 ✓
LoRAパラメータ数 = $d \times r + r \times k = 4096 \times 8 + 8 \times 4096 = 32768 + 32768 = 65536$。比較:元の行列は$4096 \times 4096 = 16{,}777{,}216$パラメータです。LoRAは全パラメータの$65536 / 16777216 = 0.39\%$のみを使用します。選択肢Dはフル行列のサイズ、Aは半分が欠けており、Bは1つの行列のみをカウントしています。
6. QLoRAとメモリ効率的なファインチューニング
6.1. QLoRA — 量子化LoRA
QLoRA(Dettmers et al., 2023)は、凍結された重みに対する4ビット量子化とFP16/BF16のLoRAアダプターを組み合わせます。3つの主要技術:
- NF4(4-bit NormalFloat) — 正規分布する重み値に最適化された量子化フォーマット
- 二重量子化 — 量子化定数自体をさらに量子化 → 追加で約0.37ビット/パラメータ節約
- ページドオプティマイザー — GPUメモリが満杯の場合、オプティマイザーの状態をCPU RAMに自動オフロード
6.2. VRAM比較
| モデル | フルFT(FP16) | LoRA(FP16ベース) | QLoRA(NF4ベース) | コンシューマGPU? |
|---|---|---|---|---|
| Llama-3-8B | ~32 GB | ~18 GB | ~6 GB | ✓ RTX 3090/4090 |
| Llama-3-13B | ~52 GB | ~28 GB | ~10 GB | ✓ RTX 4090 24GB |
| Llama-3-70B | ~280 GB | ~160 GB | ~36 GB | ✗ A100 80GB必要 |
| Llama-3-405B | ~1.6 TB | ~900 GB | ~200 GB | ✗ マルチA100/H100 |
6.3. 判断ガイド:フルFT vs LoRA vs QLoRA
判断ツリー:どのファインチューニング手法を選ぶか?
══════════════════════════════════════════════════════════════

  開始:「LLMをファインチューニングしたい」
  │
  ├─ Q:多数のGPUと大規模データセット(>10万サンプル)がありますか?
  │  ├─ はい → フルファインチューニング(最高品質、最もコスト高)
  │  └─ いいえ ↓
  │
  ├─ Q:ベースモデルはFP16でGPUに収まりますか?
  │  ├─ はい → 標準LoRA
  │  │         • ランク16-32
  │  │         • ターゲット:q_proj, v_proj(最小構成)
  │  │         • α = r または 2r
  │  └─ いいえ ↓
  │
  ├─ Q:モデルは4ビットでGPUに収まりますか?
  │  ├─ はい → QLoRA(4ビットNF4)
  │  │         • LoRA設定は同じ
  │  │         • 追加:load_in_4bit=True
  │  │         • 追加:bnb_4bit_quant_type="nf4"
  │  │         • メモリ約3-4倍節約
  │  └─ いいえ → より多くのGPUまたは小さいモデルが必要
  │
  └─ 特殊ケース:
     • 非常に単純なタスク(フォーマット変更)→ Prompt Tuning
     • レイテンシオーバーヘッドゼロが必要 → LoRA + 重みマージ
     • マルチテナントサービング → LoRAアダプター(ユーザーごとにスワップ)
6.4. bitsandbytes + PEFTによるQLoRAセットアップ
import torch
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    TrainingArguments,
)
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training
from trl import SFTTrainer

# --- ステップ1:4ビット量子化の設定 ---
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",           # NormalFloat4
    bnb_4bit_compute_dtype=torch.bfloat16, # BF16で計算
    bnb_4bit_use_double_quant=True,       # 二重量子化
)

# --- ステップ2:4ビットでモデルをロード ---
model_name = "meta-llama/Meta-Llama-3-8B-Instruct"
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    quantization_config=bnb_config,
    device_map="auto",
    trust_remote_code=True,
)
tokenizer = AutoTokenizer.from_pretrained(model_name)
tokenizer.pad_token = tokenizer.eos_token

# kビット学習用にモデルを準備(凍結、キャスト、勾配チェックポイント有効化)
model = prepare_model_for_kbit_training(model)

# --- ステップ3:LoRA設定 ---
lora_config = LoraConfig(
    r=16,                      # ランク
    lora_alpha=32,             # Alpha(= 2*r)
    target_modules=[           # どの層を適応させるか
        "q_proj", "k_proj",
        "v_proj", "o_proj",
        "gate_proj", "up_proj", "down_proj",  # MLP層も含む
    ],
    lora_dropout=0.05,         # 正則化用ドロップアウト
    bias="none",               # バイアスは学習しない
    task_type="CAUSAL_LM",
)

# LoRAを適用
model = get_peft_model(model, lora_config)
model.print_trainable_parameters()
# Output: trainable params: 41,943,040 || all params: 8,030,261,248
#         || trainable%: 0.5223%

# --- ステップ4:学習 ---
training_args = TrainingArguments(
    output_dir="./lora-finetuned",
    num_train_epochs=3,
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,
    learning_rate=2e-4,
    weight_decay=0.01,
    warmup_ratio=0.03,
    lr_scheduler_type="cosine",
    logging_steps=10,
    save_strategy="epoch",
    bf16=True,                  # BF16混合精度を使用
    gradient_checkpointing=True, # メモリ節約
    optim="paged_adamw_32bit",  # ページドオプティマイザー
    report_to="mlflow",         # MLflowで追跡
)

trainer = SFTTrainer(
    model=model,
    args=training_args,
    train_dataset=train_dataset,  # 準備済みデータセット
    tokenizer=tokenizer,
    max_seq_length=2048,
    dataset_text_field="text",
)

# 学習開始!
trainer.train()

# --- ステップ5:LoRAアダプターを保存(フルモデルではなく~80MBのみ)---
trainer.model.save_pretrained("./lora-adapter-legal-qa")
試験のヒント: DLIの評価でよく問われます:「QLoRAがLoRAよりメモリ効率的な理由は?」→ 3つの要因:(1) NF4量子化がベースモデルを16ビットから4ビットに圧縮、(2) 二重量子化、(3) ページドオプティマイザー。LoRAアダプターはFP16/BF16のまま — 凍結された重みのみが量子化されます。
7. NeMo Customizerによるハンズオンファインチューニング
7.1. NeMo Customizerマイクロサービス
NeMo CustomizerはNVIDIA NeMoスタックのマイクロサービスで、NIMモデルに対するファインチューニングジョブ(LoRA、P-tuning、フルSFT)をREST API経由で起動できます。学習ループを書く必要はありません — 設定とデータを提供するだけです。
NeMo Customizer — ファインチューニングパイプライン
══════════════════════════════════════════════════════════════

  ┌──────────────────┐    ┌──────────────────┐
  │  学習データ       │    │  ベースモデル     │
  │  (JSONL形式)     │    │  (NIM経由)       │
  │                  │    │  Llama-3-8B-Inst │
  └────────┬─────────┘    └────────┬─────────┘
           │                       │
           ▼                       ▼
  ┌────────────────────────────────────────────┐
  │          NeMo Customizerサービス            │
  │                                            │
  │  POST /v1/customization/jobs               │
  │  {                                         │
  │    "model": "meta/llama-3.1-8b-instruct",│
  │    "training_type": "lora",                │
  │    "dataset": "/data/train.jsonl",         │
  │    "hyperparameters": {                    │
  │      "epochs": 3, "lr": 2e-4,             │
  │      "lora_rank": 16                       │
  │    }                                       │
  │  }                                         │
  └─────────────────────┬──────────────────────┘
                        │
             ジョブステータス:RUNNING → COMPLETED
                        │
                        ▼
  ┌────────────────────────────────────────────┐
  │  出力:LoRAアダプター重み                    │
  │  → NIMにマウントして推論                     │
  │  → NeMo Evaluatorで検証                     │
  │  → MLflowでベースモデルと比較               │
  └────────────────────────────────────────────┘
7.2. データセットの準備
import json

def prepare_sft_dataset(raw_data: list[dict],
                        output_path: str,
                        system_prompt: str = None):
    """
    NeMo Customizer SFT/LoRA学習用のデータをフォーマットします。
    入力形式:[{"question": "...", "answer": "..."}]
    出力:会話形式のJSONL。
    """
    formatted = []
    for item in raw_data:
        conversation = {"messages": []}

        if system_prompt:
            conversation["messages"].append({
                "role": "system",
                "content": system_prompt
            })

        conversation["messages"].append({
            "role": "user",
            "content": item["question"]
        })
        conversation["messages"].append({
            "role": "assistant",
            "content": item["answer"]
        })

        formatted.append(conversation)

    # シャッフルして訓練/検証を分割(90/10)
    import random
    random.shuffle(formatted)
    split_idx = int(len(formatted) * 0.9)
    train_data = formatted[:split_idx]
    val_data = formatted[split_idx:]

    # JSONLを書き出し
    for suffix, data in [("train", train_data), ("val", val_data)]:
        path = output_path.replace(".jsonl", f"_{suffix}.jsonl")
        with open(path, "w") as f:
            for item in data:
                f.write(json.dumps(item, ensure_ascii=False) + "\n")
        print(f"Wrote {len(data)} examples to {path}")

    return len(train_data), len(val_data)

# --- 例 ---
raw = [
    {"question": "What is Metformin indicated for?",
     "answer": "Metformin is the first-line treatment for type 2 diabetes..."},
    # ... 5000件以上の例を追加
]
prepare_sft_dataset(raw, "legal_qa.jsonl",
    system_prompt="You are a professional medical assistant. "
                  "Answer accurately based on evidence-based medicine.")
7.3. API経由で学習ジョブを起動
import requests

CUSTOMIZER_URL = "http://nemo-customizer:8080"

def launch_lora_job(model_name: str,
                    train_file: str,
                    val_file: str,
                    config: dict) -> str:
    """
    NeMo CustomizerでLoRAファインチューニングジョブを起動します。
    戻り値:job_id
    """
    payload = {
        "model": model_name,
        "training_type": "lora",
        "dataset": {
            "train": train_file,
            "validation": val_file,
        },
        "hyperparameters": {
            "epochs": config.get("epochs", 3),
            "learning_rate": config.get("lr", 2e-4),
            "batch_size": config.get("batch_size", 4),
            "lora_rank": config.get("rank", 16),
            "lora_alpha": config.get("alpha", 32),
            "lora_target_modules": config.get(
                "target_modules",
                ["q_proj", "k_proj", "v_proj", "o_proj"]
            ),
        },
        "output_model": f"lora-{model_name.split('/')[-1]}-custom",
    }

    response = requests.post(
        f"{CUSTOMIZER_URL}/v1/customization/jobs",
        json=payload
    )
    response.raise_for_status()
    job_id = response.json()["id"]
    print(f"Job launched: {job_id}")
    return job_id

def check_job_status(job_id: str) -> dict:
    """学習ジョブのステータスを確認します。"""
    resp = requests.get(
        f"{CUSTOMIZER_URL}/v1/customization/jobs/{job_id}"
    )
    result = resp.json()
    print(f"Status: {result['status']}, "
          f"Progress: {result.get('progress', 'N/A')}")
    return result

# --- 使用方法 ---
# job_id = launch_lora_job(
#     model_name="meta/llama-3.1-8b-instruct",
#     train_file="/data/legal_qa_train.jsonl",
#     val_file="/data/legal_qa_val.jsonl",
#     config={"epochs": 3, "rank": 16, "lr": 2e-4}
# )
# status = check_job_status(job_id)
7.4. LoRAアダプターを使った推論
from peft import PeftModel
from transformers import AutoModelForCausalLM, AutoTokenizer

def load_model_with_lora(base_model_name: str,
                         adapter_path: str):
    """ベースモデルをロードしてLoRAアダプターをマウントします。"""
    # ベースをロード
    base_model = AutoModelForCausalLM.from_pretrained(
        base_model_name,
        device_map="auto",
        torch_dtype=torch.bfloat16,
    )
    tokenizer = AutoTokenizer.from_pretrained(base_model_name)

    # LoRAアダプターをマウント
    model = PeftModel.from_pretrained(base_model, adapter_path)

    # オプション:より高速な推論のためにアダプターをベースにマージ
    # model = model.merge_and_unload()

    return model, tokenizer

def compare_base_vs_finetuned(question: str,
                               base_model, base_tok,
                               ft_model, ft_tok):
    """ベースモデルとファインチューニング済みモデルの出力を比較します。"""
    prompt = f"<|user|>\n{question}\n<|assistant|>\n"

    for label, model, tok in [
        ("BASE", base_model, base_tok),
        ("LoRA", ft_model, ft_tok),
    ]:
        inputs = tok(prompt, return_tensors="pt").to(model.device)
        outputs = model.generate(
            **inputs, max_new_tokens=256,
            temperature=0.1, do_sample=True
        )
        response = tok.decode(outputs[0], skip_special_tokens=True)
        print(f"\n{'='*50}")
        print(f"[{label}] {response}")
Q5: あるチームがNeMo Customizerを使用してLlama-3-8BをLoRA(rank=16)でファインチューニングしました。結果のアダプターファイルは約80 MBです。元のモデルは16 GBです。本番デプロイにおいて最も効率的なサービングアプローチはどれですか?
- A) フルの16 GBファインチューニング済みモデルを個別にデプロイする
- B) LoRA重みをベースモデルにマージし、16 GBのマージ済みモデルをデプロイする
- C) NIM経由でベースモデルを1つデプロイし、推論時にLoRAアダプターをマウントする
- D) より高速な推論のためにONNXフォーマットに変換する
回答と解説を表示
C) NIM経由でベースモデルを1つデプロイし、推論時にLoRAアダプターをマウントする ✓
NIMはLoRAアダプターのホットローディングをサポートしています — 1つのベースモデルがアダプター(~80MB)をスワップするだけで複数の顧客/ドメインに対応できます。選択肢Bは動作しますが、ストレージを浪費し、マルチテナントサービングをサポートしません。選択肢AはLoRAの利点を活かしていません。ONNXへの変換はアダプターサービングとは無関係の別の最適化です。
8. 最終評価戦略とチートシート
8.1. 評価フォーマットのまとめ
NVIDIA DLI Generative AI認定には複数のコース評価が含まれます:
| コースコード | トピック | 形式 | 時間 | 合格 |
|---|---|---|---|---|
| S-FX-14 | Generative AI with Diffusion Models | コーディング評価 | ~2時間 | 70% |
| S-FX-15 | Building RAG Agents with LLMs | コーディング + MCQ | ~2時間 | 70% |
| S-FX-34 | Build an AI Agent Reasoning App | コーディング評価 | ~2時間 | 70% |
| C-FX-25 | GenAI LLM Customization & Eval | コーディング + MCQ | ~2時間 | 70% |
8.2. よくある間違いと回避方法
- テンソルの次元の間違い:行列積の前に必ず
tensor.shapeで形状を確認する - 重みの凍結忘れ:LoRAはベースモデルを凍結する必要がある — そうしないとフルファインチューニングになる
- BLEUとROUGEの混同:BLEU = 精度、ROUGE = 再現率
- 簡潔性ペナルティの欠落:BLEUはn-gramマッチングだけでなく、BPも含める必要がある
- CFGの公式の間違い:$\epsilon_\theta = \epsilon_{uncond} + s \cdot (\epsilon_{cond} - \epsilon_{uncond})$、引き算の順序に注意
- Top-k vs Top-p:top-kは確率最上位k個のトークンを選択、top-pは累積確率がpに達するまでのトークンを選択
8.3. 時間管理戦略
- まず試験全体を読む(5分) — 簡単な問題と難しい問題を特定する
- コーディング問題を先にやる — 通常MCQより配点が高い
- MCQ:まず消去法 — 明らかに間違っている2つを除外し、残り2つから選ぶ
- 1つの問題に10分以上かけない — マークして後で戻る
- 最後の10分を確認用に残す(構文エラー、インポート漏れ)
8.4. クイックリファレンスチートシート
| カテゴリ | 公式 / パターン | キーポイント |
|---|---|---|
| Diffusion — 順方向 | $q(x_t|x_0) = \mathcal{N}(\sqrt{\bar\alpha_t}\,x_0,\;(1-\bar\alpha_t)\,I)$ | スケジュールに従いノイズを加える |
| Diffusion — 逆方向 | $p_\theta(x_{t-1}|x_t) = \mathcal{N}(\mu_\theta(x_t,t),\;\sigma_t^2 I)$ | U-Netがノイズ$\epsilon$を予測 |
| CFG | $\hat\epsilon = \epsilon_{uncond} + s(\epsilon_{cond} - \epsilon_{uncond})$ | $s=7.5$が典型、$s=1$ = ガイダンスなし |
| LoRA | $W' = W + \frac{\alpha}{r}BA$ | B=ゼロ初期化、A=ランダム初期化 |
| LoRAパラメータ | $r(d+k)$ / 層 | 通常全体の0.1-1% |
| BLEU | $BP \cdot \exp(\sum w_n \log p_n)$ | 精度ベース、翻訳用 |
| F1 | $\frac{2PR}{P+R}$ | トークン重複、QA用 |
| コサイン類似度 | $\frac{a \cdot b}{\|a\|\|b\|}$ | 埋め込みベースの意味マッチング |
| ELO | $R' = R + K(S - E)$ | K=32が典型、初期値=1500 |
| アテンション | $\text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right) V$ | スケールでsoftmaxの飽和を防ぐ |
| 交差エントロピー | $-\sum y_i \log(\hat{y}_i)$ | LLM学習の損失関数 |
| パープレキシティ | $2^{H(p)} = e^{\text{CE loss}}$ | 低いほど良い言語モデル |
8.5. PyTorchクイックリファレンス
import torch
import torch.nn as nn
import torch.nn.functional as F

# --- テンソル操作(評価でよく出る)---
x = torch.randn(2, 3, 4)       # 形状:(batch, seq, dim)
y = torch.randn(2, 4, 5)       # 形状:(batch, dim, out)
z = torch.bmm(x, y)            # バッチ行列積 → (2, 3, 5)
z = x @ y                      # 3Dの場合bmmと同じ
z = torch.einsum('bsd,bdo->bso', x, y)  # アインシュタイン表記

# リシェイプ操作
x = x.view(2, -1)              # 最後の2次元をフラット化 → (2, 12)
x = x.unsqueeze(1)             # 次元を追加 → (2, 1, 12)
x = x.squeeze(1)               # 次元を削除 → (2, 12)
x = x.permute(0, 2, 1)         # 次元をスワップ

# Softmax + temperature
logits = torch.randn(1, 50257)  # 語彙のロジット
temp = 0.7
probs = F.softmax(logits / temp, dim=-1)

# Top-kサンプリング
top_k = 50
top_k_vals, top_k_idx = torch.topk(probs, top_k)
sampled = torch.multinomial(top_k_vals, 1)

# Top-p(核)サンプリング
sorted_probs, sorted_idx = torch.sort(probs, descending=True)
cumsum = torch.cumsum(sorted_probs, dim=-1)
mask = cumsum - sorted_probs > 0.9  # p=0.9
sorted_probs[mask] = 0.0
sorted_probs /= sorted_probs.sum()
sampled = torch.multinomial(sorted_probs, 1)

# 損失関数
loss_fn = nn.CrossEntropyLoss()
loss = loss_fn(logits, targets)  # logits: (B, V), targets: (B,)
8.6. LangChain / LangGraphパターンリファレンス
# --- RAGパターン ---
# 1. ロード → 2. 分割 → 3. 埋め込み → 4. 格納 → 5. 検索 → 6. 生成
from langchain_text_splitters import RecursiveCharacterTextSplitter
splitter = RecursiveCharacterTextSplitter(
    chunk_size=512, chunk_overlap=50
)

# --- 構造化出力 ---
from pydantic import BaseModel
class Answer(BaseModel):
    reasoning: str
    answer: str
    confidence: float

chain = prompt | llm.with_structured_output(Answer)

# --- LangGraphステートマシン ---
from langgraph.graph import StateGraph, START, END
graph = StateGraph(MyState)
graph.add_node("agent", agent_fn)
graph.add_node("tools", tool_fn)
graph.add_edge(START, "agent")
graph.add_conditional_edges("agent", should_continue,
    {"continue": "tools", "end": END})
graph.add_edge("tools", "agent")
app = graph.compile()
8.7. DLI評価における頻出コンセプトトップ
| # | コンセプト | 頻度 | 典型的な出題形式 |
|---|---|---|---|
| 1 | Diffusion順方向/逆方向プロセス | ★★★★★ | コード穴埋め、公式の説明 |
| 2 | LoRAランク、alpha、パラメータ数 | ★★★★★ | パラメータ計算、設定の選択 |
| 3 | RAGチャンキング戦略 | ★★★★☆ | ユースケースに合ったchunk_sizeの選択 |
| 4 | BLEU vs ROUGE vs F1 | ★★★★☆ | メトリクスとタスクのマッチング |
| 5 | Classifier-Free Guidance | ★★★★☆ | CFG公式のコード、スケールの選択 |
| 6 | LangChain LCELチェーン | ★★★☆☆ | |演算子でパイプラインを構築 |
| 7 | アテンション機構 | ★★★☆☆ | スケーリングドット積の実装 |
| 8 | NIMデプロイ | ★★★☆☆ | Docker compose、API設定 |
| 9 | Guardrails / NeMo Guardrails | ★★☆☆☆ | トピカルレールの設定 |
| 10 | マルチエージェントパターン | ★★☆☆☆ | supervisor vs swarmの選択 |
試験のヒント: 上位5つのコンセプトに復習を集中させましょう — 問題の約70%を占めます。Diffusionの公式とLoRAが最も頻繁に出題されます。常に覚えておきましょう:LoRAでは$B$はゼロで初期化される、CFGのガイダンススケール$s$を上げる → 出力がプロンプトにより忠実になる。
9. 練習問題 — 完全模擬試験
シリーズ全10課をカバーする15問の模擬試験問題です。推奨所要時間:45分。
Diffusion Models(Q1–Q4)
Q1 🟢(易): Denoising Diffusion Probabilistic Model(DDPM)の順方向プロセスでは、画像$x_0$に$T$タイムステップにわたってノイズが加えられます。順方向プロセスについて正しい記述はどれですか?
- A) 順方向プロセスではノイズスケジュールを学習するためにニューラルネットワークが必要
- B) タイムステップ$T$において、$x_T$は標準ガウス分布$\mathcal{N}(0, I)$に近似する
- C) 順方向プロセスでは画像からノイズが徐々に除去される
- D) 順方向プロセスの各ステップは学習された変換である
回答と解説を表示
B ✓
順方向プロセスは固定スケジュールに従ってノイズを加えます(ニューラルネットワークは不要 → Aは誤り、Dは誤り)。逆方向プロセスがノイズ除去のステップ → Cは誤り。十分に大きな$T$では、$\bar\alpha_T \to 0$のため$x_T \sim \mathcal{N}(0, I)$となります。
Q2 🟡(中): 以下のClassifier-Free Guidanceのコードで、guidance_scale = 1.0の場合の出力は何ですか?
def cfg_predict(model, x_t, t, text_emb, guidance_scale):
    noise_cond = model(x_t, t, text_emb)
    noise_uncond = model(x_t, t, null_emb)
    return noise_uncond + guidance_scale * (noise_cond - noise_uncond)
- A) 純粋な無条件生成(テキストプロンプトを無視)
- B) 標準的な条件付き生成(CFGなしと同等)
- C) テキストプロンプトへの2倍のガイダンス強度
- D) 関数がエラーを発生させる
回答と解説を表示
B ✓
$s=1.0$の場合:$\epsilon_{uncond} + 1.0 \times (\epsilon_{cond} - \epsilon_{uncond}) = \epsilon_{cond}$。これは単純にガイダンスの増幅なしの標準的な条件付き出力です。$s=0$ → 純粋な無条件(A)。$s>1$(例:7.5)→ 増幅されたガイダンス。$s=2$ → 2倍の強度(C)。
Q3 🟡(中): Diffusionモデルで使用されるU-Netアーキテクチャにはエンコーダパスとデコーダパスがあります。対応するエンコーダ層とデコーダ層間のスキップ接続の主な目的は何ですか?
- A) モデルの総パラメータ数を削減するため
- B) ダウンサンプリング中に失われる可能性のある細かい空間的詳細を保持するため
- C) 順方向プロセス中にノイズスケジュールを実装するため
- D) クロスアテンションによるテキスト条件付き生成を可能にするため
回答と解説を表示
B ✓
スキップ接続はエンコーダ層(高解像度)と対応するデコーダ層をリンクし、ダウンサンプリング中に失われた空間的詳細をデコーダが回復するのを助けます。クロスアテンション(D)はテキスト条件付けのための別のメカニズムです。スキップ接続はパラメータを削減しません(A)し、ノイズスケジュールも実装しません(C)。
Q4 🔴(難): あるチームがCLIPを使用してテキストと画像の両方を共有埋め込み空間にエンコードしています。学習時のCLIP損失関数は:
# 簡略化したCLIPコントラスティブ損失
logits = (image_embeds @ text_embeds.T) * temperature
labels = torch.arange(len(logits))
loss_i2t = F.cross_entropy(logits, labels)
loss_t2i = F.cross_entropy(logits.T, labels)
loss = (loss_i2t + loss_t2i) / 2
loss_i2tとloss_t2iの両方を計算する目的は何ですか?
- A) モデルが画像生成とテキスト生成の両方を学習するため
- B) アラインメントを対称的にするため — 画像→テキストマッチングとテキスト→画像マッチングの両方
- C) モダリティをスワップすることでデータ拡張を実装するため
- D) 画像とテキストのバッチサイズが異なるケースに対応するため
回答と解説を表示
B ✓
CLIPは対称コントラスティブ損失を使用します:loss_i2tは各画像が正しいテキストに一致することを保証し(画像→テキスト)、loss_t2iは各テキストが正しい画像に一致することを保証します(テキスト→画像)。勾配の流れの観点から類似度行列は必ずしも対称ではないため、両方向が必要です。CLIPは画像やテキストを生成しません(A)、データ拡張も行いません(C)、バッチサイズは常に同じです(D)。
RAGとLLMアプリケーション(Q5–Q8)
Q5 🟢(易): RAGパイプラインでは、ドキュメントは埋め込み前にチャンクに分割されます。あるチームがセクション間の複雑な相互参照を持つ法的契約書を処理しています。最も適切なチャンキング戦略はどれですか?
- A) オーバーラップなしの100トークン固定サイズチャンク
- B) 文レベルの分割
- C) 512トークン、50トークンオーバーラップの再帰的文字分割
- D) ドキュメントごとの単一チャンク(分割なし)
回答と解説を表示
C ✓
法的契約書には相互参照があるため、境界でコンテキストを失わないようにオーバーラップが必要です。100トークン固定は小さすぎてコンテキスト不足です(A)。文レベルは法的文書には細かすぎます(B)。単一チャンクは大きすぎてコンテキストウィンドウと埋め込みモデルの制限を超えます(D)。512 + 50のオーバーラップを持つ再帰的分割がセマンティックな一貫性を維持します。
Q6 🟡(中): RAGシステムがクエリ「What is the treatment for Type 2 diabetes?」に対して以下のトップ3チャンクを検索しました:
Chunk 1: "Metformin is the first-line treatment for Type 2 diabetes..."
Chunk 2: "Type 1 diabetes requires insulin injections from diagnosis..."
Chunk 3: "Lifestyle modifications including diet and exercise are recommended
          alongside pharmacological treatment for Type 2 diabetes..."
Chunk 2が無関係であることを最もよく検出できるRAG評価メトリクスはどれですか?
- A) 回答F1スコア
- B) コンテキスト関連性(検索されたチャンクがクエリに関連しているかを測定)
- C) 忠実性(回答がコンテキストに基づいているかを測定)
- D) クエリとチャンク間のBLEUスコア
回答と解説を表示
B ✓
コンテキスト関連性は検索されたチャンクが実際にクエリに関連しているかを測定します — Chunk 2がType 1(Type 2ではない)について述べていることを検出できます。忠実性は回答 vs コンテキストを測定します(C)。回答F1は最終回答 vs 正解を測定します(A)。BLEUは浅いキーワード重複しか提供しません(D)。
Q7 🟡(中): ある開発者が以下のLCEL式でLangChainチェーンを構築しました:
chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | prompt_template
    | llm
    | StrOutputParser()
)
result = chain.invoke("What is LoRA?")
このチェーンでRunnablePassthrough()は何をしていますか?
- A) 入力を変更せずにディクショナリの「question」キーに渡す
- B) retrieverステップをスキップしてLLMに直接渡す
- C) 入力をキャッシュしてチェーン内で後から使用する
- D) 入力をセマンティック検索用の埋め込みに変換する
回答と解説を表示
A ✓
RunnablePassthrough()は入力(「What is LoRA?」)を受け取り、変更せずに「question」キーに渡します。一方、「context」キーは同じ入力でretrieverを実行します。結果:prompt_templateはdict {"context": retrieved_docs, "question": "What is LoRA?"}を受け取ります。ステップをスキップしません(B)、キャッシュしません(C)、埋め込みを行いません(D)。
Q8 🔴(難): NeMo Guardrailsを使用して、カスタマーサービスチャットボットが競合他社について話し合うのを防止しています。以下のColang設定が提供されています:
define user ask about competitor
  "What do you think about ProductX?"
  "Is CompetitorY better than your product?"
  "Compare your product with CompetitorZ"

define flow
  user ask about competitor
  bot refuse competitor question
  bot offer alternative help

define bot refuse competitor question
  "I'm focused on helping you with our products. I can't compare with other brands."

define bot offer alternative help
  "Would you like me to help you find the right product from our range?"
ユーザーが「I heard CompetitorY has faster delivery. Can you match that?」と書きました。ガードレールはトリガーされません。最も可能性の高い理由はどれですか?
- A) Colangフローの構文にエラーがある
- B) 正規例が「配送比較」のインテントをカバーしていない — 直接的な製品比較のみ
- C) NeMo Guardrailsはユーザーメッセージ中のエンティティ名を検出できない
- D) ボットのレスポンスはフローの前に定義される必要がある
回答と解説を表示
B ✓
NeMo Guardrailsは正規例を使用してユーザーインテントをマッチングします。提供された例は「製品比較」と「競合他社への意見」のみをカバーしており、「配送比較」をカバーする例がありません。「Does CompetitorY deliver faster?」のような例を追加すればこのインテントをカバーできます。Colangの構文は正しく(Aは誤り)、NeMo Guardrailsはエンティティを検出できます(Cは誤り)、定義順は関係ありません(Dは誤り)。
Agentic AI(Q9–Q11)
Q9 🟢(易): LangGraphにおいて、Stateオブジェクトは何に使用されますか?
- A) 推論中にLLMモデルの重みを保存するため
- B) グラフノード間を流れる共有データ(メッセージ、コンテキスト)を維持するため
- C) グラフのビジュアルレイアウトを定義するため
- D) LLMのtemperatureとtop-pパラメータを設定するため
回答と解説を表示
B ✓
LangGraphのStateはTypedDictまたはPydanticモデルで、ノード間で渡される共有データ(メッセージ、中間結果、フラグ)を含みます。各ノードはStateを受け取り、処理し、更新されたStateを返します。モデルの重み(A)、レイアウト(C)、LLM設定(D)とは無関係です。
Q10 🟡(中): あるチームが「Manager」エージェントが現在の状態に基づいて「Researcher」と「Writer」のサブエージェントにタスクを委任するマルチエージェントシステムを構築しています。これはどのパターンの例ですか?
- A) Swarmパターン
- B) 階層型 / Supervisorパターン
- C) ピアツーピアパターン
- D) パイプラインパターン
回答と解説を表示
B ✓
Manager → サブエージェントは典型的なSupervisor/階層パターンです:1つの中央エージェントがルーター/オーケストレーターとして機能します。Swarm(A)= エージェントがリーダーなしで自己調整。ピアツーピア(C)= エージェントが対等な立場で直接通信。パイプライン(D)= 固定された順次フロー。
Q11 🔴(難): 以下のLangGraphコードはツール呼び出し付きのエージェントを定義しています。should_continue関数が常に"continue"を返す場合、何が起こりますか?
from langgraph.graph import StateGraph, START, END

def should_continue(state):
    if state["messages"][-1].tool_calls:
        return "continue"
    return "end"

graph = StateGraph(AgentState)
graph.add_node("agent", call_model)
graph.add_node("tools", tool_node)
graph.add_edge(START, "agent")
graph.add_conditional_edges("agent", should_continue,
    {"continue": "tools", "end": END})
graph.add_edge("tools", "agent")
app = graph.compile()
- A) グラフは1回実行して正常に終了する
- B) グラフは「agent」と「tools」ノード間で無限ループに入る
- C) グラフはコンパイルエラーを発生させる
- D) 「tools」ノードが終了処理を行う
回答と解説を表示
B ✓
should_continueが常に"continue"を返す場合:agent → tools → agent → tools → ... ENDに到達しません。これが本番のエージェントにrecursion_limit(LangGraphのデフォルトは25)または明示的な終了条件が必要な理由です。グラフは正常にコンパイルされます(Cは誤り)が、ランタイムで無限ループに陥ります。
評価とファインチューニング(Q12–Q15)
Q12 🟢(易): テキスト要約の評価に一般的に使用される再現率指向のメトリクスは次のうちどれですか?
- A) BLEU
- B) ROUGE
- C) パープレキシティ
- D) pass@k
回答と解説を表示
B ✓
ROUGE(Recall-Oriented Understudy for Gisting Evaluation)— 名前が示す通り:再現率指向、要約のために設計されています。BLEUは翻訳用の精度指向です(A)。パープレキシティは言語モデルの品質を測定します(C)。pass@kはコード生成用です(D)。
Q13 🟡(中): LoRAファインチューニングにおいて、行列$B \in \mathbb{R}^{d \times r}$と$A \in \mathbb{R}^{r \times k}$が学習されます。行列$B$はどのように初期化され、その理由は何ですか?
- A) ランダム初期化 — ニューロン間の対称性を破るため
- B) 単位行列 — 元のモデルの動作を保持するため
- C) ゼロ — 学習開始時に$\Delta W = BA = 0$となり、事前学習済み重みを保持するため
- D) Xavier初期化 — 勾配の流れを維持するため
回答と解説を表示
C ✓
$B$はゼロで初期化、$A$はランダム(Kaiming)で初期化されます。学習開始時:$\Delta W = BA = 0 \cdot A = 0$なので、$W' = W + 0 = W$(事前学習済み重み)。モデルは事前学習済みのパフォーマンスから正確に学習を開始し、混乱を起こしません。これはLoRA論文における重要な設計上の決定です。
Q14 🟡(中): ある企業が法律文書分析のためにLlama-3-70Bをファインチューニングします。NVIDIA A100 80GB GPUが1枚あります。どのアプローチを使用できますか?
- A) 勾配チェックポイント付きのフルファインチューニング
- B) FP16ベースモデルでの標準LoRA
- C) 4ビットNF4量子化のQLoRA
- D) BとCの両方がA100 80GB 1枚で動作する
回答と解説を表示
C ✓
Llama-3-70BのFP16は重みだけで~140GB → A100 80GBではフルFT(Aは誤り)やLoRA FP16(Bは誤り、~160GB必要)には不十分です。QLoRA 4ビット:重み~35GB + オプティマイザー → A100 80GBに収まります。Bが収まらないのでDは誤りです。
Q15 🔴(難): あるデータサイエンティストがNeMo Evaluatorを実行して、法律QAデータセットでベースモデルとLoRAファインチューニング済みモデルを比較しました。結果:
| モデル | BLEU | ROUGE-L | F1 | ジャッジ正確性(1-5) | レイテンシp95 |
|---|---|---|---|---|---|
| ベースLlama-3-8B | 0.18 | 0.35 | 0.52 | 3.1 | 1.2s |
| LoRA(r=16) | 0.29 | 0.48 | 0.71 | 4.2 | 1.3s |
チームはLoRAモデルのデプロイを決定しました。この決定を最もよく正当化する記述はどれですか?
- A) BLEUが61%向上しており、QAで最も重要なメトリクスである
- B) すべてのメトリクスがレイテンシのわずかな増加で大幅に改善され、LLMジャッジの正確性が3.1から4.2に上昇した(35%の改善)
- C) レイテンシの1.2sから1.3sへの増加は無視できる程度であり、これが主要な懸念事項である
- D) ROUGE-Lが0.35から0.48に改善しており、モデルがより良い要約を生成していることを示している
回答と解説を表示
B ✓
デプロイの決定は全体的な改善に基づいています:F1(QAの主要メトリクス)が0.52→0.71に大幅に改善、ジャッジの正確性(人間評価に最も近い)が3.1→4.2に改善、レイテンシはほぼ変わらず。Aは誤り:BLEUはQAの主要メトリクスではない。Cは正しいが決定を「正当化」していない — レイテンシは1つの要因に過ぎない。Dは誤り:ROUGEは要約用であり、これはQAタスクです。
10. シリーズのまとめと次のステップ
10.1. 全10課の学習の旅
シリーズ「NVIDIA DLI 試験対策 — Generative AI with Diffusion Models & LLMs」の完走おめでとうございます!学んだ内容を振り返りましょう:
| 課 | トピック | キーポイント |
|---|---|---|
| 1 | Generative AIの概要 | 分類体系:VAE → GAN → Diffusion → Transformer LLM |
| 2 | Diffusion ModelsとDDPM | 順方向ノイズ+逆方向ノイズ除去、U-Netが$\epsilon$を予測 |
| 3 | Stable DiffusionとCLIP | 潜在空間でのDiffusion、クロスアテンションによるテキスト条件付け |
| 4 | LLMの基礎 | Transformerアテンション、トークナイゼーション、生成戦略 |
| 5 | プロンプトエンジニアリング | Zero/few-shot、CoT、構造化出力、システムプロンプト |
| 6 | RAGパイプライン | チャンキング → 埋め込み → ベクトルDB → 検索 → 生成 |
| 7 | LangChainとNIM | LCELチェーン、NIMデプロイ、ガードレール |
| 8 | ツール呼び出しと構造化出力 | 関数呼び出し、Pydanticスキーマ、ReActループ |
| 9 | Agentic AIとマルチエージェント | LangGraph、supervisorパターン、ステートマシン |
| 10 | 評価とLoRAファインチューニング | BLEU/ROUGE/F1、LLM-as-Judge、LoRA/QLoRA、NeMo |
10.2. 推奨DLIコース受講順
認定を取得するには、DLIコースを以下の順序で完了してください:
- Generative AI with Diffusion Models(S-FX-14)— Diffusion理論+コーディングラボ
- Building RAG Agents with LLMs(S-FX-15)— RAGパイプライン+LangChain+NIM
- Build an AI Agent Reasoning App(S-FX-34)— Agentic AI+LangGraph
- GenAI and LLM Customization and Evaluation(C-FX-25)— LoRA、QLoRA、NeMo Evaluator
各コースには独自の評価があります。4つすべてを完了すると → NVIDIA DLI Generative AI Certificateを取得できます。
10.3. 学習を続けるためのヒント
- KaggleやHuggingFaceで実践する — 実際のデータセットで実際のモデルをファインチューニング
- 論文を読む — LoRA、QLoRA、RAG、DDPMの論文はすべてアクセスしやすく、優れた試験準備になります
- プロジェクトを構築する — RAGチャットボット、マルチエージェントシステム、特定ドメイン向けのカスタムファインチューニングモデル
- コミュニティに参加する — NVIDIA Developer Forums、HuggingFace Discord、LangChain Discord
- 最新情報を追い続ける — AIは急速に進化します。NVIDIA Blog、arXivのデイリーペーパーをフォロー
最後のヒント: DLIの評価は純粋な理論よりも実践的な応用に重点を置いていることを忘れないでください。コードを理解し、スクラッチから実装できれば(このシリーズの例のように)、合格できます。試験の成功をお祈りします!