はじめに
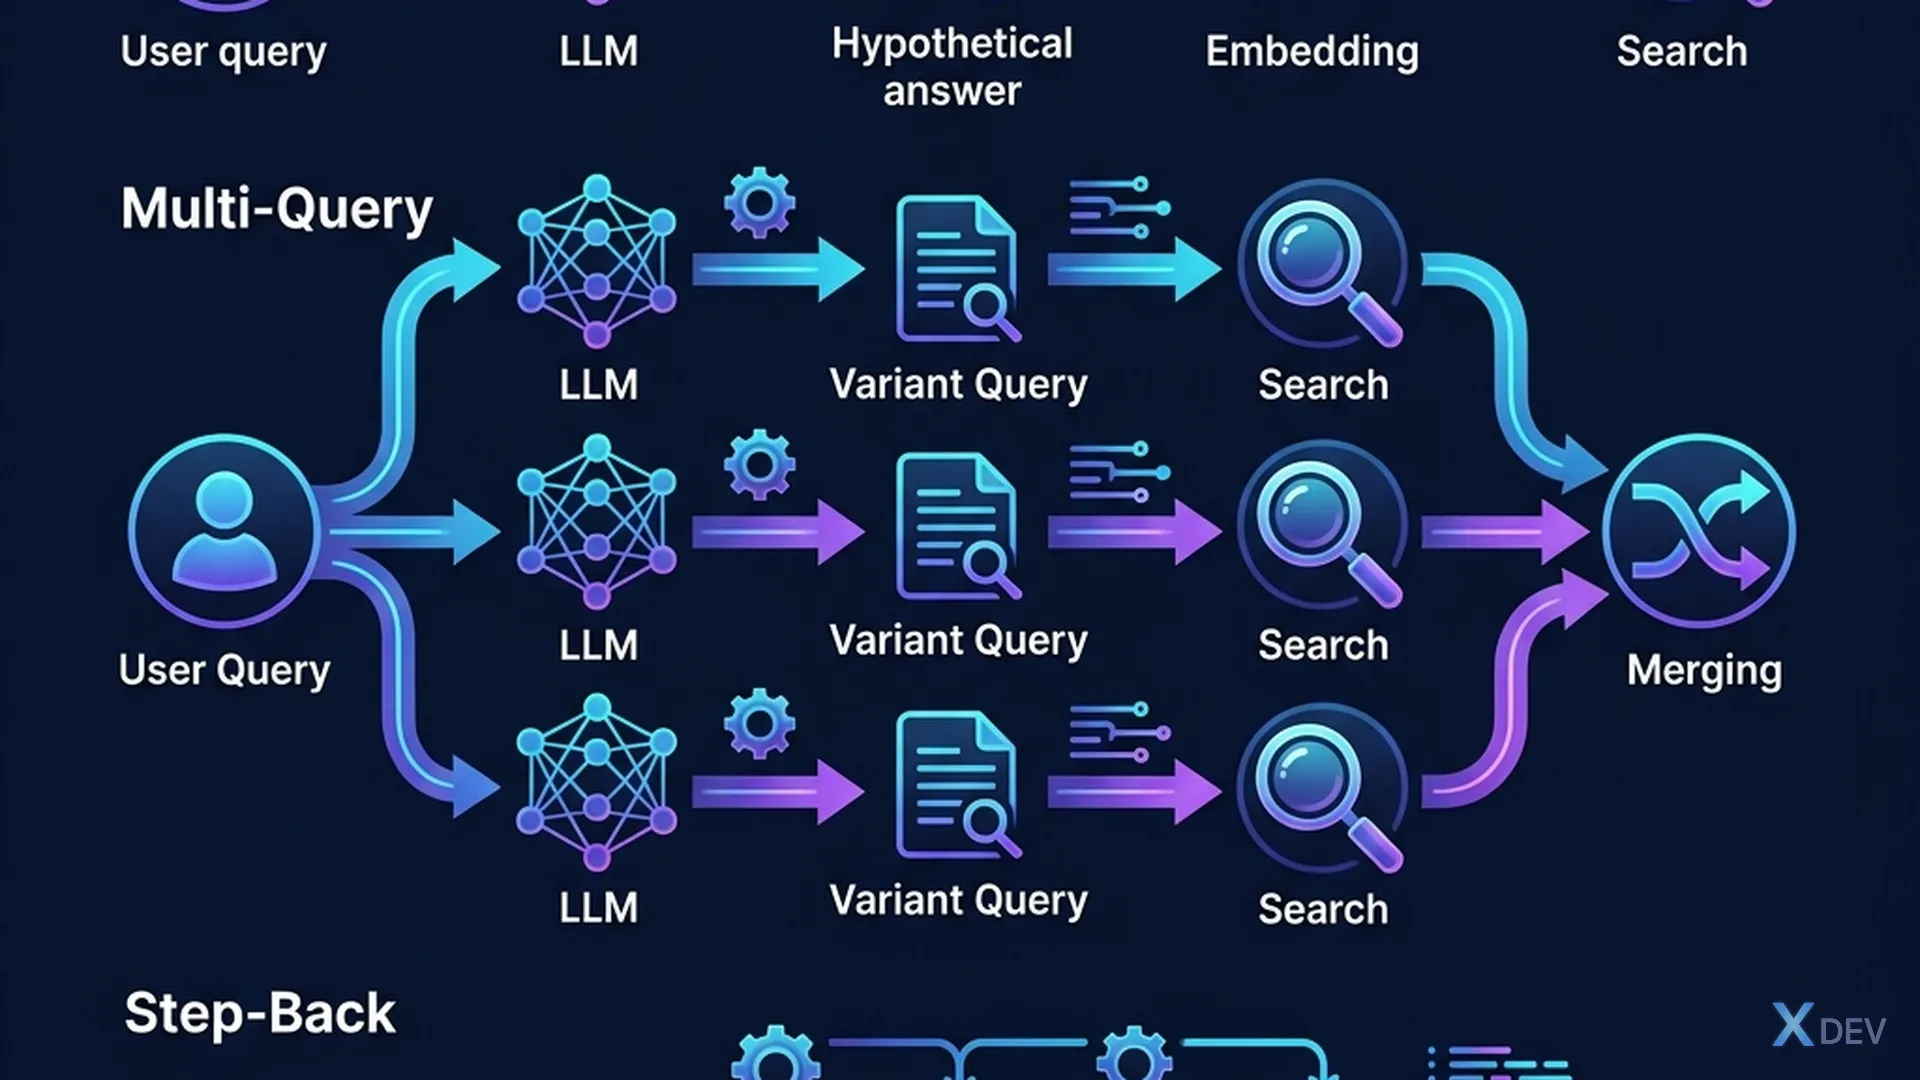
ユーザーの質問は、短すぎたり、曖昧であったり、文献外の言葉が使われていたりするため、検索には理想的ではありません。クエリ変換は、元のクエリを 取得に最適な形式に変換します。
例: ユーザーが「休暇はどうですか?」と尋ねます。 →曖昧すぎる。次のように変形します。
- 「年次休暇申請プロセスと承認手順」
- 「正社員・パート社員の休暇日数」
- 「従業員に緊急の用事がある場合の休暇に関するポリシー」 → 3 つの異なる側面を求める 3 つのクエリ!
この記事では、次の 3 つの主要なテクニックについて説明します。
| エンジニアリング | アイデア | いつ使用するか |
|---|---|---|
| マルチクエリ | 質問のさまざまなバリエーションを生成する | 漠然とした多面的な質問 |
| ハイデ | 本当の答えを見つけるために「偽の答え」を作成する | 短いクエリ、異なるドキュメント言語 |
| ステップバック | まず概要について質問する | 質問が具体的すぎます |
1. マルチクエリ — 複数のバリエーションを生成する
1.1 問題
User query:    "lương thế nào?"
Vector search: tìm 1 lần → có thể miss "chế độ đãi ngộ", "phúc lợi"

Multi-Query:   "lương thế nào?" → LLM sinh 3 queries:
               Q1: "Mức lương cơ bản và bậc lương"
               Q2: "Chế độ đãi ngộ, thưởng, phúc lợi"
               Q3: "Quy trình review và tăng lương"
               → Search 3 lần → merge kết quả → cover nhiều khía cạnh!
1.2 実装
"""Multi-Query Retriever — tự sinh nhiều câu hỏi biến thể"""
from langchain.retrievers import MultiQueryRetriever
from langchain_openai import ChatOpenAI
from langchain_community.vectorstores import Chroma

llm = ChatOpenAI(model="gpt-4o-mini", temperature=0.3)
vectorstore = Chroma(...)  # Đã index sẵn

retriever = MultiQueryRetriever.from_llm(
    retriever=vectorstore.as_retriever(search_kwargs={"k": 3}),
    llm=llm,
)

# Nội bộ: LLM sinh 3 câu hỏi khác nhau, search mỗi câu, merge kết quả
results = retriever.invoke("lương thế nào?")
# Trả về documents từ CẢ 3 queries (đã deduplicate)
1.3 マルチクエリ用のカスタム プロンプト
"""Custom prompt — kiểm soát cách sinh biến thể"""
from langchain.prompts import PromptTemplate

MULTI_QUERY_PROMPT = PromptTemplate(
    input_variables=["question"],
    template="""Bạn là AI assistant. Nhiệm vụ: sinh 3 câu hỏi biến thể
cho câu hỏi gốc, mỗi câu tập trung 1 khía cạnh khác nhau.

Câu hỏi gốc: {question}

Sinh 3 câu hỏi (mỗi câu 1 dòng, không đánh số):""",
)

retriever = MultiQueryRetriever.from_llm(
    retriever=vectorstore.as_retriever(),
    llm=llm,
    prompt=MULTI_QUERY_PROMPT,
)
💡 演習 1: マルチクエリ リトリーバーを実装します。 10 個のテスト文に対する単一クエリと複数クエリの検索再現率の比較。マルチクエリはより多くの側面をカバーしますか?
2. HyDE — 仮説的なドキュメントの埋め込み
2.1 アイデア
Vấn đề: User query (câu hỏi) và document (đáp án)
         có dạng KHÁC NHAU → embedding khác nhau

Query:   "Nghỉ phép bao nhiêu ngày?"     → embedding Q
Doc:     "Nhân viên full-time được 15     → embedding D
          ngày phép mỗi năm."

Q và D có thể cách xa nhau trong vector space!

HyDE giải quyết:
1. LLM tạo "đáp án giả" từ câu hỏi (hypothetical document)
2. Embed đáp án giả → gần hơn với đáp án thật
3. Dùng embedding đáp án giả để tìm đáp án thật

Query:      "Nghỉ phép bao nhiêu ngày?"
            ↓ LLM generate
HyDE doc:   "Theo chính sách công ty, nhân viên toàn thời gian
             được hưởng 15 ngày nghỉ phép có lương mỗi năm..."
            ↓ embed
HyDE embed: [0.45, 0.12, ...]  ← GẦN với doc thật hơn!
            ↓ search
Real doc:   "Nhân viên full-time: 15 ngày phép/năm" ← MATCH!
2.2 実装
"""HyDE — Hypothetical Document Embeddings"""
from langchain.chains import HypotheticalDocumentEmbedder
from langchain_openai import ChatOpenAI, OpenAIEmbeddings

llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
embeddings = OpenAIEmbeddings(model="text-embedding-3-small")

# HyDE embedder: wrap LLM + embedding
hyde_embeddings = HypotheticalDocumentEmbedder.from_llm(
    llm=llm,
    base_embeddings=embeddings,
    prompt_key="web_search",  # Hoặc custom prompt
)

# Dùng HyDE embeddings thay OpenAIEmbeddings trong retriever
vectorstore = Chroma(
    collection_name="docs",
    embedding_function=hyde_embeddings,  # ← HyDE thay vì direct
)

retriever = vectorstore.as_retriever(search_kwargs={"k": 5})
results = retriever.invoke("Nghỉ phép bao nhiêu ngày?")
2.3 カスタム HyDE プロンプト
"""Custom prompt cho HyDE — kiểm soát chất lượng hypothetical doc"""
from langchain.prompts import PromptTemplate

HYDE_PROMPT = PromptTemplate(
    input_variables=["question"],
    template="""Viết 1 đoạn văn ngắn (50-100 từ) trả lời câu hỏi sau,
giả sử bạn đang viết tài liệu chính thức cho công ty:

Câu hỏi: {question}

Đoạn trả lời:""",
)

hyde_embeddings = HypotheticalDocumentEmbedder(
    llm_chain=LLMChain(llm=llm, prompt=HYDE_PROMPT),
    base_embeddings=embeddings,
)
2.4 HyDE をいつ使用するか?
| シナリオ | HyDEって効果あるの? | 理由 |
|---|---|---|
| 短いクエリ (2 ~ 3 ワード) | ✅ | コンテキストが豊富な段落に展開します |
| 質問形式のクエリ、物語形式のドキュメント | ✅ | ブリッジギャップの質問↔回答 |
| クロスランゲージ(ベトナム語に質問、英語を読む) | ✅ | LLM は同じ言語のドキュメントを生成します。 |
| 質問は明確で長かった | ❌ | HyDE はノイズを追加します |
| リアルタイム (遅延が重要) | ❌ | もう 1 つの LLM 呼び出し = 遅くなります |
💡 演習 2: 取得精度を比較します: 直接埋め込みと HyDE。 10 個の短い質問 (2 ~ 3 単語) を使用します。 HyDE はどれくらい優れていますか?
3. ステップバックプロンプト
3.1 アイデア
Câu hỏi quá CỤ THỂ: "Nhân viên bộ phận Kế toán nghỉ phép
                       ngày 31/12 có được không?"

Vector search: không tìm thấy (quá cụ thể, không ai viết exact match)

Step-Back: Lùi 1 bước → hỏi câu TỔNG QUÁT trước:
           "Quy định nghỉ phép vào ngày lễ, cuối năm?"
           → Tìm được! Rồi kết hợp context trả lời câu cụ thể.
3.2 実装
"""Step-Back Prompting cho RAG"""
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate

llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

# Step 1: Generate step-back question
step_back_prompt = ChatPromptTemplate.from_messages([
    ("system", """Bạn là expert tạo câu hỏi tổng quát hơn.
Cho 1 câu hỏi cụ thể, tạo câu hỏi TỔNG QUÁT hơn 1 bậc
để tìm kiếm context rộng hơn."""),
    ("human", "Câu hỏi: {question}\n\nCâu hỏi tổng quát hơn:"),
])

step_back_chain = step_back_prompt | llm

# Step 2: Search cả câu gốc + step-back
def step_back_retrieval(question: str, retriever):
    # Tạo step-back question
    step_back_q = step_back_chain.invoke({"question": question}).content

    # Search cả 2
    original_docs = retriever.invoke(question)
    step_back_docs = retriever.invoke(step_back_q)

    # Merge + deduplicate
    all_docs = original_docs + step_back_docs
    seen = set()
    unique_docs = []
    for doc in all_docs:
        key = doc.page_content[:100]
        if key not in seen:
            seen.add(key)
            unique_docs.append(doc)

    return unique_docs

results = step_back_retrieval(
    "Nhân viên Kế toán nghỉ phép ngày 31/12 có được không?",
    retriever
)
4. 複数のテクニックを組み合わせる
4.1 実際のパイプライン
User query
    │
    ├──→ Multi-Query (sinh 3 biến thể)
    │        │
    │        ├──→ Query 1 → Vector search → docs_1
    │        ├──→ Query 2 → Vector search → docs_2
    │        └──→ Query 3 → Vector search → docs_3
    │
    ├──→ Step-Back (câu tổng quát)
    │        └──→ BM25 search → docs_4
    │
    └──→ HyDE (hypothetical doc)
             └──→ Vector search → docs_5

    Merge all → Deduplicate → Re-rank (bài tiếp theo) → Top K
4.2 ルーティング — クエリの種類に応じて戦略を選択する
"""Router: tự chọn strategy phù hợp với câu hỏi"""
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate

router_prompt = ChatPromptTemplate.from_messages([
    ("system", """Phân loại câu hỏi thành 1 trong 3 loại:
- MULTI_QUERY: câu hỏi mơ hồ, nhiều khía cạnh
- HYDE: câu hỏi ngắn, khó match trực tiếp
- STEP_BACK: câu hỏi quá cụ thể, cần context rộng
- DIRECT: câu hỏi rõ ràng, không cần transform

Chỉ trả lời 1 từ: MULTI_QUERY, HYDE, STEP_BACK, hoặc DIRECT."""),
    ("human", "{question}"),
])

def smart_retrieve(question, retriever):
    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
    strategy = (router_prompt | llm).invoke({"question": question}).content.strip()

    if strategy == "MULTI_QUERY":
        return multi_query_retrieve(question, retriever)
    elif strategy == "HYDE":
        return hyde_retrieve(question, retriever)
    elif strategy == "STEP_BACK":
        return step_back_retrieval(question, retriever)
    else:
        return retriever.invoke(question)
💡 演習 3: ルーターを実装します。 15 の質問 (曖昧な質問 5 つ、短い質問 5 つ、具体的な質問 5 つ) でテストします。ルーターは何パーセント正しい戦略を選択しますか?
概要
| コンセプト | 覚えておいてください |
|---|---|
| マルチクエリ | 多くのバリエーションを生み出し、多くの側面を見つける |
| ハイデ | 偽の回答を作成 → 埋め込み → 本物の回答を見つける |
| ステップバック | 最初に一般的な質問をし、後で具体的な質問をしてください |
| ルーター | 質問の種類に応じて独自の戦略を選択してください |
| 結合 | 複数の技術の組み合わせ + マージ + 重複除去 |
一般的な演習
- ✅ 3 つの小さな演習 (1、2、3) を完了します。
- 完全なパイプライン: 結合パイプラインを実装します: ルーター → 戦略の選択 → 取得 → マージ。 20 の多様な質問でテストします。
- ベンチマーク: 同じデータセットに対する 4 つのアプローチ (直接、マルチクエリ、HyDE、ステップバック) の精度を比較します。比較表を描きます。
- レイテンシと品質: 各戦略の処理時間を測定します。 HyDE はどれくらい遅いですか?マルチクエリはどれくらい遅くなりますか?トレードオフに価値はあるのでしょうか?
次の記事: 再ランキングとコンテキスト圧縮 — 取得後、LLM に最適なチャンクとコンテキスト圧縮を選択する方法。