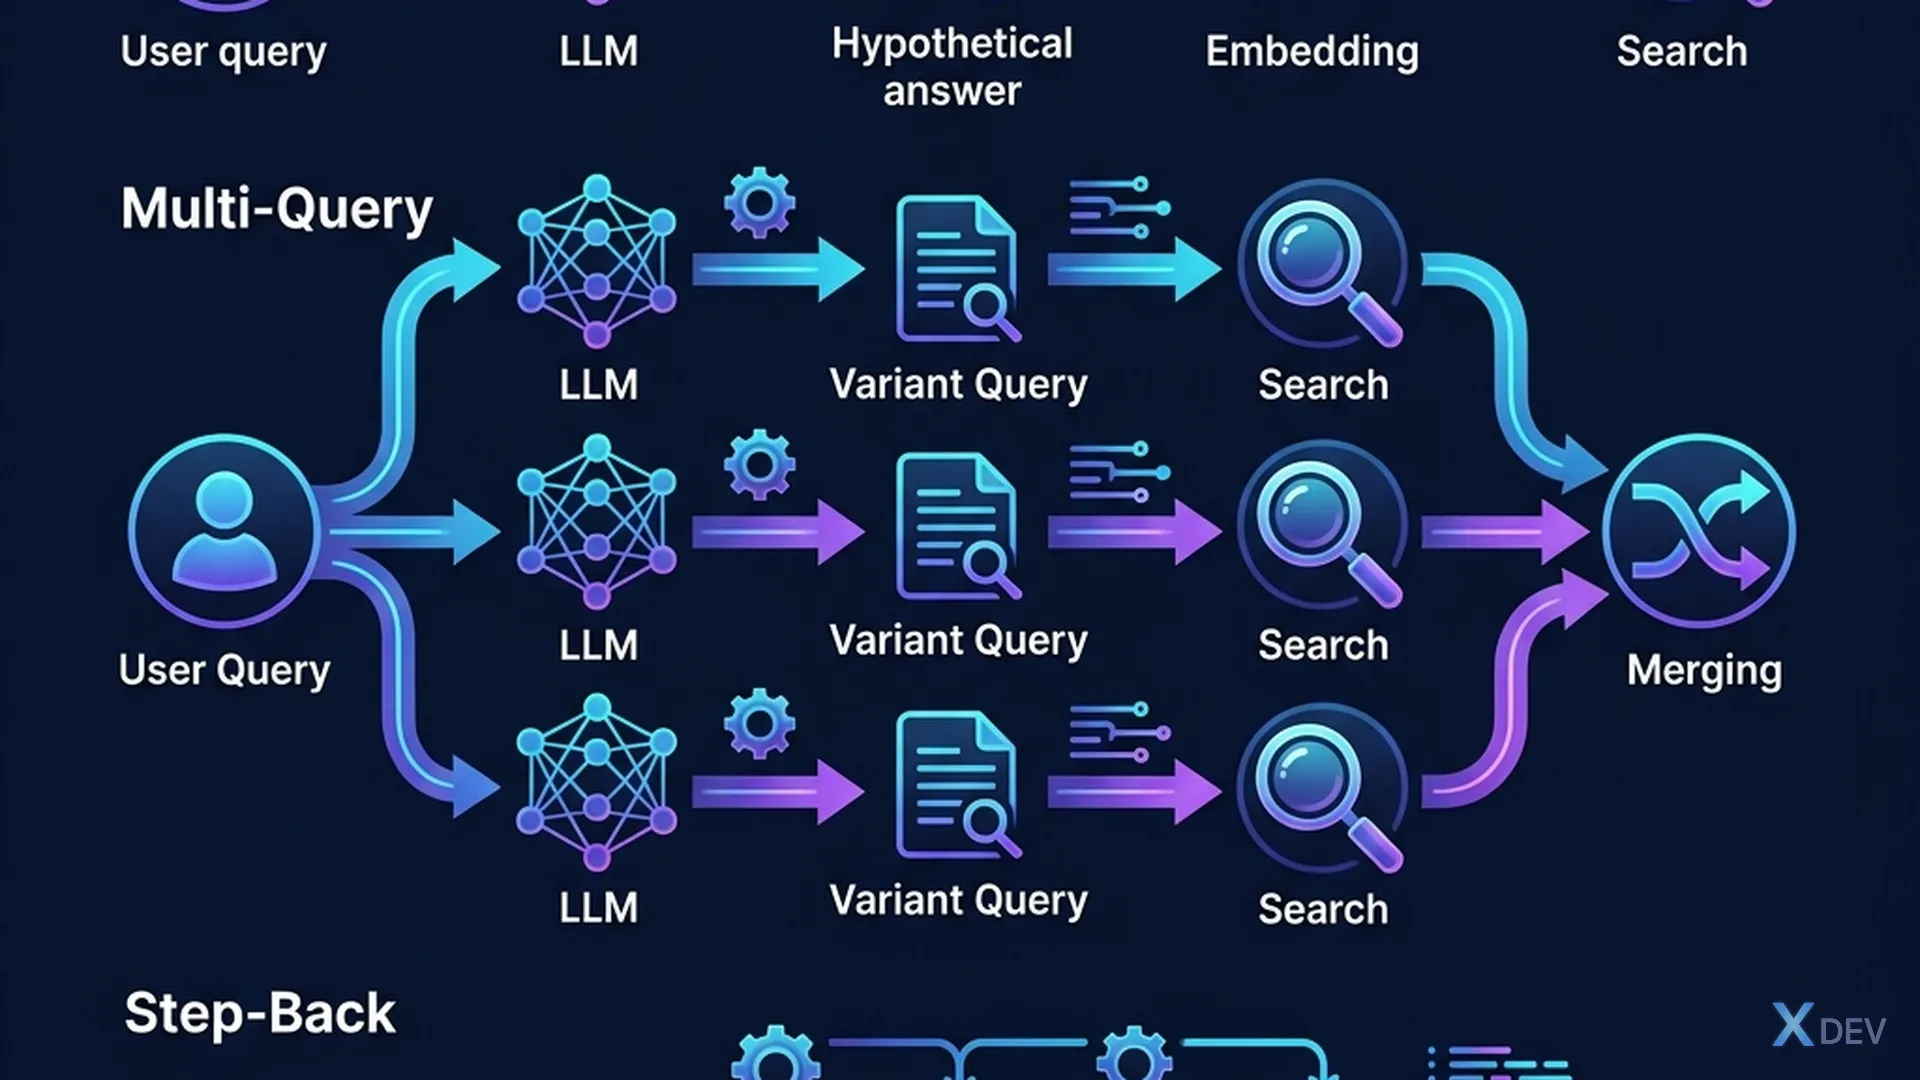
簡介
使用者問題對於搜尋來說通常不理想:太短、模糊或措辭超出文獻範圍。查詢轉換將原始查詢轉換為用於檢索的最佳形式。
範例: 使用者詢問「假期怎麼樣?」 → 太模糊了。轉變為:
- 《年假申請流程及審核步驟》
- “全職和兼職員工的假期天數”
- 《員工有緊急事請假政策》 → 3 個查詢尋找 3 個不同的面向!
本文涵蓋 3 種主要技術:
| 工程 | 想法 | 何時使用 |
|---|---|---|
| 多查詢 | 產生問題的多種變體 | 模糊的、多方面的問題 |
| 海德 | 創建“假答案”來尋找真正的答案 | 簡短的查詢,不同的文檔語言 |
| 後退一步 | 首先提出一個概述問題 | 問題太具體了 |
1. 多查詢-產生多個變體
1.1 問題
User query:    "lương thế nào?"
Vector search: tìm 1 lần → có thể miss "chế độ đãi ngộ", "phúc lợi"

Multi-Query:   "lương thế nào?" → LLM sinh 3 queries:
               Q1: "Mức lương cơ bản và bậc lương"
               Q2: "Chế độ đãi ngộ, thưởng, phúc lợi"
               Q3: "Quy trình review và tăng lương"
               → Search 3 lần → merge kết quả → cover nhiều khía cạnh!
1.2 實施
"""Multi-Query Retriever — tự sinh nhiều câu hỏi biến thể"""
from langchain.retrievers import MultiQueryRetriever
from langchain_openai import ChatOpenAI
from langchain_community.vectorstores import Chroma

llm = ChatOpenAI(model="gpt-4o-mini", temperature=0.3)
vectorstore = Chroma(...)  # Đã index sẵn

retriever = MultiQueryRetriever.from_llm(
    retriever=vectorstore.as_retriever(search_kwargs={"k": 3}),
    llm=llm,
)

# Nội bộ: LLM sinh 3 câu hỏi khác nhau, search mỗi câu, merge kết quả
results = retriever.invoke("lương thế nào?")
# Trả về documents từ CẢ 3 queries (đã deduplicate)
1.3 自訂多查詢提示
"""Custom prompt — kiểm soát cách sinh biến thể"""
from langchain.prompts import PromptTemplate

MULTI_QUERY_PROMPT = PromptTemplate(
    input_variables=["question"],
    template="""Bạn là AI assistant. Nhiệm vụ: sinh 3 câu hỏi biến thể
cho câu hỏi gốc, mỗi câu tập trung 1 khía cạnh khác nhau.

Câu hỏi gốc: {question}

Sinh 3 câu hỏi (mỗi câu 1 dòng, không đánh số):""",
)

retriever = MultiQueryRetriever.from_llm(
    retriever=vectorstore.as_retriever(),
    llm=llm,
    prompt=MULTI_QUERY_PROMPT,
)
💡練習 1: 實作多查詢擷取器。對 10 個測試句子進行單一查詢與多查詢的檢索召回率比較。多查詢是否涵蓋更多方面?
2. HyDE-假設文檔嵌入
2.1 想法
Vấn đề: User query (câu hỏi) và document (đáp án)
         có dạng KHÁC NHAU → embedding khác nhau

Query:   "Nghỉ phép bao nhiêu ngày?"     → embedding Q
Doc:     "Nhân viên full-time được 15     → embedding D
          ngày phép mỗi năm."

Q và D có thể cách xa nhau trong vector space!

HyDE giải quyết:
1. LLM tạo "đáp án giả" từ câu hỏi (hypothetical document)
2. Embed đáp án giả → gần hơn với đáp án thật
3. Dùng embedding đáp án giả để tìm đáp án thật

Query:      "Nghỉ phép bao nhiêu ngày?"
            ↓ LLM generate
HyDE doc:   "Theo chính sách công ty, nhân viên toàn thời gian
             được hưởng 15 ngày nghỉ phép có lương mỗi năm..."
            ↓ embed
HyDE embed: [0.45, 0.12, ...]  ← GẦN với doc thật hơn!
            ↓ search
Real doc:   "Nhân viên full-time: 15 ngày phép/năm" ← MATCH!
2.2 實施
"""HyDE — Hypothetical Document Embeddings"""
from langchain.chains import HypotheticalDocumentEmbedder
from langchain_openai import ChatOpenAI, OpenAIEmbeddings

llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
embeddings = OpenAIEmbeddings(model="text-embedding-3-small")

# HyDE embedder: wrap LLM + embedding
hyde_embeddings = HypotheticalDocumentEmbedder.from_llm(
    llm=llm,
    base_embeddings=embeddings,
    prompt_key="web_search",  # Hoặc custom prompt
)

# Dùng HyDE embeddings thay OpenAIEmbeddings trong retriever
vectorstore = Chroma(
    collection_name="docs",
    embedding_function=hyde_embeddings,  # ← HyDE thay vì direct
)

retriever = vectorstore.as_retriever(search_kwargs={"k": 5})
results = retriever.invoke("Nghỉ phép bao nhiêu ngày?")
2.3 自訂 HyDE 提示
"""Custom prompt cho HyDE — kiểm soát chất lượng hypothetical doc"""
from langchain.prompts import PromptTemplate

HYDE_PROMPT = PromptTemplate(
    input_variables=["question"],
    template="""Viết 1 đoạn văn ngắn (50-100 từ) trả lời câu hỏi sau,
giả sử bạn đang viết tài liệu chính thức cho công ty:

Câu hỏi: {question}

Đoạn trả lời:""",
)

hyde_embeddings = HypotheticalDocumentEmbedder(
    llm_chain=LLMChain(llm=llm, prompt=HYDE_PROMPT),
    base_embeddings=embeddings,
)
2.4 何時使用 HyDE?
| 場景 | HyDE有效嗎? | 原因 |
|---|---|---|
| 簡短查詢(2-3 個字) | ✅ | 展開為上下文豐富的段落 |
| 以題目形式查詢,以敘述形式記錄 | ✅ | 橋樑間隙問題↔答案 |
| 跨語言(問越南語,讀英語) | ✅ | LLM 產生相同語言的文檔 |
| 查詢很清晰、很長 | ❌ | HyDE 增加噪音 |
| 即時(延遲關鍵) | ❌ | 多 1 個 LLM 電話 = 更慢 |
💡練習 2: 比較檢索精確度:直接嵌入與 HyDE。使用 10 個簡短問題(2-3 個單字)。 HyDE 好多少?
3. 後退提示
3.1 想法
Câu hỏi quá CỤ THỂ: "Nhân viên bộ phận Kế toán nghỉ phép
                       ngày 31/12 có được không?"

Vector search: không tìm thấy (quá cụ thể, không ai viết exact match)

Step-Back: Lùi 1 bước → hỏi câu TỔNG QUÁT trước:
           "Quy định nghỉ phép vào ngày lễ, cuối năm?"
           → Tìm được! Rồi kết hợp context trả lời câu cụ thể.
3.2 實施
"""Step-Back Prompting cho RAG"""
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate

llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

# Step 1: Generate step-back question
step_back_prompt = ChatPromptTemplate.from_messages([
    ("system", """Bạn là expert tạo câu hỏi tổng quát hơn.
Cho 1 câu hỏi cụ thể, tạo câu hỏi TỔNG QUÁT hơn 1 bậc
để tìm kiếm context rộng hơn."""),
    ("human", "Câu hỏi: {question}\n\nCâu hỏi tổng quát hơn:"),
])

step_back_chain = step_back_prompt | llm

# Step 2: Search cả câu gốc + step-back
def step_back_retrieval(question: str, retriever):
    # Tạo step-back question
    step_back_q = step_back_chain.invoke({"question": question}).content

    # Search cả 2
    original_docs = retriever.invoke(question)
    step_back_docs = retriever.invoke(step_back_q)

    # Merge + deduplicate
    all_docs = original_docs + step_back_docs
    seen = set()
    unique_docs = []
    for doc in all_docs:
        key = doc.page_content[:100]
        if key not in seen:
            seen.add(key)
            unique_docs.append(doc)

    return unique_docs

results = step_back_retrieval(
    "Nhân viên Kế toán nghỉ phép ngày 31/12 có được không?",
    retriever
)
4. 結合多種技術
4.1 實際管道
User query
    │
    ├──→ Multi-Query (sinh 3 biến thể)
    │        │
    │        ├──→ Query 1 → Vector search → docs_1
    │        ├──→ Query 2 → Vector search → docs_2
    │        └──→ Query 3 → Vector search → docs_3
    │
    ├──→ Step-Back (câu tổng quát)
    │        └──→ BM25 search → docs_4
    │
    └──→ HyDE (hypothetical doc)
             └──→ Vector search → docs_5

    Merge all → Deduplicate → Re-rank (bài tiếp theo) → Top K
4.2 路由-根據查詢類型選擇策略
"""Router: tự chọn strategy phù hợp với câu hỏi"""
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate

router_prompt = ChatPromptTemplate.from_messages([
    ("system", """Phân loại câu hỏi thành 1 trong 3 loại:
- MULTI_QUERY: câu hỏi mơ hồ, nhiều khía cạnh
- HYDE: câu hỏi ngắn, khó match trực tiếp
- STEP_BACK: câu hỏi quá cụ thể, cần context rộng
- DIRECT: câu hỏi rõ ràng, không cần transform

Chỉ trả lời 1 từ: MULTI_QUERY, HYDE, STEP_BACK, hoặc DIRECT."""),
    ("human", "{question}"),
])

def smart_retrieve(question, retriever):
    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
    strategy = (router_prompt | llm).invoke({"question": question}).content.strip()

    if strategy == "MULTI_QUERY":
        return multi_query_retrieve(question, retriever)
    elif strategy == "HYDE":
        return hyde_retrieve(question, retriever)
    elif strategy == "STEP_BACK":
        return step_back_retrieval(question, retriever)
    else:
        return retriever.invoke(question)
💡練習 3: 實現路由器。測驗 15 個問題(5 個模糊問題、5 個簡短問題、5 個具體問題)。路由器選擇正確策略的百分比是多少?
總結
| 概念 | 記住 |
|---|---|
| 多查詢 | 產生許多變化,發現許多方面 |
| 海德 | 建立虛假答案 → 嵌入 → 找出真實答案 |
| 後退一步 | 先問一般性問題,再問具體問題 |
| 路由器 | 根據題型選擇適合自己的策略 |
| 合併 | 結合多種技巧+合併+重複資料刪除 |
一般練習
- ✅ 完成3個小練習(1,2,3)
- 完整管道: 實作組合管道:路由器→選擇策略→擷取→合併。測試 20 個不同的問題。
- 基準: 在同一資料集上比較 4 種方法(直接、多查詢、HyDE、後退)的準確性。畫個對比圖。
- 延遲與品質: 測量每個策略的處理時間。 HyDE 慢了多少?多查詢慢多少?值得權衡嗎?
下一篇文章: 重新排序和上下文壓縮 - 檢索後,如何為 LLM 選擇最佳區塊和上下文壓縮。