1. 医療における災害復旧の概要
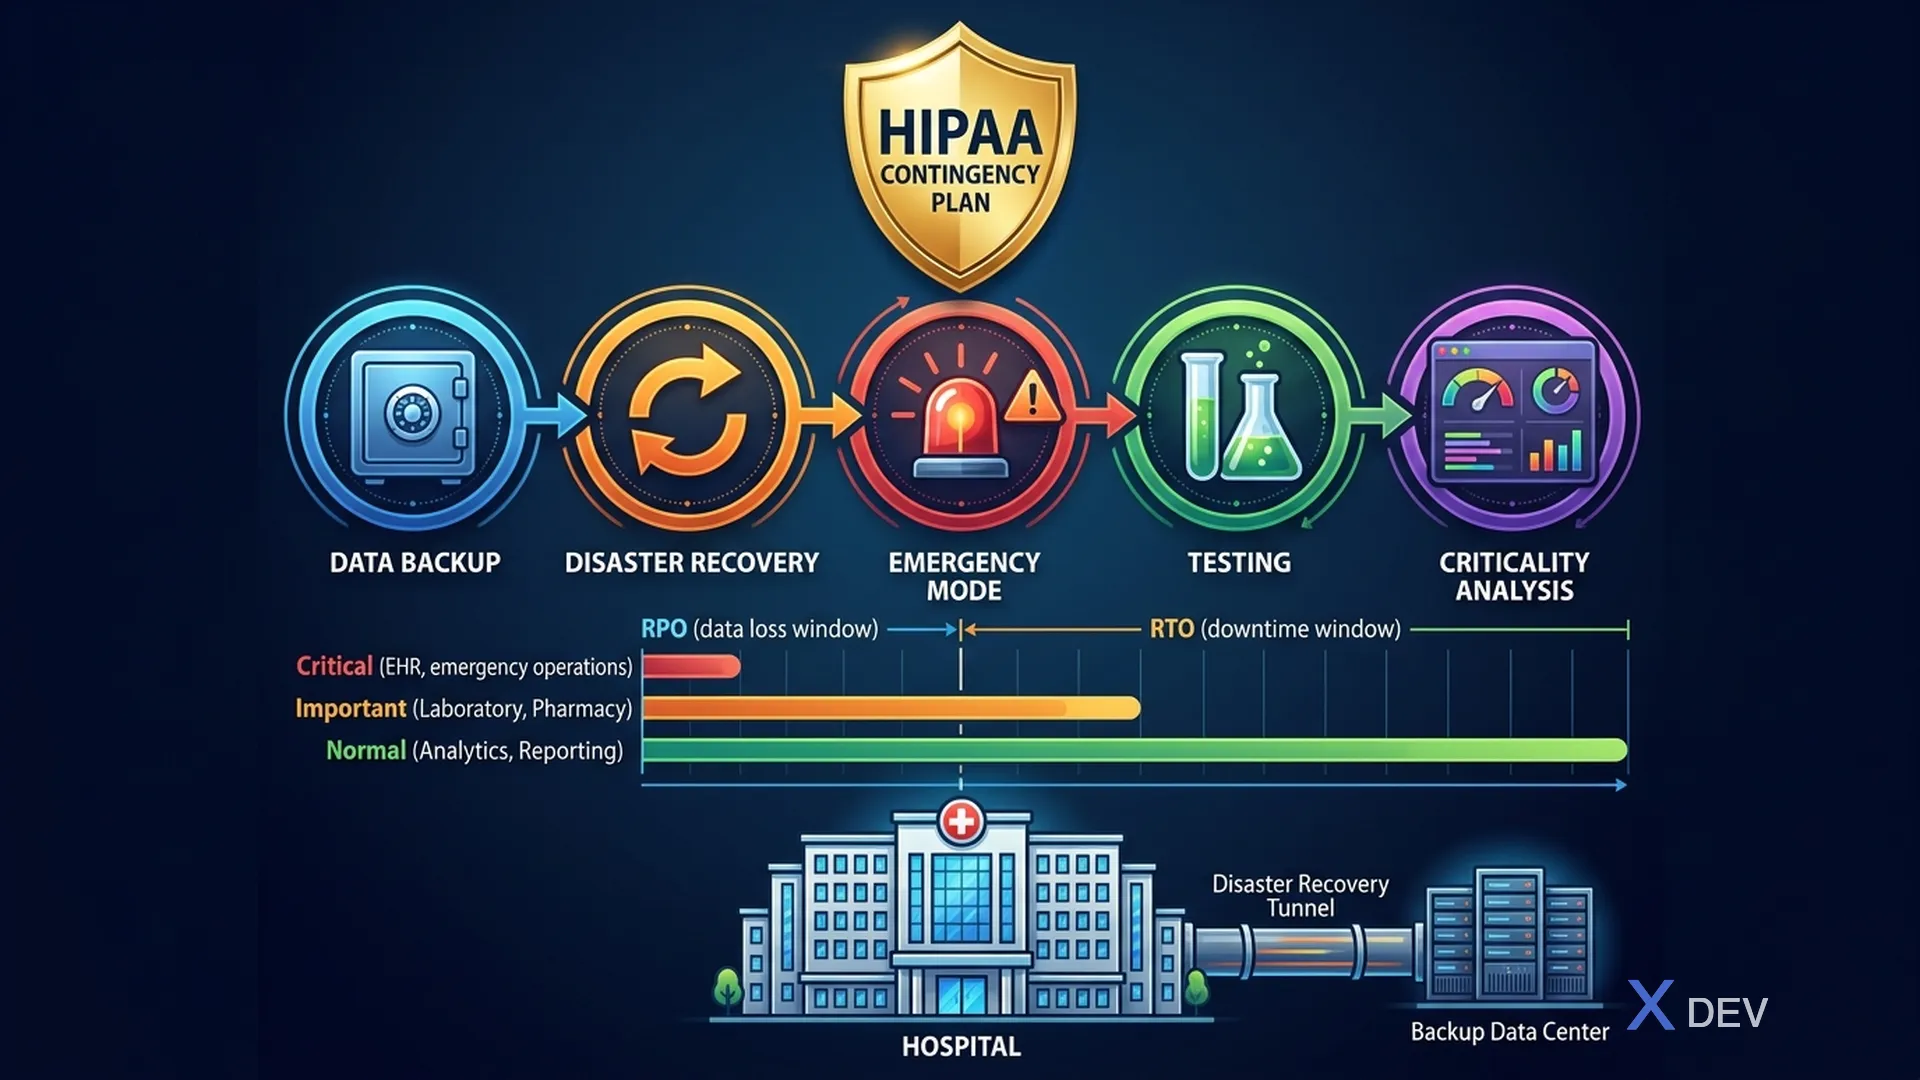
HIPAA セキュリティ規則 §164.308(a)(7) では、ePHI を扱うすべての組織に 緊急時対応計画、つまり緊急事態 (自然災害、ランサムウェア攻撃、ハードウェア障害、人為的エラー) に対する緊急時対応計画を立てることが求められています。医療業界では、ダウンタイムは患者の命に直接影響する可能性があります。
###1.1. HIPAA 緊急時対応計画の要件
HIPAA 緊急時対応計画 — §164.308(a)(7):
- データ バックアップ プラン [必須]
- ePHI の正確なコピーを作成および維持する
- 定期的なバックアップスケジュール
- バックアップの検証
- 災害復旧計画 [必須]
- 失われたデータを復元する手順
- バックアップからの復元
- テスト回復手順
- 緊急モード運用計画 [必須]
- 緊急時に重要な業務を継続する
- 緊急時に ePHI を保護する
- 患者安全システムを優先する
- テストおよび改訂手順 [対処可能]
- 緊急時対応計画の定期的なテスト
- テスト結果に基づいて計画を更新する
- アプリケーションとデータの重要性分析 [アドレス可能]
- 重要なアプリケーションを特定する
- 回復命令を優先する
###1.2.ヘルスケアの RTO/RPO 要件
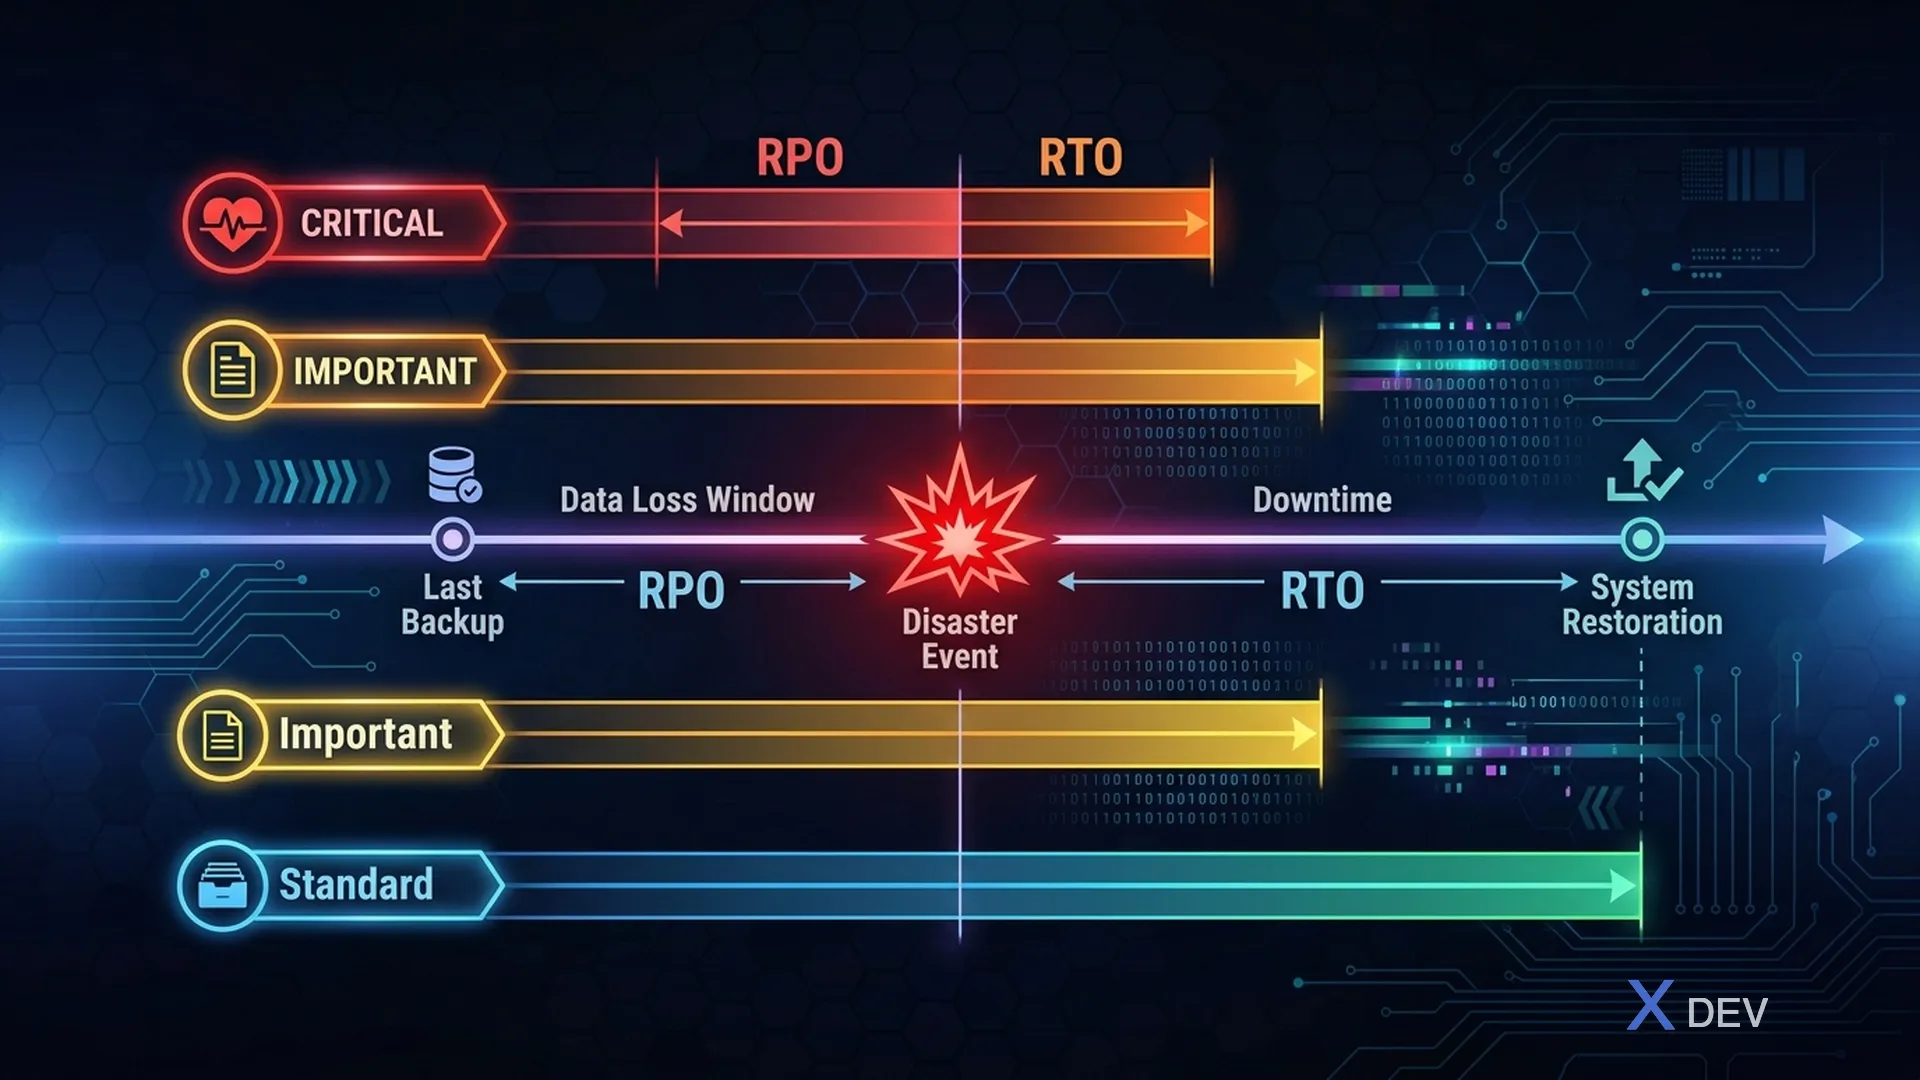
| システム | RPO | RTO | 重要度 |
|---|---|---|---|
| EHR (医療記録) | 0~1分 | <15min | Critical |
| Lab Results | <5min | <30min | Critical |
| Pharmacy | <5min | <30min | Critical |
| Patient Portal | <1hr | <4hr | Important |
| Billing | <4hr | <8hr | Standard |
| Analytics | <24hr | <24hr | Low |
| Audit Logs | 0 | <1hr | Critical (HIPAA) |
Timeline: ◄── RPO (Data loss window) ──┤ Disaster occurs ├── RTO (Downtime window) ──►
Target cho Critical Healthcare: RPO ≈ 0 (synchronous replication), RTO < 15 minutes (automated failover)
2. PostgreSQL Backup Strategies
###2.1.バックアップ方法の比較
| Method | Type | RPO | Speed | Size | Complexity | Use Case |
|---|---|---|---|---|---|---|
pg_dump | Logical | Hours | Slow | Small (compressed) | Low | Small DB, schema migration |
pg_basebackup | Physical | Minutes | Medium | Full DB size | Medium | Standbys, PITR |
| pgBackRest | Physical | Seconds | Fast | Incremental | Medium | Production healthcare |
| Barman | Physical | Seconds | Fast | Incremental | High | Large enterprise |
| WAL archiving | Continuous | Seconds | Minimal | WAL files | Low | PITR supplement |
| Streaming replication | Continuous | ~0 | Real-time | Full replica | Medium | HA / Failover |
2.2. pg_dump — Logical Backup
#!/bin/bash
# pg-logical-backup.sh
# Logical backup cho healthcare database

set -euo pipefail

DB_NAME="healthcare"
DB_USER="backup_user"
BACKUP_DIR="/var/backups/postgresql"
DATE=$(date +%Y%m%d_%H%M%S)
BACKUP_FILE="${BACKUP_DIR}/${DB_NAME}_${DATE}.dump"
ENCRYPTION_KEY_FILE="/etc/healthcare/backup-encryption-key"

# Backup
echo "[$(date)] Starting logical backup: ${DB_NAME}"

pg_dump \
    --host=localhost \
    --port=5432 \
    --username="${DB_USER}" \
    --format=custom \
    --compress=9 \
    --verbose \
    --file="${BACKUP_FILE}" \
    "${DB_NAME}"

# Encrypt backup (HIPAA requirement)
echo "[$(date)] Encrypting backup..."
openssl enc -aes-256-cbc -salt \
    -in "${BACKUP_FILE}" \
    -out "${BACKUP_FILE}.enc" \
    -pass file:"${ENCRYPTION_KEY_FILE}" \
    -pbkdf2 -iter 100000

# Remove unencrypted backup
rm -f "${BACKUP_FILE}"

# Verify backup integrity
echo "[$(date)] Verifying backup..."
VERIFY_FILE=$(mktemp)
openssl enc -d -aes-256-cbc \
    -in "${BACKUP_FILE}.enc" \
    -out "${VERIFY_FILE}" \
    -pass file:"${ENCRYPTION_KEY_FILE}" \
    -pbkdf2 -iter 100000

pg_restore --list "${VERIFY_FILE}" > /dev/null 2>&1
VERIFY_STATUS=$?
rm -f "${VERIFY_FILE}"

if [ ${VERIFY_STATUS} -eq 0 ];それから
    echo "[$(date)] バックアップ検証: PASSED"
    # チェックサムを計算する
    SHA256=$(sha256sum "${BACKUP_FILE}.enc" | awk '{print $1}')
    エコー "[$(日付)] SHA256: ${SHA256}"

    # 監査にログを記録します
    echo "{\"event\":\"backup_completed\",\"type\":\"logical\",\"database\":\"${DB_NAME}\",\"file\":\"${BACKUP_FILE}.enc\",\"sha256\":\"${SHA256}\",\"timestamp\":\"$(date -u +"%Y-%m-%dT%H:%M:%SZ")\"}" \
        |ロガー -t ヘルスケアバックアップ
それ以外は。それ以外の場合
    echo "[$(date)] バックアップの検証: 失敗しました"
    出口1
フィ

# 保持: 毎日のバックアップを 30 日間保持します
echo "[$(date)] 古いバックアップを削除しています (>30 日)..."
find "${BACKUP_DIR}" -name "*.dump.enc" -mtime +30 -delete

echo "[$(date)] バックアップが完了しました: ${BACKUP_FILE}.enc"
2.3. WAL Archiving Configuration
# postgresql.conf - PITR の WAL アーカイブ

# === WAL 設定 ===
wal_level = レプリカ
max_wal_senders = 10
wal_keep_size = 1GB

# === アーカイブモード ===
アーカイブモード = オン
archive_command = 'pgbackrest --stanza=ヘルスケア アーカイブ-プッシュ %p'
アーカイブタイムアウト = 60

# === チェックポイントの調整 ===
チェックポイントタイムアウト = 15分
チェックポイント_完了_ターゲット = 0.9
max_wal_size = 4GB
min_wal_size = 1GB
3. pgBackRest — Production Backup Solution
###3.1.ヘルスケアに pgBackRest を使用する理由
pgBackRest は、本番環境の PostgreSQL に推奨されるバックアップ ソリューションです。その理由は次のとおりです。
- 増分バックアップ: 前回のバックアップ以降の変更のみをバックアップします → 高速でストレージを節約します
- 並列バックアップ/復元: 複数の CPU コアを使用 → 時間を短縮します
- Built-in encryption: AES-256-CBC encryption → HIPAA compliant
- バックアップ検証: バックアップの整合性を自動的に検証します。
- PITR: 任意の時点からのポイントインタイム リカバリ
- リモート バックアップ: リモート サーバーまたはオブジェクト ストレージ (S3、GCS) へのバックアップ
3.2. pgBackRest Configuration
# /etc/pgbackrest/pgbackrest.conf

[グローバル]
# === リポジトリ設定 ===
リポ1タイプ=s3
repo1-path=/ヘルスケアバックアップ
repo1-s3-bucket=病院-db-バックアップ
repo1-s3-endpoint=s3.ap-southeast-1.amazonaws.com
repo1-s3-region=ap-southeast-1
repo1-s3-key=AKIAIOSFODNN7EXAMPLE
repo1-s3-key-secret=wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY

# === 暗号化 (HIPAA が必要) ===
repo1-cipher-type=aes-256-cbc
repo1-cipher-pass=STRONG_ENCRYPTION_PASSPHRASE_HERE

# === 保持ポリシー ===
repo1-retention-full=4
repo1-retention-diff=14
repo1-retention-archive=2
repo1-retention-archive-type=full

# === パフォーマンス ===
プロセス最大=4
圧縮タイプ=zst
圧縮レベル=6
デルタ=y

# === ロギング ===
ログレベルコンソール=情報
ログレベルファイル=詳細
ログパス=/var/log/pgbackrest

【ヘルスケア】
# === スタンザ構成 ===
pg1-path=/var/lib/postgresql/16/main
pg1-ポート=5432
pg1-user=postgres

# === 2 番目のリポジトリ (DR サイト) ===
# リポ2タイプ=s3
# repo2-path=/healthcare-backups-dr
# repo2-s3-bucket=病院-db-backups-dr
# repo2-s3-endpoint=s3.ap-northeast-1.amazonaws.com
# repo2-s3-region=ap-northeast-1
# repo2-cipher-type=aes-256-cbc
# repo2-cipher-pass=DR_ENCRYPTION_PASSPHRASE
3.3. Backup Schedule
#!/bin/bash
# pgbackrest-schedule.sh
# 医療向けの自動バックアップ スケジュール

set -euo パイプ失敗

STANZA="ヘルスケア"
LOG_FILE="/var/log/pgbackrest/schedule.log"

log() {
    echo "[$(date -u +"%Y-%m-%dT%H:%M:%SZ")] $1" | tee -a "$LOG_FILE"
}

ケース「${1:-}」
    いっぱい)
        # 完全バックアップ — 毎週実行 (日曜日の午前 2:00)
        ログ「フルバックアップを開始しています...」
        pgbackrest --stanza="${STANZA}" --type=フルバックアップ
        ログ「フルバックアップが完了しました」
        ;;

    差分)
        # 差分バックアップ — 毎日実行 (午前 2 時)
        ログ「差分バックアップを開始しています...」
        pgbackrest --stanza="${STANZA}" --type=diff バックアップ
        ログ「差分バックアップが完了しました」
        ;;

    増加)
        # 増分バックアップ — 1 時間ごとに実行されます
        ログ「増分バックアップを開始しています...」
        pgbackrest --stanza="${STANZA}" --type=incr バックアップ
        ログ「増分バックアップが完了しました」
        ;;

    確認してください)
        # バックアップの整合性を確認する
        ログ「バックアップ検証を開始しています...」
        pgbackrest --stanza="${STANZA}" 検証
        ログ「検証が完了しました」
        ;;

    情報)
        pgbackrest --stanza="${STANZA}" 情報
        ;;

    *)
        echo "使用法: $0 {full|diff|incr|verify|info}"
        出口1
        ;;
イーサック

# 監査証跡のログバックアップ情報
BACKUP_INFO=$(pgbackrest --stanza="${STANZA}" --output=json 情報 2>/dev/null)
echo "{\"event\":\"backup_schedule\",\"type\":\"${1:-unknown}\",\"stanza\":\"${STANZA}\",\"timestamp\":\"$(date -u +"%Y-%m-%dT%H:%M:%SZ")\"}" \
    |ロガー -t ヘルスケアバックアップ
Crontab Configuration:
# /etc/cron.d/pgbackrest-healthcare

# 1 時間ごとの増分バックアップ
0 * * * * postgres /opt/scripts/pgbackrest-schedule.sh incr

# 差分バックアップ 毎日午前 2:00
0 2 * * 1-6 postgres /opt/scripts/pgbackrest-schedule.sh diff

# 完全バックアップ 日曜午前 2:00
0 2 * * 0 postgres /opt/scripts/pgbackrest-schedule.sh フル

# 毎日午前 6:00 にバックアップを確認します
0 6 * * * postgres /opt/scripts/pgbackrest-schedule.sh verify
3.4. Point-in-Time Recovery (PITR)
#!/bin/bash
#pitr-restore.sh
# 医療データベースのポイントインタイムリカバリ

set -euo パイプ失敗

STANZA="ヘルスケア"
TARGET_TIME="${1:-}"
PG_DATA="/var/lib/postgresql/16/main"

if [ -z "$TARGET_TIME" ];それから
    echo "使用量: $0 <target_time>」
    echo "例: $0 '2024-03-15 14:30:00+07'"
    エコー「」
    echo "利用可能なバックアップ:"
    pgbackrest --stanza="${STANZA}" 情報
    出口1
フィ

echo "=== ポイントインタイムリカバリ ===
echo "目標時間: ${TARGET_TIME}"
エコー「スタンザ: ${STANZA}」
エコー「」
echo "警告: これは現在のデータベースを置き換えます!"
read -p "そうですか? (はい/いいえ): 「確認します

if [ "$CONFIRM" != "はい" ];それから
    エコー「中止されました。」
    0番出口
フィ

#1. PostgreSQLを停止する
echo "[$(date)] PostgreSQL を停止しています..."
systemctl postgresql を停止します

#2. PITR復元を実行する
echo "[$(date)] PITR リストアを開始しています: ${TARGET_TIME}"
pgbackrest --stanza="${STANZA}" \
    --type=時間 \
    --target="${TARGET_TIME}" \
    --target-action=プロモート \
    --デルタ\
    復元します。復元する

#3. PostgreSQLを開始する
echo "[$(date)] PostgreSQL を開始しています..."
systemctl で postgresql を起動します

# 4. データベースの検証
echo "[$(date)] データベースを検証しています..."
睡眠5
pg_isready -h localhost -p 5432
もし[$? -eq 0 ];それから
    echo "[$(date)] PostgreSQL の準備ができました"

    # データを検証する
    PATIENT_COUNT=$(psql -d healthcare -tAc "SELECT COUNT(*) FROM healthcare.patients" 2>/dev/null)
    echo "[$(date)]患者記録: ${PATIENT_COUNT}"

    # ログリカバリイベント
    echo "{\"event\":\"pitr_restore\",\"target_time\":\"${TARGET_TIME}\",\"patient_count\":${PATIENT_COUNT},\"timestamp\":\"$(date -u +"%Y-%m-%dT%H:%M:%SZ")\"}" \
        |ロガー -t ヘルスケアバックアップ
それ以外は。それ以外の場合
    echo "[$(date)] エラー: 復元後に PostgreSQL を起動できませんでした"
    出口1
フィ

echo "[$(date)] PITR 復元が正常に完了しました"
4. Streaming Replication & Patroni
4.1. High Availability Architecture
┌─────────────────────────────┐
│ Patroni による PostgreSQL HA │
│ │
│ ┌─────────────────────────────┐ │
│ │ HAProxy (VIP) │ │
│ │ 読み取り/書き込み ──► ポート 5432 │ │
│ │ 読み取り専用 ──► ポート 5433 │ │
│ ━━━━━━━━━━━━━━━━━━━━━━━┘ │
│ │ │ │
│ ┌───▼─────┐ ┌───────▼─────┐ │
│ │ PostgreSQL │ │ PostgreSQL │ │
│ │ プライマリ │ │ レプリカ │ │
│ │ (読み取り/書き込み) │ │ (読み取り専用) │ │
│ │ │ │ │ │
│ │ パトローニ エージェント │ │ パトローニ エージェント │ │
│ │ pg1:5432 │ │ pg2:5432 │ │
│ ━───┬─────┘ ━─────┬───────┘ │
│ │ │ │
│ ━━━━━┬───────┘ │
│ │ │
│ ┌───▼─────┐ │
│ │ etcd クラスタ │ │
│ │ (DCS - コンセンサス)│ │
│ │ etcd1、etcd2、│ │
│ │ etcd3 │ │
│ ━━━━━━━━━┘ │
│ │
│ フェイルオーバー フロー: │
│ 1. プライマリ障害 │
│ 2. Patroni はヘルスチェックを通じて検出します │
│ 3. etcd コンセンサス: 新しい予備選挙を選出する │
│ 4. Patroni はレプリカをプライマリに昇格します │
│ 5. HAProxy はトラフィックを新しいプライマリにルーティングします │
│ 6.RTO < 30 seconds (automated)                             │
└─────────────────────────────────────────────────────────────┘
4.2. Patroni Configuration
# patroni.yml - Primary node

scope: healthcare-cluster
namespace: /healthcare/
name: pg1

restapi:
  listen: 0.0.0.0:8008
  connect_address: pg1:8008
  authentication:
    username: admin
    password: ${PATRONI_REST_PASSWORD}

etcd3:
  hosts:
    - etcd1:2379
    - etcd2:2379
    - etcd3:2379
  username: patroni
  password: ${ETCD_PASSWORD}

bootstrap:
  dcs:
    ttl: 30
    loop_wait: 10
    retry_timeout: 10
    maximum_lag_on_failover: 1048576  # 1MB WAL lag max
    synchronous_mode: true  # Synchronous replication (RPO = 0)
    synchronous_mode_strict: true
    postgresql:
      use_pg_rewind: true
      use_slots: true
      parameters:
        wal_level: replica
        max_wal_senders: 10
        max_replication_slots: 10
        wal_keep_size: 2GB
        hot_standby: "on"
        synchronous_commit: "on"  # RPO = 0 cho healthcare
        synchronous_standby_names: "*"
        # Audit logging
        log_statement: all
        log_connections: "on"
        log_disconnections: "on"
        log_line_prefix: '%t [%p]: [%l-1] user=%u,db=%d,app=%a,client=%h '

  initdb:
    - encoding: UTF8
    - data-checksums
    - locale: en_US.UTF-8

  pg_hba:
    - local all postgres peer
    - host replication replicator 10.0.0.0/8 scram-sha-256
    - host all all 10.0.0.0/8 scram-sha-256
    - host all all 0.0.0.0/0 reject

postgresql:
  listen: 0.0.0.0:5432
  connect_address: pg1:5432
  data_dir: /var/lib/postgresql/16/main
  bin_dir: /usr/lib/postgresql/16/bin

  authentication:
    superuser:
      username: postgres
      password: ${PG_SUPERUSER_PASSWORD}
    replication:
      username: replicator
      password: ${PG_REPLICATION_PASSWORD}

  parameters:
    # Performance
    shared_buffers: 4GB
    effective_cache_size: 12GB
    work_mem: 64MB
    maintenance_work_mem: 512MB

    # WAL
    wal_level: replica
    max_wal_senders: 10
    max_replication_slots: 10
    synchronous_commit: "on"

    # Archive
    archive_mode: "on"
    archive_command: "pgbackrest --stanza=healthcare archive-push %p"

    # SSL (HIPAA)
    ssl: "on"
    ssl_cert_file: /etc/ssl/certs/pg-server.crt
    ssl_key_file: /etc/ssl/private/pg-server.key
    ssl_ca_file: /etc/ssl/certs/ca.crt

  pgpass: /tmp/pgpass

tags:
  nofailover: false
  noloadbalance: false
  clonefrom: false
  nosync: false
4.3. HAProxy Configuration
# haproxy.cfg - Load balancing cho PostgreSQL

global
    maxconn 1000
    log stdout local0

defaults
    mode tcp
    log global
    retries 3
    timeout connect 10s
    timeout client 30m
    timeout server 30m
    timeout check 5s

# Primary (Read/Write)
listen healthcare-primary
    bind *:5432
    option httpchk OPTIONS /primary
    http-check expect status 200
    default-server inter 3s fall 3 rise 2 on-marked-down shutdown-sessions
    server pg1 pg1:5432 maxconn 500 check port 8008
    server pg2 pg2:5432 maxconn 500 check port 8008

# Replicas (Read-Only)
listen healthcare-replica
    bind *:5433
    option httpchk OPTIONS /replica
    http-check expect status 200
    balance roundrobin
    default-server inter 3s fall 3 rise 2 on-marked-down shutdown-sessions
    server pg1 pg1:5432 maxconn 300 check port 8008
    server pg2 pg2:5432 maxconn 300 check port 8008

# Patroni REST API
listen patroni-api
    bind *:8008
    mode http
    option httpchk GET /health
    default-server inter 5s fall 3 rise 2
    server pg1 pg1:8008 check
    server pg2 pg2:8008 check

# Stats
listen stats
    bind *:7000
    mode http
    stats enable
    stats uri /
    stats refresh 10s
4.4. Docker Compose cho HA Stack
# docker-compose-ha.yml
version: '3.8'

services:
  # === etcd Cluster ===
  etcd1:
    image: quay.io/coreos/etcd:v3.5.12
    container_name: etcd1
    environment:
      ETCD_NAME: etcd1
      ETCD_INITIAL_ADVERTISE_PEER_URLS: http://etcd1:2380
      ETCD_LISTEN_PEER_URLS: http://0.0.0.0:2380
      ETCD_LISTEN_CLIENT_URLS: http://0.0.0.0:2379
      ETCD_ADVERTISE_CLIENT_URLS: http://etcd1:2379
      ETCD_INITIAL_CLUSTER: etcd1=http://etcd1:2380,etcd2=http://etcd2:2380,etcd3=http://etcd3:2380
      ETCD_INITIAL_CLUSTER_STATE: new
    volumes:
      - etcd1_data:/etcd-data

  etcd2:
    image: quay.io/coreos/etcd:v3.5.12
    container_name: etcd2
    environment:
      ETCD_NAME: etcd2
      ETCD_INITIAL_ADVERTISE_PEER_URLS: http://etcd2:2380
      ETCD_LISTEN_PEER_URLS: http://0.0.0.0:2380
      ETCD_LISTEN_CLIENT_URLS: http://0.0.0.0:2379
      ETCD_ADVERTISE_CLIENT_URLS: http://etcd2:2379
      ETCD_INITIAL_CLUSTER: etcd1=http://etcd1:2380,etcd2=http://etcd2:2380,etcd3=http://etcd3:2380
      ETCD_INITIAL_CLUSTER_STATE: new
    volumes:
      - etcd2_data:/etcd-data

  etcd3:
    image: quay.io/coreos/etcd:v3.5.12
    container_name: etcd3
    environment:
      ETCD_NAME: etcd3
      ETCD_INITIAL_ADVERTISE_PEER_URLS: http://etcd3:2380
      ETCD_LISTEN_PEER_URLS: http://0.0.0.0:2380
      ETCD_LISTEN_CLIENT_URLS: http://0.0.0.0:2379
      ETCD_ADVERTISE_CLIENT_URLS: http://etcd3:2379
      ETCD_INITIAL_CLUSTER: etcd1=http://etcd1:2380,etcd2=http://etcd2:2380,etcd3=http://etcd3:2380
      ETCD_INITIAL_CLUSTER_STATE: new
    volumes:
      - etcd3_data:/etcd-data

  # === PostgreSQL + Patroni ===
  pg1:
    image: postgres:16-bookworm
    container_name: pg1
    environment:
      PATRONI_SCOPE: healthcare-cluster
      PATRONI_NAME: pg1
      PATRONI_POSTGRESQL_DATA_DIR: /var/lib/postgresql/data
      PATRONI_POSTGRESQL_CONNECT_ADDRESS: pg1:5432
      PATRONI_RESTAPI_CONNECT_ADDRESS: pg1:8008
      PATRONI_ETCD3_HOSTS: "'etcd1:2379','etcd2:2379','etcd3:2379'"
      PG_SUPERUSER_PASSWORD: ${PG_SUPERUSER_PASSWORD}
      PG_REPLICATION_PASSWORD: ${PG_REPLICATION_PASSWORD}
    volumes:
      - pg1_data:/var/lib/postgresql/data
      - ./config/patroni.yml:/etc/patroni.yml
    ports:
      - "5432"
    depends_on:
      - etcd1
      - etcd2
      - etcd3

  pg2:
    image: postgres:16-bookworm
    container_name: pg2
    environment:
      PATRONI_SCOPE: healthcare-cluster
      PATRONI_NAME: pg2
      PATRONI_POSTGRESQL_DATA_DIR: /var/lib/postgresql/data
      PATRONI_POSTGRESQL_CONNECT_ADDRESS: pg2:5432
      PATRONI_RESTAPI_CONNECT_ADDRESS: pg2:8008
      PATRONI_ETCD3_HOSTS: "'etcd1:2379','etcd2:2379','etcd3:2379'"
      PG_SUPERUSER_PASSWORD: ${PG_SUPERUSER_PASSWORD}
      PG_REPLICATION_PASSWORD: ${PG_REPLICATION_PASSWORD}
    volumes:
      - pg2_data:/var/lib/postgresql/data
      - ./config/patroni.yml:/etc/patroni.yml
    ports:
      - "5432"
    depends_on:
      - etcd1
      - etcd2
      - etcd3

  # === HAProxy ===
  haproxy:
    image: haproxy:2.9
    container_name: haproxy
    volumes:
      - ./config/haproxy.cfg:/usr/local/etc/haproxy/haproxy.cfg:ro
    ports:
      - "5432:5432"   # Primary (R/W)
      - "5433:5433"   # Replica (R/O)
      - "7000:7000"   # Stats
    depends_on:
      - pg1
      - pg2

volumes:
  etcd1_data:
  etcd2_data:
  etcd3_data:
  pg1_data:
  pg2_data:
5. Cross-Region Replication cho DR
5.1. Cross-Region Architecture
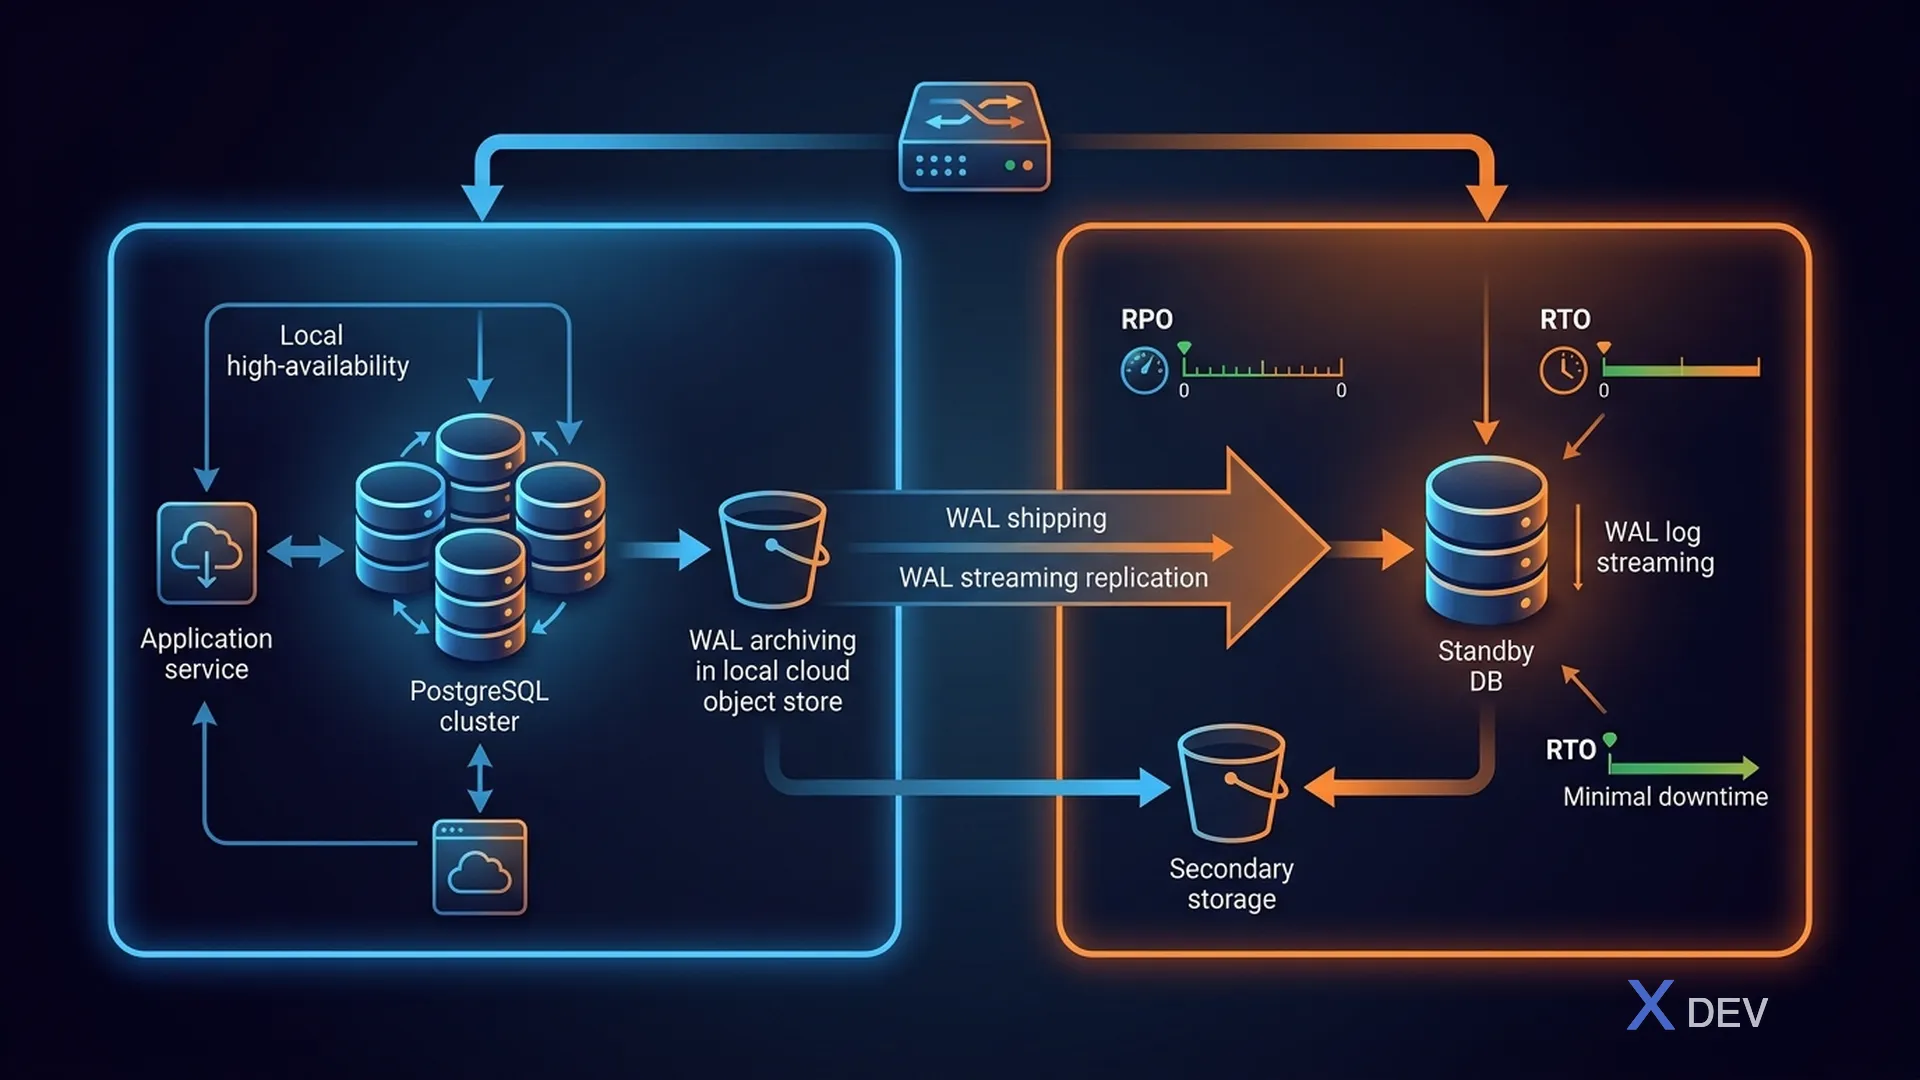
PRIMARY REGION (ap-southeast-1: Singapore):
- pg-primary (R/W) → pg-replica (R/O) — sync replication
- DR リージョンへの WAL ストリーミング (非同期)
DR REGION (ap-northeast-1: Tokyo):
- pg-dr (async replica, read-only) — Lag: < 1 minute
- pgBackRest S3 backup (encrypted)
- Standby microservices (cold/warm)
Failover: DNS switch + Patroni promote DR — RPO < 1 minute, RTO < 15 minutes (automated)
5.2. DR Replication Setup
#!/bin/bash
# setup-dr-replica.sh
# Setup cross-region DR replica

set -euo pipefail

PRIMARY_HOST="pg-primary.ap-southeast-1.hospital.internal"
DR_HOST="pg-dr.ap-northeast-1.hospital.internal"
REPLICATION_USER="replicator"
PG_DATA="/var/lib/postgresql/16/main"

echo "=== Setting up DR Replica ==="
echo "Primary: ${PRIMARY_HOST}"
echo "DR: ${DR_HOST}"

# 1. Stop PostgreSQL on DR node
systemctl stop postgresql

# 2. Backup existing data
if [ -d "${PG_DATA}" ]; then
    mv "${PG_DATA}" "${PG_DATA}.backup.$(date +%Y%m%d)"
fi

# 3. Base backup from primary
pg_basebackup \
    --host="${PRIMARY_HOST}" \
    --port=5432 \
    --username="${REPLICATION_USER}" \
    --pgdata="${PG_DATA}" \
    --wal-method=stream \
    --checkpoint=fast \
    --progress \
    --verbose

# 4. Configure as standby
cat > 「${PG_DATA}/postgresql.auto.conf」 << EOF
# DR Replica Configuration
primary_conninfo = 'host=${PRIMARY_HOST} port=5432 user=${REPLICATION_USER} password=${PG_REPLICATION_PASSWORD} sslmode=verify-full sslcert=/etc/ssl/certs/pg-client.crt sslkey=/etc/ssl/private/pg-client.key sslrootcert=/etc/ssl/certs/ca.crt application_name=dr-replica'
primary_slot_name = 'dr_replica'
recovery_target_timeline = 'latest'
restore_command = 'pgbackrest --stanza=healthcare archive-get %f "%p"'

# Performance
max_standby_streaming_delay = 30s
max_standby_archive_delay = 60s
hot_standby = on
hot_standby_feedback = on
EOF

# 5. Create standby signal
touch "${PG_DATA}/standby.signal"

# 6. Fix permissions
chown -R postgres:postgres "${PG_DATA}"
chmod 700 "${PG_DATA}"

# 7. Start PostgreSQL
systemctl start postgresql

# 8. Verify replication
sleep 5
REPLAY_LAG=$(psql -h localhost -tAc \
    "SELECT EXTRACT(EPOCH FROM replay_lag) FROM pg_stat_wal_receiver" 2>/dev/null)
echo "レプリケーション ラグ: ${REPLAY_LAG:-N/A} 秒"

echo "==== DR レプリカのセットアップが完了しました ===
6. Microservices State Recovery
6.1. Recovery Scope
| Component | State | Recovery |
|---|---|---|
| PostgreSQL | Patient data (PHI) | PITR/Replica |
| Kafka | Consumer offsets | Reset offset |
| Kafka | Topic data | Replay logs |
| Keycloak | Realm, users, roles | Realm export |
| HashiCorp Vault | Encryption keys | Snapshot |
| Elasticsearch | Audit logs | Snapshot |
| Application Config | ConfigMaps, Secrets | Git + Velero |
| Container Images | Docker images | Registry |
| Certificates | TLS certs | cert-manager |
6.2. Kafka Consumer Offset Recovery
#!/bin/bash
#kafka-recovery.sh
# リカバリ Kafka コンシューマー オフセットとトピック

set -euo パイプ失敗

KAFKA_BOOTSTRAP="kafka.hospital.internal:9093"
GROUP_ID="患者サービス"

エコー "=== Kafka リカバリ ===

# オプション 1: 最新の状態にリセット (見逃したメッセージをスキップ)
echo "コンシューマ グループを最新の状態にリセットしています..."
kafka-consumer-groups.sh\
    --bootstrap-server "${KAFKA_BOOTSTRAP}" \
    --グループ "${GROUP_ID}" \
    --reset-offsets \
    --最新の\
    --すべてのトピック \
    --実行\
    --command-config /etc/kafka/client.properties

# オプション 2: 特定のタイムスタンプにリセットする
#kafka-consumer-groups.sh\
# --bootstrap-server "${KAFKA_BOOTSTRAP}" \
# --グループ "${GROUP_ID}" \
# --reset-offsets \
# --to-datetime "2024-03-15T00:00:00.000" \
# --すべてのトピック \
# --実行\
# --command-config /etc/kafka/client.properties

# オプション 3: 特定のオフセットにリセットする
#kafka-consumer-groups.sh\
# --bootstrap-server "${KAFKA_BOOTSTRAP}" \
# --グループ "${GROUP_ID}" \
# --reset-offsets \
# --to-オフセット 12345 \
# --topic healthcare.patient-events \
# --実行\
# --command-config /etc/kafka/client.properties

echo "現在のコンシューマ グループのステータス:"
kafka-consumer-groups.sh\
    --bootstrap-server "${KAFKA_BOOTSTRAP}" \
    --グループ "${GROUP_ID}" \
    --説明\
    --command-config /etc/kafka/client.properties
6.3. Keycloak Realm Backup & Restore
#!/bin/bash
# keycloak-backup.sh
# Keycloakレルム構成をバックアップします

set -euo パイプ失敗

KC_URL="${KEYCLOAK_URL:-http://keycloak:8080}」
REALM="ヘルスケア"
BACKUP_DIR="/var/backups/keycloak"
DATE=$(日付 +%Y%m%d_%H%M%S)

# 管理者トークンを取得する
TOKEN=$(curl -s -X POST "${KC_URL}/realms/master/protocol/openid-connect/token" \
    -d "client_id=管理者-cli" \
    -d "ユーザー名=管理者" \
    -d "パスワード=${KC_ADMIN_PASSWORD}" \
    -d "grant_type=パスワード" | jq -r '.access_token')

# レルムのエクスポート (ユーザー、ロール、クライアント、グループを含む)
echo "レルムをエクスポートしています: ${REALM}"
カール -s -H "認証: ベアラー ${TOKEN}" \
    "${KC_URL}/admin/realms/${REALM}" \
    -o "${BACKUP_DIR}/realm-${REALM}-${DATE}.json"

# ユーザーを個別にエクスポートします (完全復元用の資格情報を使用)
カール -s -H "認証: ベアラー ${TOKEN}" \
    "${KC_URL}/admin/realms/${REALM}/users?max=10000" \
    -o "${BACKUP_DIR}/users-${REALM}-${DATE}.json"

# バックアップを暗号化する
openssl enc -aes-256-cbc -salt \
    -in "${BACKUP_DIR}/realm-${REALM}-${DATE}.json" \
    -out "${BACKUP_DIR}/realm-${REALM}-${DATE}.json.enc" \
    -パスファイル:/etc/healthcare/バックアップ暗号化キー\
    -pbkdf2 -iter 100000

rm "${BACKUP_DIR}/realm-${REALM}-${DATE}.json"

echo "Keycloakレルムバックアップ: ${BACKUP_DIR}/realm-${REALM}-${DATE}.json.enc"
7. Velero を使用した Kubernetes DR
7.1. Velero Configuration
# velero-install.yaml
APIバージョン: v1
種類: 名前空間
メタデータ:
  名前:ヴェレロ
---
# Velero のインストール値
# helm install velero vmware-tanzu/velero -f velero-values.yaml -n velero
構成:
  バックアップストレージの場所:
    - 名前: デフォルト
      プロバイダー: AWS
      バケット: 病院-k8s-バックアップ
      構成:
        リージョン: ap-southeast-1
        s3ForcePathStyle: true
  volumeSnapshotLocation:
    - 名前: デフォルト
      プロバイダー: AWS
      構成:
        リージョン: ap-southeast-1

資格情報:
  useSecret: true
  秘密の内容:
    クラウド: |
      [デフォルト]
      aws_access_key_id=AKIAIOSFODNN7EXAMPLE
      aws_secret_access_key=wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY

初期コンテナ:
  - 名前: velero-plugin-for-aws
    画像: velero/velero-plugin-for-aws:v1.9.0
    ボリュームマウント:
      - 名前: プラグイン
        マウントパス: /target

デフォルトボリュームToFsBackup: true

スケジュール:
  ヘルスケアデイリー:
    スケジュール:「0 3 * * *」
    テンプレート:
      ttl: "720h0m0s" # 30 日
      含まれる名前空間:
        - ヘルスケア
      ラベルセレクター:
        マッチラベル:
          バックアップ: "真"
      スナップショットボリューム: true
      storageLocation: デフォルト
7.2. Velero Backup & Restore Commands
#!/bin/bash
#velero-healthcare.sh
# 医療向け Kubernetes DR 運用

ケース「${1:-}」
    バックアップ)
        echo "ヘルスケア名前空間のバックアップを作成しています..."
        velero バックアップ作成ヘルスケア-$(日付 +%Y%m%d-%H%M) \
            --include-namespaces healthcare\
            --スナップショット ボリューム \
            --default-volumes-to-fs-backup \
            --待ってください
        ;;

    復元)
        BACKUP_NAME="${2:-}"
        if [ -z "$BACKUP_NAME" ];それから
            echo "利用可能なバックアップ:"
            velero バックアップの取得 |グレップヘルスケア
            出口1
        フィ

        echo "バックアップから復元中: ${BACKUP_NAME}"
        velero 復元作成 \
            --バックアップから "${BACKUP_NAME}" \
            --include-namespaces healthcare\
            --restore-volumes \
            --待ってください
        ;;

    リスト)
        echo "==== バックアップ ===
        velero バックアップの取得 |グレップヘルスケア
        エコー「」
        echo "=== 復元 ===
        ヴェレロ復元取得 |グレップヘルスケア
        ;;

    *)
        echo "使用量: $0 {バックアップ|復元 <backup-name>|リスト}"
        ;;
イーサック
8. DR Testing & Validation
8.1. DR Test Runbook
Healthcare DR Test Runbook:
Pre-Test (T-1 week):
- Notify all stakeholders
- Verify backup integrity (
pgbackrest verify) - Confirm DR environment is ready
- Review escalation contacts
- Prepare rollback plan
Test Execution:
- T+0:00 — Simulate primary failure
- T+0:01 — Verify automated failover triggered
- T+0:05 — Verify DR database accessible
- T+0:10 — Verify application connectivity
- T+0:15 — Verify PHI data integrity (record counts)
- T+0:20 — Test critical operations: Patient lookup, Lab result entry, Prescription creation, Audit log writing
- T+0:30 — Verify audit trail continuity
- T+0:45 — Performance benchmarks
Post-Test:
- Document actual RTO achieved
- Document actual RPO (data loss)
- Document any issues encountered
- Update DR plan based on findings
- Failback to primary
- Verify failback successful
- Submit test report to compliance
Frequency: Quarterly (HIPAA Addressable §164.308(a)(7)(iv))
8.2. Automated DR Test Script
#!/bin/bash
# dr-test.sh
# 医療システム用の自動 DR テスト スクリプト

set -euo パイプ失敗

DR_HOST="${DR_HOST:-pg-dr.hospital.internal}"
DR_PORT="${DR_PORT:-5432}"
DR_DB="ヘルスケア"
DR_USER="アプリユーザー"
REPORT_FILE="dr-test-report-$(日付 +%Y%m%d_%H%M%S).json"

パス=0
失敗=0
TOTAL_START=$(日付 +%s)

log_test() {
    local test_name=$1
    ローカルステータス=$2
    ローカル期間=$3
    地元の詳細=$4

    if [ "$status" = "PASS" ];次に ((PASS++)); else ((FAIL++));フィ

    echo "{\"test\":\"${test_name}\",\"status\":\"${status}\",\"duration_ms\":${duration},\"details\":\"${details}\"}" >> "${REPORT_FILE}"
    echo "[$status] ${test_name} (${duration}ms): ${details}"
}

echo "=== ヘルスケア DR テスト - $(日付) === | T シャツ「${REPORT_FILE}」

# テスト 1: データベース接続
START=$(日付 +%s%N)
if pg_isready -h "$DR_HOST" -p "$DR_PORT" -d "$DR_DB" > /dev/null 2>&1;それから
    DURATION=$(( ($(日付 +%s%N) - 開始) / 1000000 ))
    log_test "db_connectivity" "PASS" "$DURATION" "PostgreSQL は接続を受け入れています"
それ以外は。それ以外の場合
    DURATION=$(( ($(日付 +%s%N) - 開始) / 1000000 ))
    log_test "db_connectivity" "FAIL" "$DURATION" "DR データベースに接続できません"
フィ

# テスト 2: 患者データの整合性
START=$(日付 +%s%N)
PATIENT_COUNT=$(psql -h "$DR_HOST" -p "$DR_PORT" -U "$DR_USER" -d "$DR_DB" \
    -tAc "healthcare.patients から COUNT(*) を選択" 2>/dev/null ||エコー「0」)
DURATION=$(( ($(日付 +%s%N) - 開始) / 1000000 ))
if [ "$PATIENT_COUNT" -gt 0 ];それから
    log_test "patient_data_integrity" "PASS" "$DURATION" "患者記録: ${PATIENT_COUNT}"
それ以外は。それ以外の場合
    log_test "patient_data_integrity" "FAIL" "$DURATION" "患者記録が見つかりません"
フィ

# テスト 3: 監査ログの整合性
START=$(日付 +%s%N)
AUDIT_COUNT=$(psql -h "$DR_HOST" -p "$DR_PORT" -U "$DR_USER" -d "$DR_DB" \
    -tAc "compliance.audit_logs から COUNT(*) を選択" 2>/dev/null ||エコー「0」)
DURATION=$(( ($(日付 +%s%N) - 開始) / 1000000 ))
if [ "$AUDIT_COUNT" -gt 0 ];それから
    log_test "audit_log_integrity" "PASS" "$DURATION" "監査ログ エントリ: ${AUDIT_COUNT}"
それ以外は。それ以外の場合
    log_test "audit_log_integrity" "FAIL" "$DURATION" "監査ログ エントリがありません"
フィ

# テスト 4: レプリケーションの遅延
START=$(日付 +%s%N)
LAG=$(psql -h "$DR_HOST" -p "$DR_PORT" -U "$DR_USER" -d "$DR_DB" \
    -tAc "SELECT EXTRACT(EPOCH FROM NOW() - pg_last_xact_replay_timestamp())::INTEGER" 2>/dev/null ||エコー「-1」)
DURATION=$(( ($(日付 +%s%N) - 開始) / 1000000 ))
if [ "$LAG" -ge 0 ] && [ "$LAG" -lt 300 ];それから
    log_test "replication_lag" "PASS" "$DURATION" "ラグ: ${LAG}s (< 5 min)"
else
    log_test "replication_lag" "FAIL" "$DURATION" "Lag: ${LAG}s (too high or unknown)"
fi

# Test 5: Encrypted columns readable
START=$(date +%s%N)
ENCRYPTED=$(psql -h "$DR_HOST" -p "$DR_PORT" -U "$DR_USER" -d "$DR_DB" \
    -tAc "SELECT full_name FROM healthcare.patients LIMIT 1" 2>/dev/null ||エコー「エラー」)
DURATION=$(( ($(日付 +%s%N) - 開始) / 1000000 ))
if [[ "$ENCRYPTED" == vault:* ]] || [ "$ENCRYPTED" != "エラー" ];それから
    log_test "encrypted_data_access" "PASS" "$DURATION" "暗号化された列にアクセス可能"
それ以外は。それ以外の場合
    log_test "encrypted_data_access" "FAIL" "$DURATION" "暗号化された列を読み取れません"
フィ

# テスト 6: 書き込み機能 (昇格後)
START=$(日付 +%s%N)
WRITE_TEST=$(psql -h "$DR_HOST" -p "$DR_PORT" -U "$DR_USER" -d "$DR_DB" \
    -tAc "SELECT pg_is_in_recovery()" 2>/dev/null ||エコー「エラー」)
DURATION=$(( ($(日付 +%s%N) - 開始) / 1000000 ))
if [ "$WRITE_TEST" = "f" ];それから
    log_test "write_capability" "PASS" "$DURATION" "データベースは読み取り/書き込みモードです"
elif [ "$WRITE_TEST" = "t" ];それから
    log_test "write_capability" "PASS" "$DURATION" "データベースは回復中です (レプリカ) — 書き込みにはプロモートが必要です"
それ以外は。それ以外の場合
    log_test "write_capability" "FAIL" "$DURATION" "データベース モードを決定できません"
フィ

#概要
TOTAL_DURATION=$(( $(日付 +%s) - TOTAL_START ))
合計=$((合格 + 不合格))

エコー「」
echo "==== DR テストの概要 ===
echo "テストの合計: ${TOTAL}"
エコー "合格: ${PASS}"
エコー「失敗しました: ${FAIL}」
エコー「期間: ${TOTAL_DURATION}s」

if [ "$FAIL" -eq 0 ];それから
    echo "結果: すべてのテストに合格しました"
それ以外は。それ以外の場合
    echo "結果: ${FAIL} テストが失敗しました — 確認して修正します"
フィ
9. Backup & DR Checklist
9.1. Comprehensive Healthcare DR Checklist
| # | Item | Frequency | Owner | Status |
|---|---|---|---|---|
| 1 | Full database backup (pgBackRest) | Weekly | DBA | |
| 2 | Differential backup | Daily | DBA | |
| 3 | Incremental backup | Hourly | Automated | |
| 4 | Backup encryption verification | Weekly | Security | |
| 5 | Backup integrity check (pgbackrest verify) | Daily | Automated | |
| 6 | PITR test restore | Monthly | DBA | |
| 7 | Replication lag monitoring | Real-time | Monitoring | |
| 8 | DR failover test | Quarterly | DR Team | |
| 9 | Full DR simulation | Annually | All Teams | |
| 10 | Keycloak realm backup | Daily | DevOps | |
| 11 | Vault snapshot | Daily | Security | |
| 12 | Kafka topic backup | Daily | DevOps | |
| 13 | Kubernetes state backup (Velero) | Daily | DevOps | |
| 14 | Audit log backup verification | Weekly | Compliance | |
| 15 | DR documentation review | Quarterly | DR Lead | |
| 16 | Backup retention check (6-year HIPAA) | Monthly | Compliance | |
| 17 | Cross-region backup sync | Real-time | Automated | |
| 18 | Emergency contact list update | Quarterly | Management | |
| 19 | RPO/RTO metrics review | Monthly | DR Lead | |
| 20 | Compliance report submission | Annually | CISO |
9.2. Backup Monitoring Queries
-- バックアップのステータスと健全性を監視する

-- 1. WAL アーカイブ ステータスを確認する
選択
    アーカイブ数、
    last_archived_wal、
    last_archived_time、
    失敗数、
    last_failed_wal、
    last_failed_time
pg_stat_archiver から;

-- 2. レプリケーションの遅延
選択
    クライアントアドレス、
    アプリケーション名、
    状態、
    送信済み_lsn、
    write_lsn、
    フラッシュ_lsn、
    リプレイ_lsn、
    pg_wal_lsn_diff(sent_lsn、replay_lsn) AS lag_bytes、
    書き込み遅延、
    フラッシュラグ、
    リプレイラグ
pg_stat_replication から;

-- 3. レプリケーションスロットのステータス
選択
    スロット名、
    スロットタイプ、
    アクティブな、
    再起動_lsn、
    確認済み_flush_lsn、
    pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn) AS slot_lag_bytes
pg_replication_slots から;

-- 4. データベース サイズ (バックアップ計画用)
選択
    pg_database.datname AS データベース名、
    pg_size_pretty(pg_database_size(pg_database.datname)) AS size
pg_データベースから
ORDER BY pg_database_size(pg_database.datname) DESC;

-- 5. テーブル サイズ (バックアップを最適化するために最大のテーブルを特定する)
選択
    スキーマ名 || 「。」 ||テーブル名 AS table_name、
    pg_size_pretty(pg_total_relation_size(スキーマ名 || '.' || テーブル名)) AS total_size,
    pg_size_pretty(pg_relation_size(スキーマ名 || '.' || テーブル名)) AS table_size,
    pg_size_pretty(pg_indexes_size(スキーマ名 || '.' || テーブル名)) AS インデックスサイズ
pg_tables から
WHERE スキーマ名 IN ('ヘルスケア'、'コンプライアンス')
ORDER BY pg_total_relation_size(スキーマ名 || '.' || テーブル名) DESC
制限 20;
## まとめ
このレッスンでは、医療向けの包括的な バックアップ、災害復旧、ビジネス継続性 を構築しました。
- HIPAA 緊急時対応計画: データ バックアップ計画、災害復旧計画、緊急モード運用 - §164.308(a)(7) に準拠
- RTO/RPO 要件: 重要なシステム (EHR、ラボ) には RPO < 1 分、RTO < 15 分が必要です。重要度レベルの決定
- PostgreSQL バックアップ: pg_dump (論理)、pg_basebackup (物理)、RPO/速度/複雑さによる方法の比較
- pgBackRest: 増分バックアップ、AES-256 暗号化、S3 ストレージ、自動スケジュール (時間ごと、毎日、毎週) を備えた本番バックアップ ソリューション
- PITR: WAL アーカイブからのポイントインタイムリカバリ - データベースを任意の特定の時点に復元します
- Patroni HA: etcd コンセンサスによる自動フェイルオーバー、同期レプリケーション (RPO = 0)、HAProxy ロード バランシング
- クロスリージョン DR: DR リージョンへの非同期レプリケーション、暗号化された WAL ストリーミング、フェイルオーバー手順
- Microservices Recovery: Kafka consumer offset reset, Keycloak realm export, Vault snapshots
- Kubernetes DR: Velero backup cho namespace state, PV snapshots, scheduled backups
- DR Testing: Quarterly test runbook, automated DR test scripts, validation checklist
## エクササイズ
-
pgBackRest のセットアップ: pgBackRest をローカル PostgreSQL にインストールします。スタンザ構成
ヘルスケアローカルリポジトリを使用します。完全バックアップの作成、データの追加、増分バックアップの作成。バックアップを検証するpgbackrest 検証。 PITR をテストします。データベースをデータを追加する前の時点に復元します。 -
Patroni HA クラスター: Docker Compose スタック (etcd × 3、PostgreSQL × 2、HAProxy) をデプロイします。プライマリ/レプリカの役割を検証する
守護者リスト。同期レプリケーションが機能することを確認します。フェールオーバーのテスト: プライマリ コンテナーを停止し、レプリカの自己昇格を確認します。フェイルオーバー時間を測定します (目標 < 30 秒)。 -
DR Test Script: Customize script
お使いの環境の dr-test.sh。テスト ケースを追加します: SSL 証明書の有効性、アプリケーション エンドポイントの健全性、API 応答時間。テスト スクリプトを実行し、レポートを生成します。失敗があれば修正してください。スケジュールは cron を使用して毎月実行されます。 -
エンドツーエンドの DR シミュレーション: ヘルスケア スタック全体 (PostgreSQL + Keycloak + config) をバックアップします。災害をシミュレートします: プライマリ データベースを破壊します。バックアップから復元します (PITR)。 Keycloakレルムを復元します。検証: Keycloakにログインし、患者にクエリを実行し、監査ログが損なわれていないことを確認します。文書: 実際の RPO、実際の RTO、学んだ教訓。
| ◀ 前の記事 | 次の記事 ▶ |
|---|---|
| レッスン 19: PHI のデータマスキング、匿名化、匿名化 | レッスン 21: 医療システムのゼロトラスト アーキテクチャ |