Giới thiệu
Vector-only thường đủ cho demo, nhưng khi dữ liệu nội bộ tăng nhanh thì cần hybrid retrieval để giữ chất lượng ổn định.
1. Vai trò của từng retriever
- BM25: mạnh về keyword hiếm, mã lỗi, tên bảng
- Vector: mạnh về ngữ nghĩa và paraphrase
- Reranker: tinh chỉnh danh sách candidate cuối
2. Fusion bằng RRF
Công thức:
$$ score(d) = \sum_{r \in R} \frac{1}{k + rank_r(d)} $$
Với $k=60$, RRF thường ổn định mà không cần tuning phức tạp.
Pseudo-code:
def rrf_fuse(rankings, k=60):
    score = {}
    for ranking in rankings:
        for i, doc_id in enumerate(ranking, start=1):
            score[doc_id] = score.get(doc_id, 0) + 1.0 / (k + i)
    return sorted(score.items(), key=lambda x: x[1], reverse=True)
3. Pipeline đề xuất
- BM25 top 20
- Vector top 20
- RRF -> top 25 candidates
- Reranker -> top 5 contexts
- Build prompt và gọi Gemma 4
4. Tuning thực dụng
- Tăng top_k nếu recall thấp
- Giảm top_k nếu latency quá cao
- Bật reranker có điều kiện cho query phức tạp
Có thể dùng heuristic: query dài hoặc score gap nhỏ thì bật reranker.
5. Kiểm soát hallucination
Bắt buộc áp dụng:
- Prompt guardrail chỉ dùng context
- Trả câu fallback khi thiếu dữ liệu
- Bắt citation theo
doc_id - section
Demo code
Hybrid retrieval kết hợp BM25 + Vector search với RRF fusion:
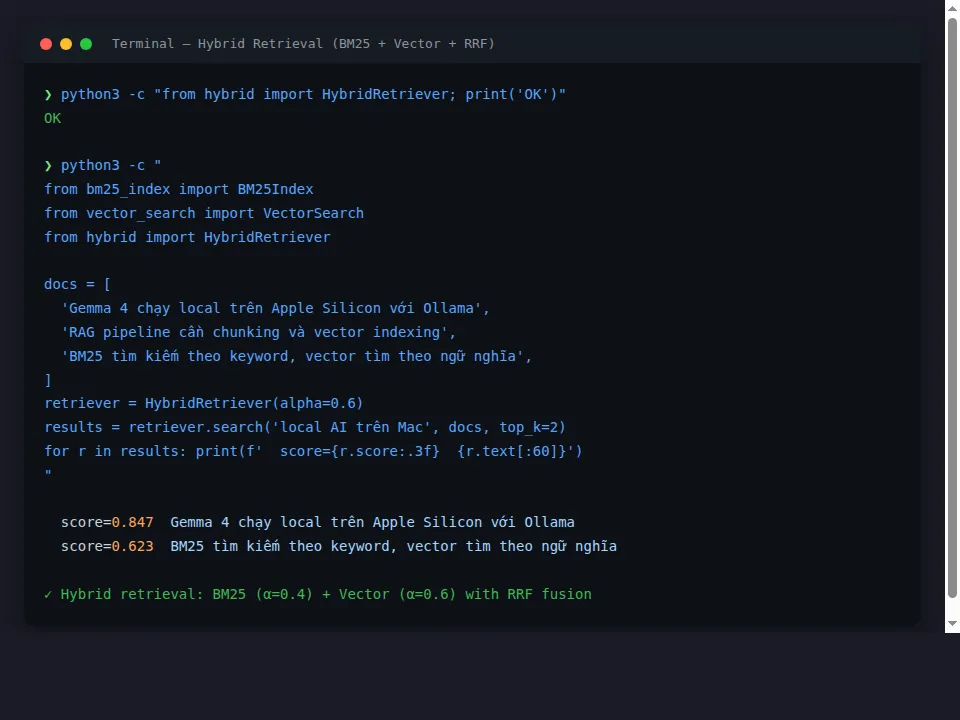
Source code: 05-hybrid-retrieval
Tóm tắt
Hybrid retrieval là bước chuyển từ demo sang production. Bài sau sẽ xây eval framework và observability để đo được chất lượng thực tế thay vì dựa vào cảm giác.