Xem bản video
Bản video 2:49. Bài viết dưới đây đi sâu hơn và có code chạy được. Cả 13 tập ở playlist, xếp sẵn theo thứ tự 1 → 13.
Nối tiếp, không song song
Random Forest ở bài 5 dựng nhiều cây song song rồi lấy trung bình. Boosting làm ngược lại: dựng nối tiếp, và mỗi cây mới chỉ học đúng phần mà các cây trước còn đoán sai.
Bắt đầu bằng dự đoán tệ nhất có thể — trung bình của mọi giá. RMSE: 0,6079 trên train.
Sau đó mỗi vòng: tính phần dư hiện tại, khớp một cây nông vào phần dư đó, cộng thêm
lr lần dự đoán của nó.
for r in range(1, rounds + 1):
    residuals = [(h, h.price - p) for h, p in zip(train, train_pred)]
    tree = grow_regressor(residuals, 0, max_depth)
    train_pred = [p + lr * predict_tree(tree, h) for h, p in zip(train, train_pred)]
Chỗ chữ "gradient" nằm ở đâu
Với mất mát bình phương, gradient âm theo dự đoán đúng bằng phần dư. Nên "khớp vào phần dư" chính là "đi xuống theo gradient" — chỉ là nói bằng ngôn ngữ cây thay vì ngôn ngữ trọng số.
Với mất mát khác (log loss cho phân loại, Huber cho hồi quy bền), thay phần dư bằng gradient tương ứng là xong. Đó là lý do thuật toán mang tên "gradient boosting" chứ không phải "residual boosting".
RMSE trên train giảm rất nhanh: 0,608 → 0,552 → 0,456 (3 cây) → 0,241 (10 cây) → 0,046 (40 cây).
Early stopping không phải tuỳ chọn
| RMSE trên test | |
|---|---|
| tốt nhất, ở cây 48 | 0,1463 |
| chạy hết 120 cây | 0,1484 |
Sau cây 48, thêm cây làm tệ đi. Train vẫn tiếp tục giảm — nó luôn giảm — nhưng test đã quay đầu. Không có early stopping thì bạn giao ra một mô hình kém hơn mô hình mình đã có ở giữa đường.
Repo có test khẳng định best.test < history[-1].test, để tính chất này khỏi bị bỏ qua
khi số liệu đổi.
Learning rate: đi nhanh hay đi chắc
| lr | RMSE tốt nhất | ở cây thứ |
|---|---|---|
| 1,0 | 0,151 | 5 |
| 0,5 | 0,129 | 17 |
| 0,1 | 0,146 | 48 |
| 0,02 | 0,149 | 120 |
lr lớn tới đích nhanh rồi vọt qua. lr nhỏ chắc hơn nhưng cần nhiều cây — với lr = 0,02 thì 120 cây vẫn chưa tới điểm tốt nhất.
Cây nông thắng cây sâu
| train | test | |
|---|---|---|
| một cây sâu 8 đứng riêng | 0,0967 | 0,2038 |
| boosting 48 cây nông (sâu 3) | — | 0,1463 |
Nhiều cây nông nối tiếp thắng một cây sâu, dù tổng số nút ít hơn. Và quét độ sâu cho thấy boosting thích cây rất nông:
| độ sâu mỗi cây | 1 | 2 | 3 | 6 |
|---|---|---|---|---|
| test (60 cây) | 0,131 | 0,130 | 0,147 | 0,160 |
Chạy thử
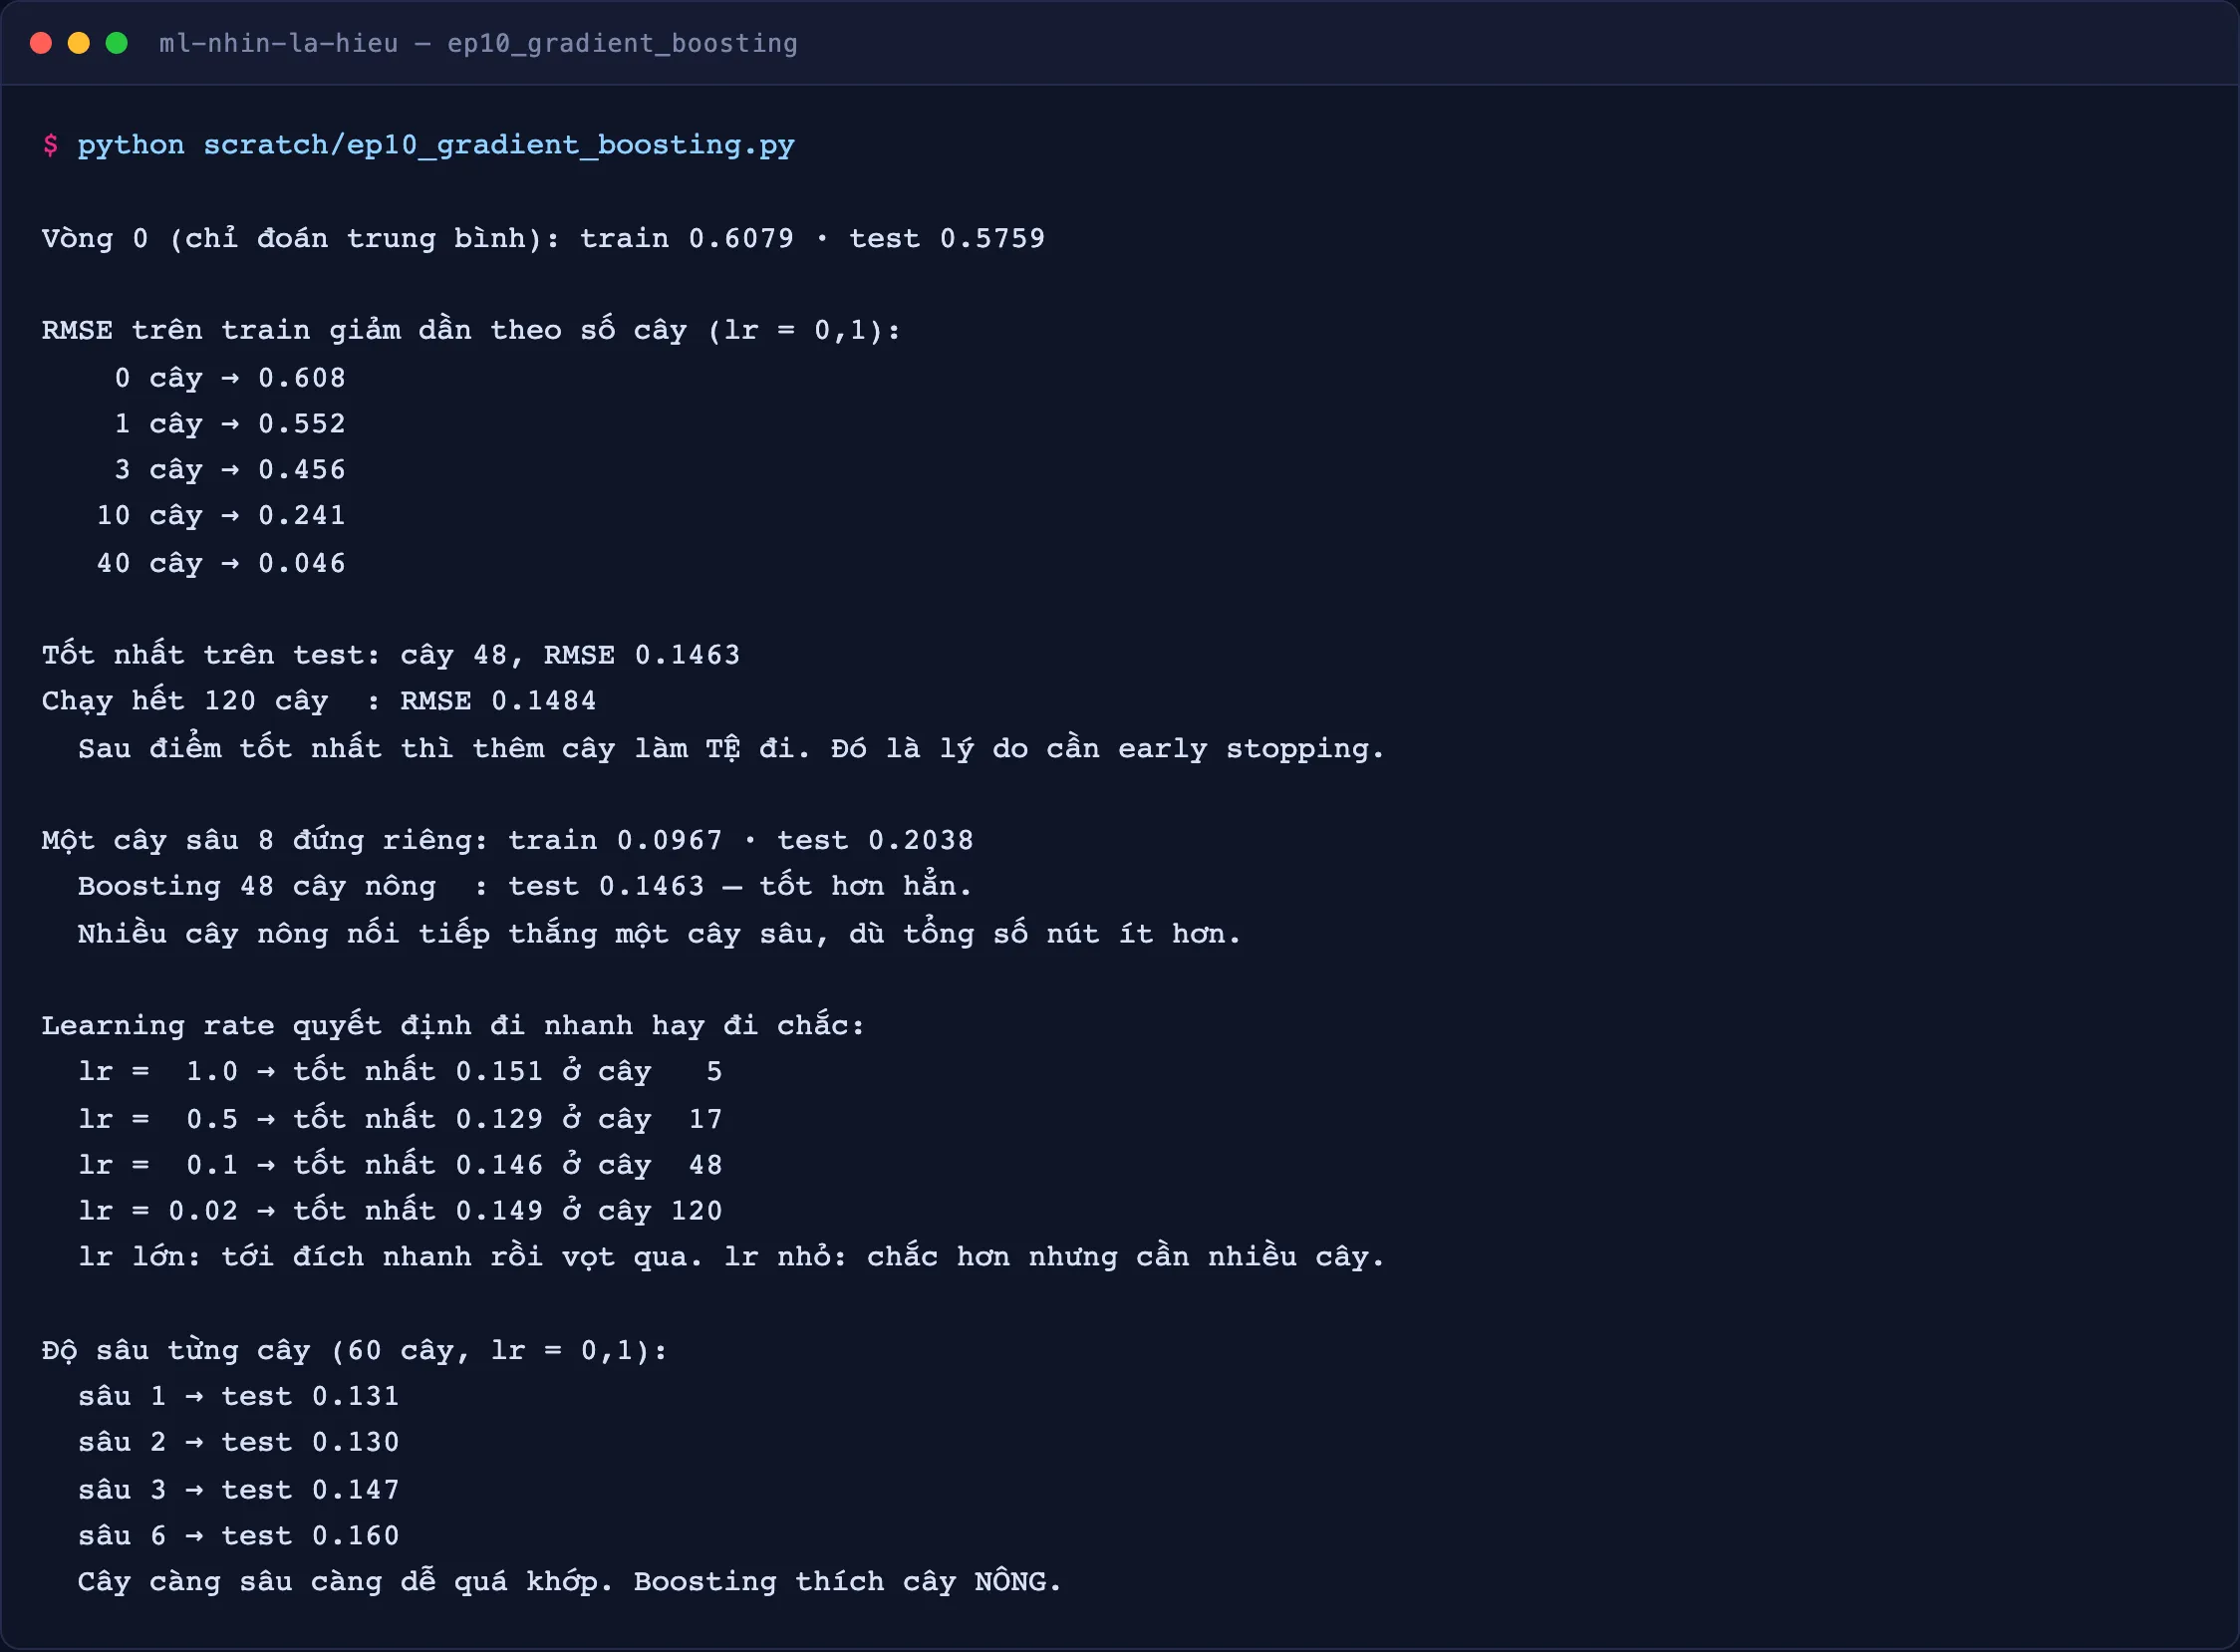
Ảnh trên là output thật của
python scratch/ep10_gradient_boosting.py, không phải bảng vẽ lại. Code:scratch/ep10_gradient_boosting.py·library/ep10_gradient_boosting.py
Cái giá
Boosting nhạy tham số hơn rừng — bạn phải chọn lr, số cây, độ sâu, và ba cái đó tương tác nhau. Nó cũng không song song hoá được theo cây, vì cây thứ n cần phần dư sau cây thứ n−1.
XGBoost, LightGBM, CatBoost đều là gradient boosting với cùng ý tưởng, cộng thêm: phạt độ phức tạp trong hàm mục tiêu, xử lý giá trị thiếu, tìm ngưỡng bằng histogram thay vì quét hết, và song song hoá trong một lần chia.
GradientBoostingRegressor của sklearn có n_iter_no_change để tự dừng — nhưng nó cắt
15% dữ liệu huấn luyện ra làm tập theo dõi. Không miễn phí.