
Series này khác gì
Phần lớn tài liệu ML đi theo thứ tự: công thức trước, ví dụ sau. Series này đi ngược lại — dữ liệu trước, câu hỏi trước, rồi mới tới thuật toán trả lời câu hỏi đó.
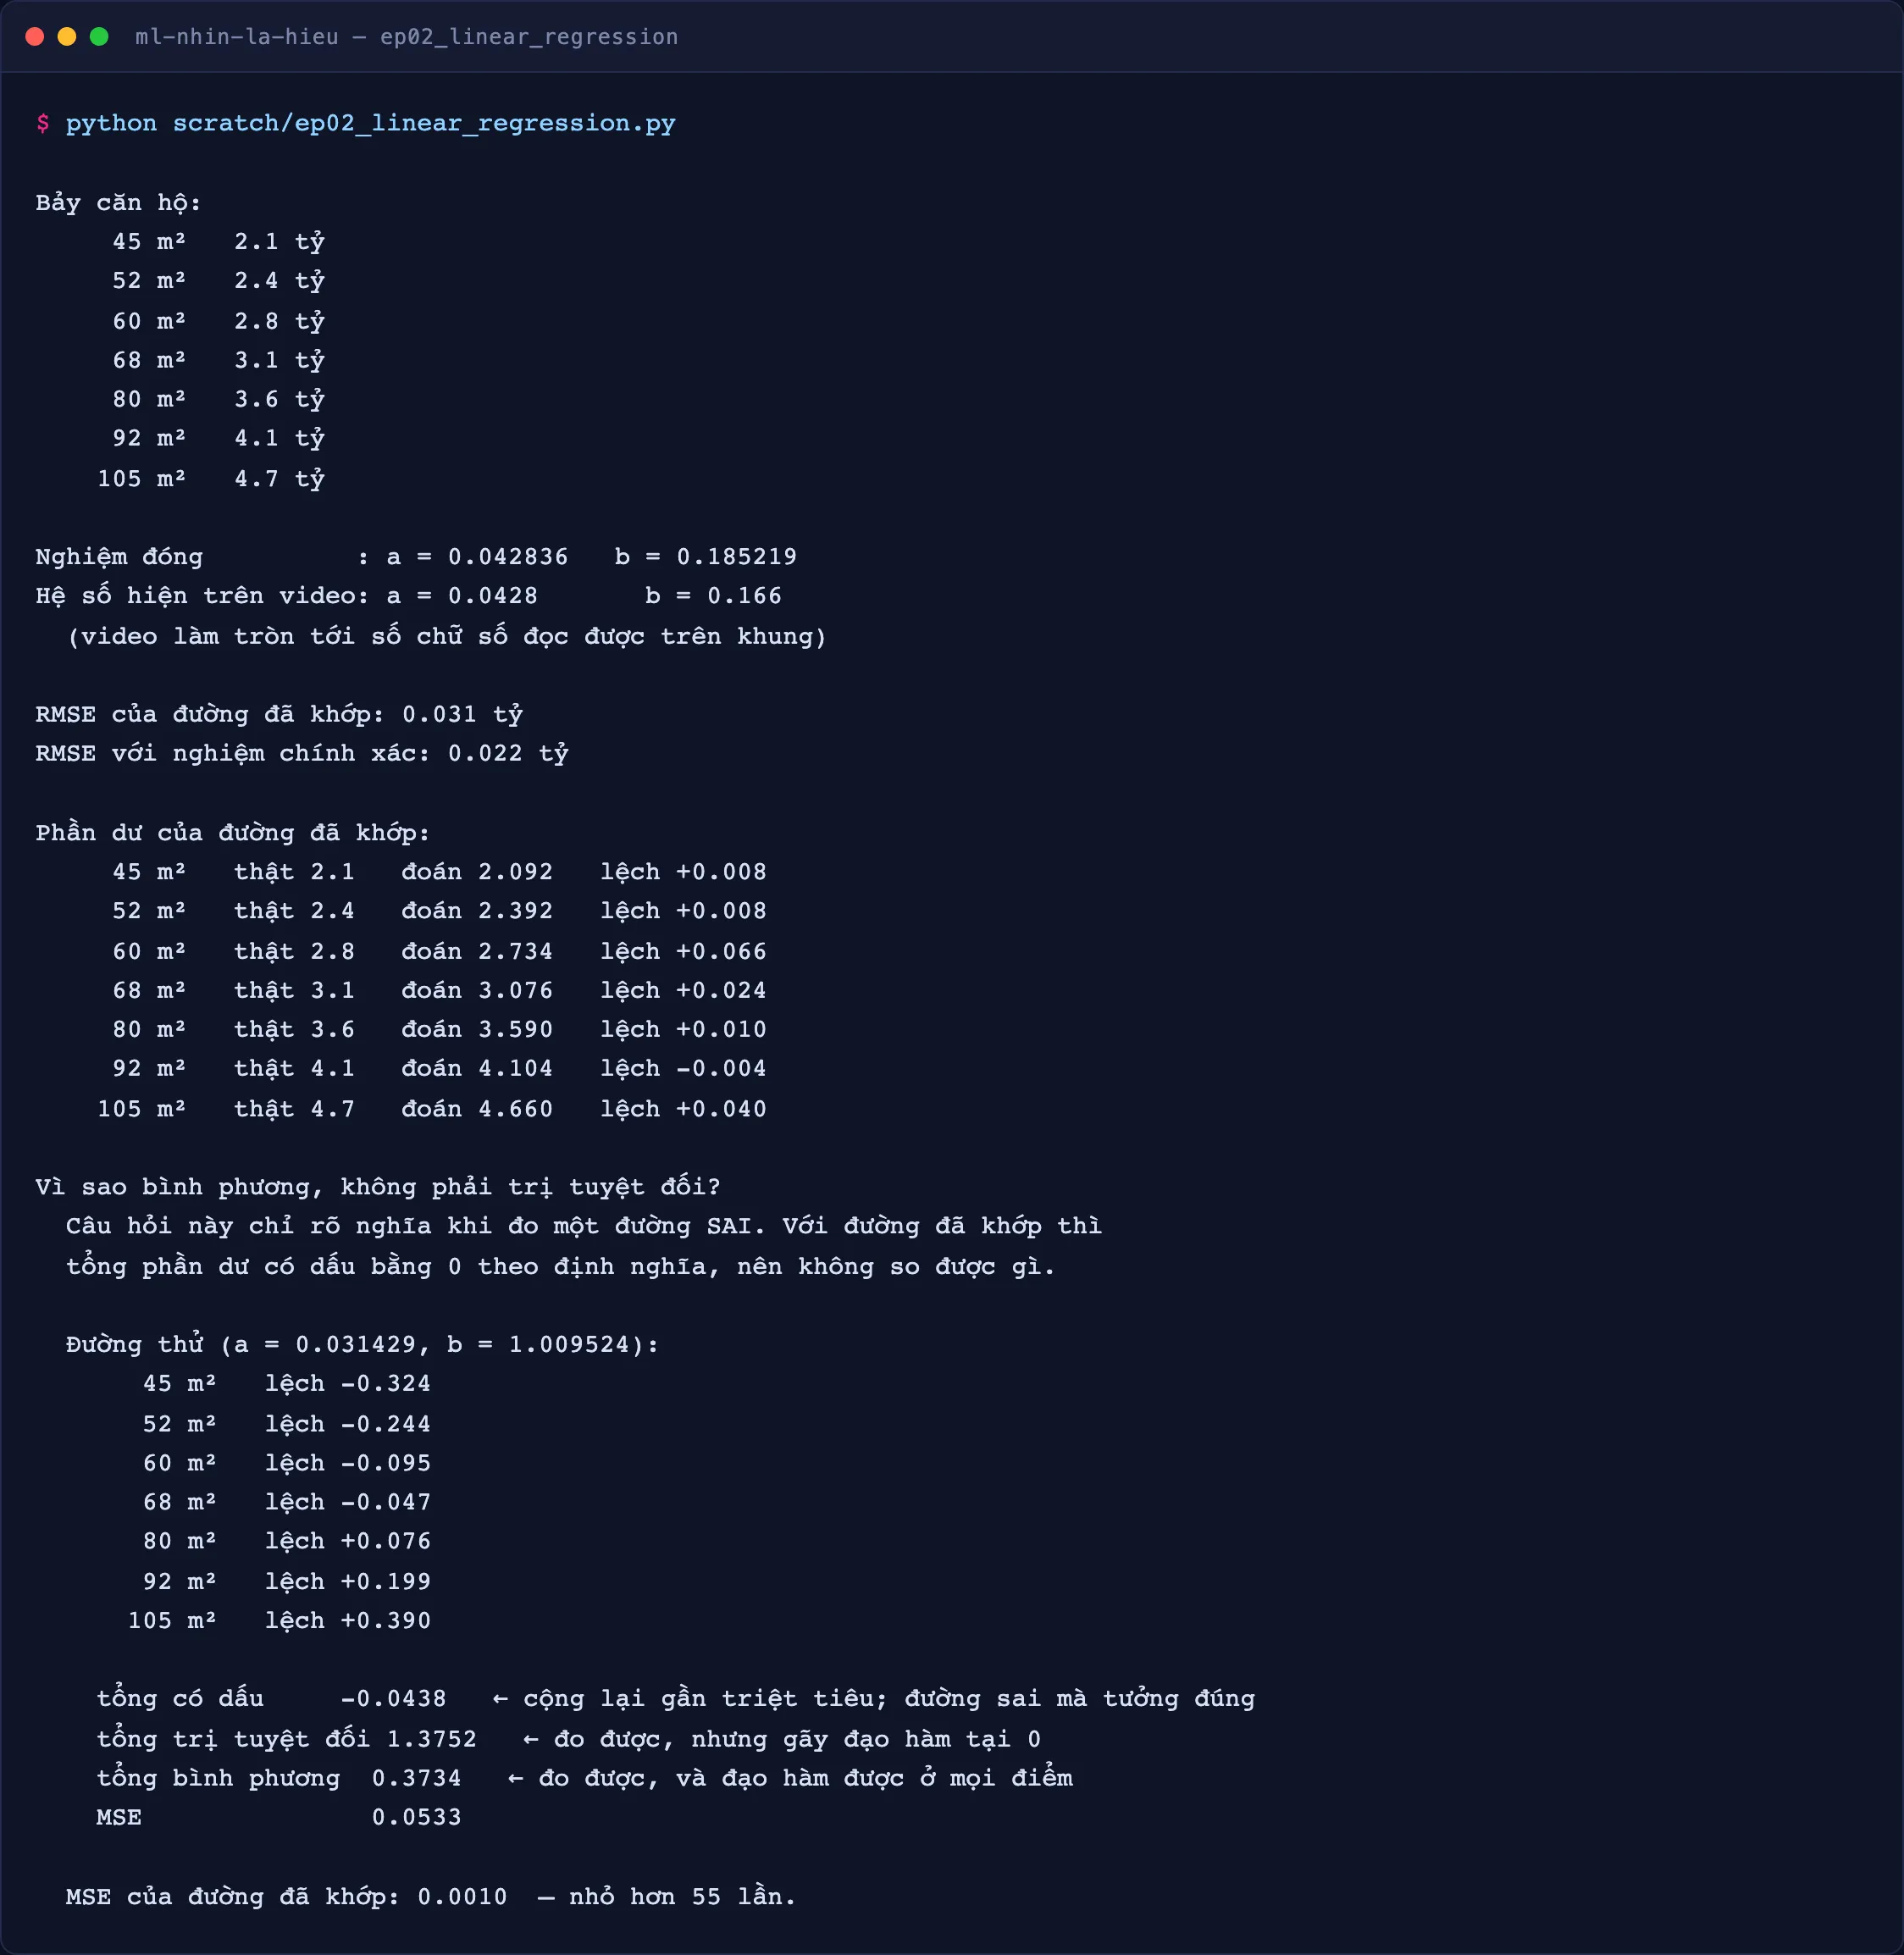
Và mọi con số trên khung hình đều tính ra từ dữ liệu, không ướm cho đẹp. Khi một tập nói "cây sâu không giới hạn đạt 100% trên train nhưng 78% trên test", đó là kết quả của một cây thật mọc trên 140 căn hộ thật. Repo kèm theo cho bạn chạy lại và ra đúng con số ấy.
Bạn sẽ học được gì
- Đọc dữ liệu để chọn thuật toán, thay vì học thuộc danh sách tên
- Hiểu bên trong
fit()có gì, bằng cách tự viết lại nó - Nhận ra chỗ mỗi thuật toán hỏng, và hỏng theo kiểu gì
- Đo mô hình cho đúng — phần quan trọng hơn việc chọn mô hình
- Nhìn ra những cái bẫy im lặng: quên chuẩn hoá, rò dữ liệu, cân bằng tập đo
Cách dùng series
Mỗi bài có ba lớp, đọc lớp nào cũng được:
- Video 3 phút — hiểu ý chính, không cần code. Cả 13 tập ở playlist trên YouTube, xếp sẵn theo thứ tự 1 → 13.
- Bài viết — số liệu đo được, chỗ thuật toán hỏng, và code đọc được
- Repo — github.com/tdduydev/ml-nhin-la-hieu: chạy lại đúng những con số đó, và sửa thử để xem gì đổi
git clone https://github.com/tdduydev/ml-nhin-la-hieu
cd ml-nhin-la-hieu
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
pytest        # 70 test khẳng định mọi con số khớp video
Prerequisites
Biết Python cơ bản: hàm, vòng lặp, list. Không cần biết numpy, không cần nền toán đại học. Chỗ nào cần công thức thì bài viết dựng lại từ đầu.
Ví dụ xuyên suốt
Cả series dùng chung một thế giới: căn hộ — diện tích, giá, khoảng cách tới trung tâm, bán nhanh hay bán chậm. Bạn không phải học lại ngữ cảnh ở mỗi bài, và so sánh giữa các thuật toán trở nên có nghĩa vì chúng cùng trả lời trên cùng dữ liệu.