Xem bản video
Bản video 2:52. Bài viết dưới đây đi sâu hơn và có code chạy được. Cả 13 tập ở playlist, xếp sẵn theo thứ tự 1 → 13.
"Đúng 98%" — trên dữ liệu nào?
Một cây đủ sâu luôn đạt 100% trên dữ liệu nó đã thấy (bài 5 đo được: 100% train, 78% test). Nên con số trên tập huấn luyện không nói được gì cả.
Ba mô hình trên cùng 30 điểm, quan hệ thật là một đường hơi cong:
| train | dữ liệu mới | |
|---|---|---|
| bậc 1 (quá đơn giản) | 0,1028 | 0,0871 |
| bậc 3 (vừa) | 0,0678 | 0,0734 |
| bậc 15 (quá phức tạp) | 0,0341 | 0,0853 |
Bậc 15 giỏi nhất trên train và tệ hơn bậc 3 trên dữ liệu mới. Nếu chỉ nhìn cột train thì bạn chọn sai mô hình.
Một lần tách vẫn còn may rủi
Tách một phần ra rồi đo trên đó là điều tối thiểu. Nhưng tách kiểu nào? Với bậc 3, năm cách tách khác nhau cho năm điểm khác nhau:
0,082 0,070 0,081 0,096 0,050
Chênh từ 0,050 tới 0,096 — gấp 1,9 lần, chỉ vì chia dữ liệu khác nhau. Gặp tập kiểm tra dễ thì điểm cao giả.
k-fold, và độ lệch cũng là thông tin
Cross-validation chia dữ liệu thành k phần. Mỗi lượt, một phần làm tập kiểm tra, các phần còn lại để huấn luyện. Chạy k lượt, và mỗi dòng được kiểm tra đúng một lần.
| trung bình | độ lệch | |
|---|---|---|
| bậc 3 | 0,0758 | 0,0151 |
| bậc 15 | 0,2507 | 0,3429 |
Độ lệch của bậc 15 lớn hơn bậc 3 22,6 lần. Nhìn riêng trung bình thì bậc 15 chỉ "tệ hơn"; nhìn độ lệch thì thấy nó không ổn định — kết quả phụ thuộc rất nhiều vào việc dữ liệu được chia thế nào. Đó là dấu hiệu học vẹt, và trung bình một mình không cho thấy.
Có một lượt của bậc 15 cho 0,934, tức tệ gấp hơn mười lần các lượt khác.
Phạt độ lớn trọng số
Không phạt thì mô hình dùng hệ số khổng lồ để đi qua từng điểm. Ridge cộng λ lần tổng
bình phương trọng số vào hàm mất mát:
for i in range(d):
    for j in range(d):
        value = sum(r[i] * r[j] for r in X)
        if i == j and i > 0:          # hệ số chặn KHÔNG bị phạt
            value += lam
Hệ số chặn không bị phạt. Phạt nó nghĩa là ép mô hình đi qua gần gốc toạ độ — đó là một khẳng định về dữ liệu, không phải một cách chống quá khớp.
Quét λ bằng cross-validation trên bậc 15:
| λ | 0 | 10⁻⁴ | 10⁻³ | 10⁻² | 10⁻¹ | 1 | 10 |
|---|---|---|---|---|---|---|---|
| CV | 0,251 | 0,072 | 0,072 | 0,080 | 0,089 | 0,147 | 0,235 |
Sai số train luôn tăng khi λ tăng — phạt càng nặng thì mô hình càng khó bám dữ liệu cũ. Sai số CV thì hình chữ U: thấp nhất ở λ = 0,001. Đó là giá trị nên dùng.
Ridge và Lasso khác nhau ở đâu
| hệ số về đúng 0 | |
|---|---|
| Ridge, λ = 0,05 | 0 |
| Lasso, λ = 0,6 | 7 |
| Lasso, λ = 0,05 | 5 |
Ridge bóp mọi hệ số nhỏ lại nhưng không bao giờ về đúng 0. Lasso thì về đúng 0, vì trị tuyệt đối gãy tại 0 — và chỗ gãy đó chính là cơ chế.
Lưu ý λ của hai bên khác nhau ở hai dòng đầu, và đó là chủ ý: L1 và L2 phạt trên hai thang khác nhau nên cùng con số λ không nghĩa là cùng cường độ. Dòng thứ ba cho thấy ngay cả ở cùng λ, lasso vẫn đưa hệ số về 0 — nên khác biệt là tính chất của phạt trị tuyệt đối, không phải do chọn λ ưu ái nó.
Đưa hệ số về 0 nghĩa là loại hẳn đặc trưng. Đây mới là chọn lọc đặc trưng — khác PCA ở bài 9, nơi mọi cột đều góp mặt trong trục mới.
Thiên lệch và phương sai
| bậc | thiên lệch² | phương sai | tổng |
|---|---|---|---|
| 1 | 0,0038 | 0,0004 | 0,0042 |
| 2 | 0,0000 | 0,0006 | 0,0007 |
| 3 | 0,0000 | 0,0009 | 0,0009 |
| 8 | 0,0001 | 0,0016 | 0,0017 |
| 15 | 0,0001 | 0,0018 | 0,0019 |
Thiên lệch là mô hình sai một cách hệ thống — thêm dữ liệu cũng không sửa được. Phương sai là mô hình đổi theo việc gặp mẫu nào. Bậc 1 thiên lệch cao, bậc 15 phương sai cao, và không giảm được cả hai cùng lúc. Regularization là cái núm chọn điểm trên đường đánh đổi này.
Chạy thử
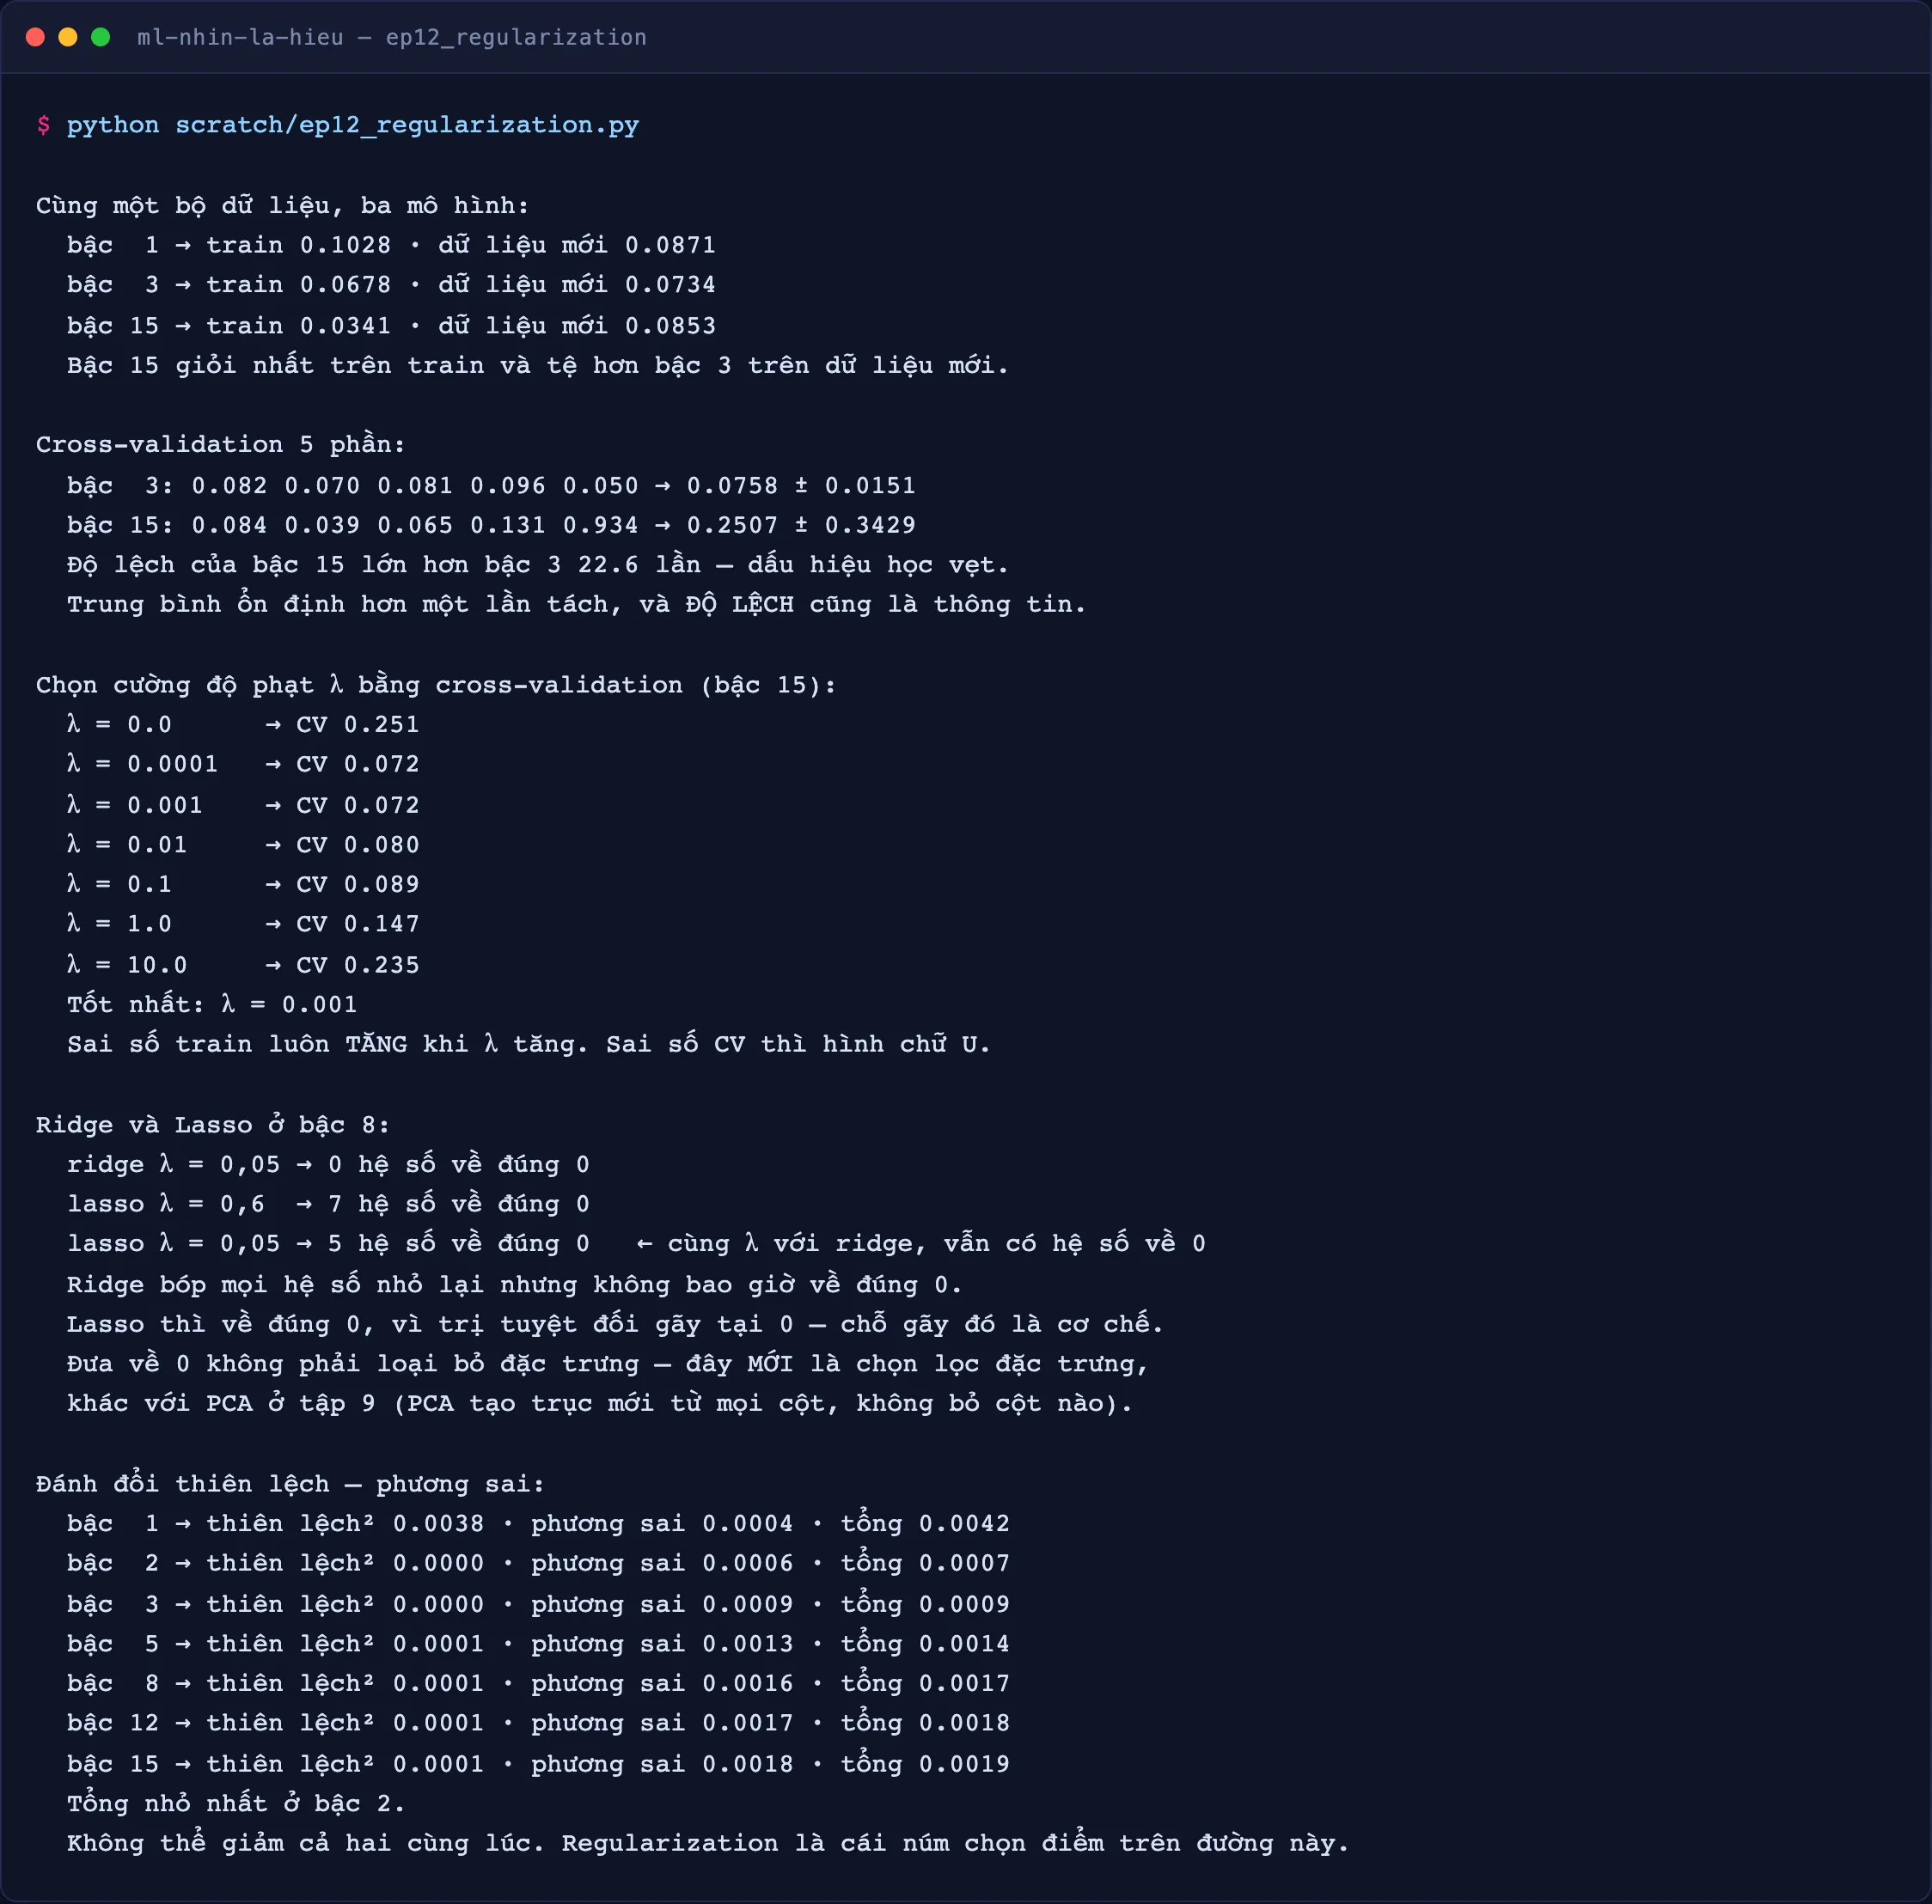
Ảnh trên là output thật của
python scratch/ep12_regularization.py, không phải bảng vẽ lại. Code:scratch/ep12_regularization.py·library/ep12_regularization.py
Hai cách tự lừa mình
Rò dữ liệu. Chuẩn hoá trên cả bộ dữ liệu trước khi tách thì trung bình và độ lệch chuẩn đã "thấy" tập kiểm tra. Điểm bạn đo sẽ cao hơn thực tế. Chỉ tính thống kê trên tập huấn luyện, rồi áp dụng cùng con số đó cho tập kiểm tra.
Dùng tập test nhiều lần. Chỉnh mô hình theo tập kiểm tra là một lần làm nó bớt mới. Tới lần thứ ba mươi thì nó không còn là dữ liệu chưa thấy. Cách đúng: chọn mọi thứ trên tập validation, và chỉ chạm vào test một lần, ở cuối.
Một chỗ số học đáng biết
Bản viết tay giải bằng phương trình chuẩn. Ở bậc 15, ma trận Vandermonde điều kiện rất
xấu nên nghiệm mất chính xác — sklearn dùng lstsq, ổn định hơn, và ra số khác. Bản viết
tay dễ đọc hơn; bản thư viện đúng hơn về số học. Đây là một đánh đổi thật, không phải lỗi.