Xem bản video
Bản video 3:23. Bài viết dưới đây đi sâu hơn và có code chạy được. Cả 13 tập ở playlist, xếp sẵn theo thứ tự 1 → 13.
Hai mô hình, cùng một con số
2 000 tin đăng, 24 tin giả — lớp dương chiếm 1,20%.
Mô hình thứ nhất: hồi quy logistic trên hai đặc trưng. Độ chính xác 99,15%.
Mô hình thứ hai: luôn trả lời "tin thật". Không tham số nào, không huấn luyện. Độ chính xác 98,80%.
Chênh nhau 0,35 điểm phần trăm. Nếu chỉ đo bằng độ chính xác thì đó là toàn bộ giá trị mà mô hình thêm vào. Và mô hình thứ hai bỏ sót cả 24 tin giả — tức recall bằng 0, tức nó vô dụng hoàn toàn cho việc nó được thuê làm.
Ma trận nhầm lẫn: đọc bốn ô trước, đọc metric sau
Mô hình thật ở ngưỡng 0,5:
| mô hình nói "giả" | mô hình nói "thật" | |
|---|---|---|
| thực tế giả | bắt đúng 11 | bỏ sót 13 |
| thực tế thật | báo động sai 4 | bỏ qua đúng 1 972 |
Độ chính xác = (11 + 1 972) / 2 000 = 99,15% — con số này bị ô 1 972 chi phối gần như hoàn toàn. Mọi metric ở dưới chỉ là bốn số này chia cho nhau.
Precision và recall là hai câu hỏi khác nhau
Precision = 11 / (11 + 4) = 0,733. Trong 15 tin tôi gắn cờ, 11 tin đúng là giả. Mẫu số là việc mô hình làm.
Recall = 11 / (11 + 13) = 0,458. Có 24 tin giả, tôi bắt được 11. Mẫu số là việc thực tế có.
Cùng một mô hình, cùng một ngưỡng: 73,3% và 45,8%. Hỏi khác nhau thì số khác nhau — nên phải nói rõ đang hỏi câu nào.
F1 là trung bình điều hoà của hai số, nên nó chỉ cao khi cả hai đều cao. Trung bình cộng thưởng cho hai cực: gắn cờ đúng một tin và tin đó là giả cho precision 1,00 nhưng recall 0,04 — trung bình cộng 0,52, F1 chỉ 0,08.
Bảng ngưỡng
| ngưỡng | gắn cờ | bắt đúng | precision | recall | F1 |
|---|---|---|---|---|---|
| 0,90 | 5 | 5/24 | 1,000 | 0,208 | 0,345 |
| 0,70 | 9 | 8/24 | 0,889 | 0,333 | 0,485 |
| 0,50 | 15 | 11/24 | 0,733 | 0,458 | 0,564 |
| 0,30 | 25 | 14/24 | 0,560 | 0,583 | 0,571 |
| 0,15 | 35 | 14/24 | 0,400 | 0,583 | 0,475 |
| 0,05 | 79 | 18/24 | 0,228 | 0,750 | 0,350 |
| 0,02 | 141 | 21/24 | 0,149 | 0,875 | 0,255 |
Ở ngưỡng 0,90 mỗi cờ gần như chắc chắn đúng, nhưng chỉ bắt được 5 trong 24. Ở ngưỡng 0,02 bắt được 21, đổi lại 120 tin thật bị gắn cờ oan.
F1 cao nhất ở ngưỡng 0,30 — nhưng F1 chỉ là một cách cân, không phải cách đúng.
ROC tô hồng, PR trung thực
| mô hình | đoán bừa | |
|---|---|---|
| AUC-ROC | 0,9707 | 0,5 |
| AUC-PR | 0,5959 | 0,0120 |
Cùng một mô hình. ROC nghe như xuất sắc, PR nghe như tệ. Cả hai đều đúng — chúng đo hai thứ khác nhau.
Lý do: trục ngang của ROC là tỉ lệ báo động sai, với mẫu số 1 976 tin thật. Thêm một trăm báo động sai chỉ dịch trục ngang 5% — đường ROC gần như không nhúc nhích. Còn precision có mẫu số là số cờ đã gắn, nên mỗi báo động sai ăn thẳng vào nó.
Và mỗi AUC có đường cơ sở riêng: đoán bừa cho AUC-ROC 0,5, nhưng cho AUC-PR đúng bằng tỉ lệ lớp dương, tức 0,0120. Mô hình cao gấp 49,7 lần cơ sở của chính nó — vẫn còn xa 1,0.
average_precision_score chính là AUC-PR. Nó không có trong classification_report, và
cũng không phải mặc định của scoring= ở đâu cả. Muốn con số trung thực thì phải tự gọi nó.
Ngưỡng theo cái giá của lỗi
Hai cái giá dưới đây là giả định — sàn tự đặt. Nhưng ngưỡng mà chúng suy ra thì được tính:
| giả định | ngưỡng tốt nhất | gắn cờ | recall |
|---|---|---|---|
| bỏ sót đắt gấp 40 lần | 0,025 | 123 | 0,875 |
| bỏ sót đắt gấp 2 lần | 0,448 | 19 | 0,542 |
Cùng mô hình, cùng dữ liệu. Chỉ đổi giả định về giá là ngưỡng tốt nhất đổi theo. Ngưỡng 0,5 không phải một lựa chọn — nó là chỗ mặc định khi chưa ai hỏi lỗi nào đắt hơn.
Ba cách xử lý lệch lớp
| cách làm | gắn cờ | precision | recall | F1 |
|---|---|---|---|---|
| giữ nguyên, ngưỡng 0,5 | 15 | 0,733 | 0,458 | 0,564 |
| trọng số lớp ×82 | 155 | 0,135 | 0,875 | 0,235 |
| lấy mẫu lại 50/50 | 155 | 0,135 | 0,875 | 0,235 |
| dịch ngưỡng về 0,035 | 97 | 0,196 | 0,792 | 0,314 |
Cả ba đổi cùng một thứ: precision lấy recall. Không cách nào tạo ra thông tin mới — chúng chỉ dịch cùng một mô hình dọc theo cùng một đường đánh đổi.
Trọng số ×82 và lấy mẫu lại 50/50 cho đúng cùng con số, và đó không phải trùng hợp: với hồi quy logistic, nhân bản một dòng lên N lần và nhân gradient của nó với N là cùng một phép tính.
Cái bẫy: cân bằng tập đo
| tập kiểm tra | precision |
|---|---|
| 24 giả · 24 thật (cân bằng nhân tạo) | 1,000 |
| 24 giả · 1 976 thật (tỉ lệ thật) | 0,733 |
Mô hình không giỏi hơn chút nào — không huấn luyện lại gì cả. Chỉ là cái bể để rút ra báo động sai bị thu nhỏ 82 lần.
Cân bằng tập huấn luyện. Không bao giờ cân bằng tập đo.
Chạy thử
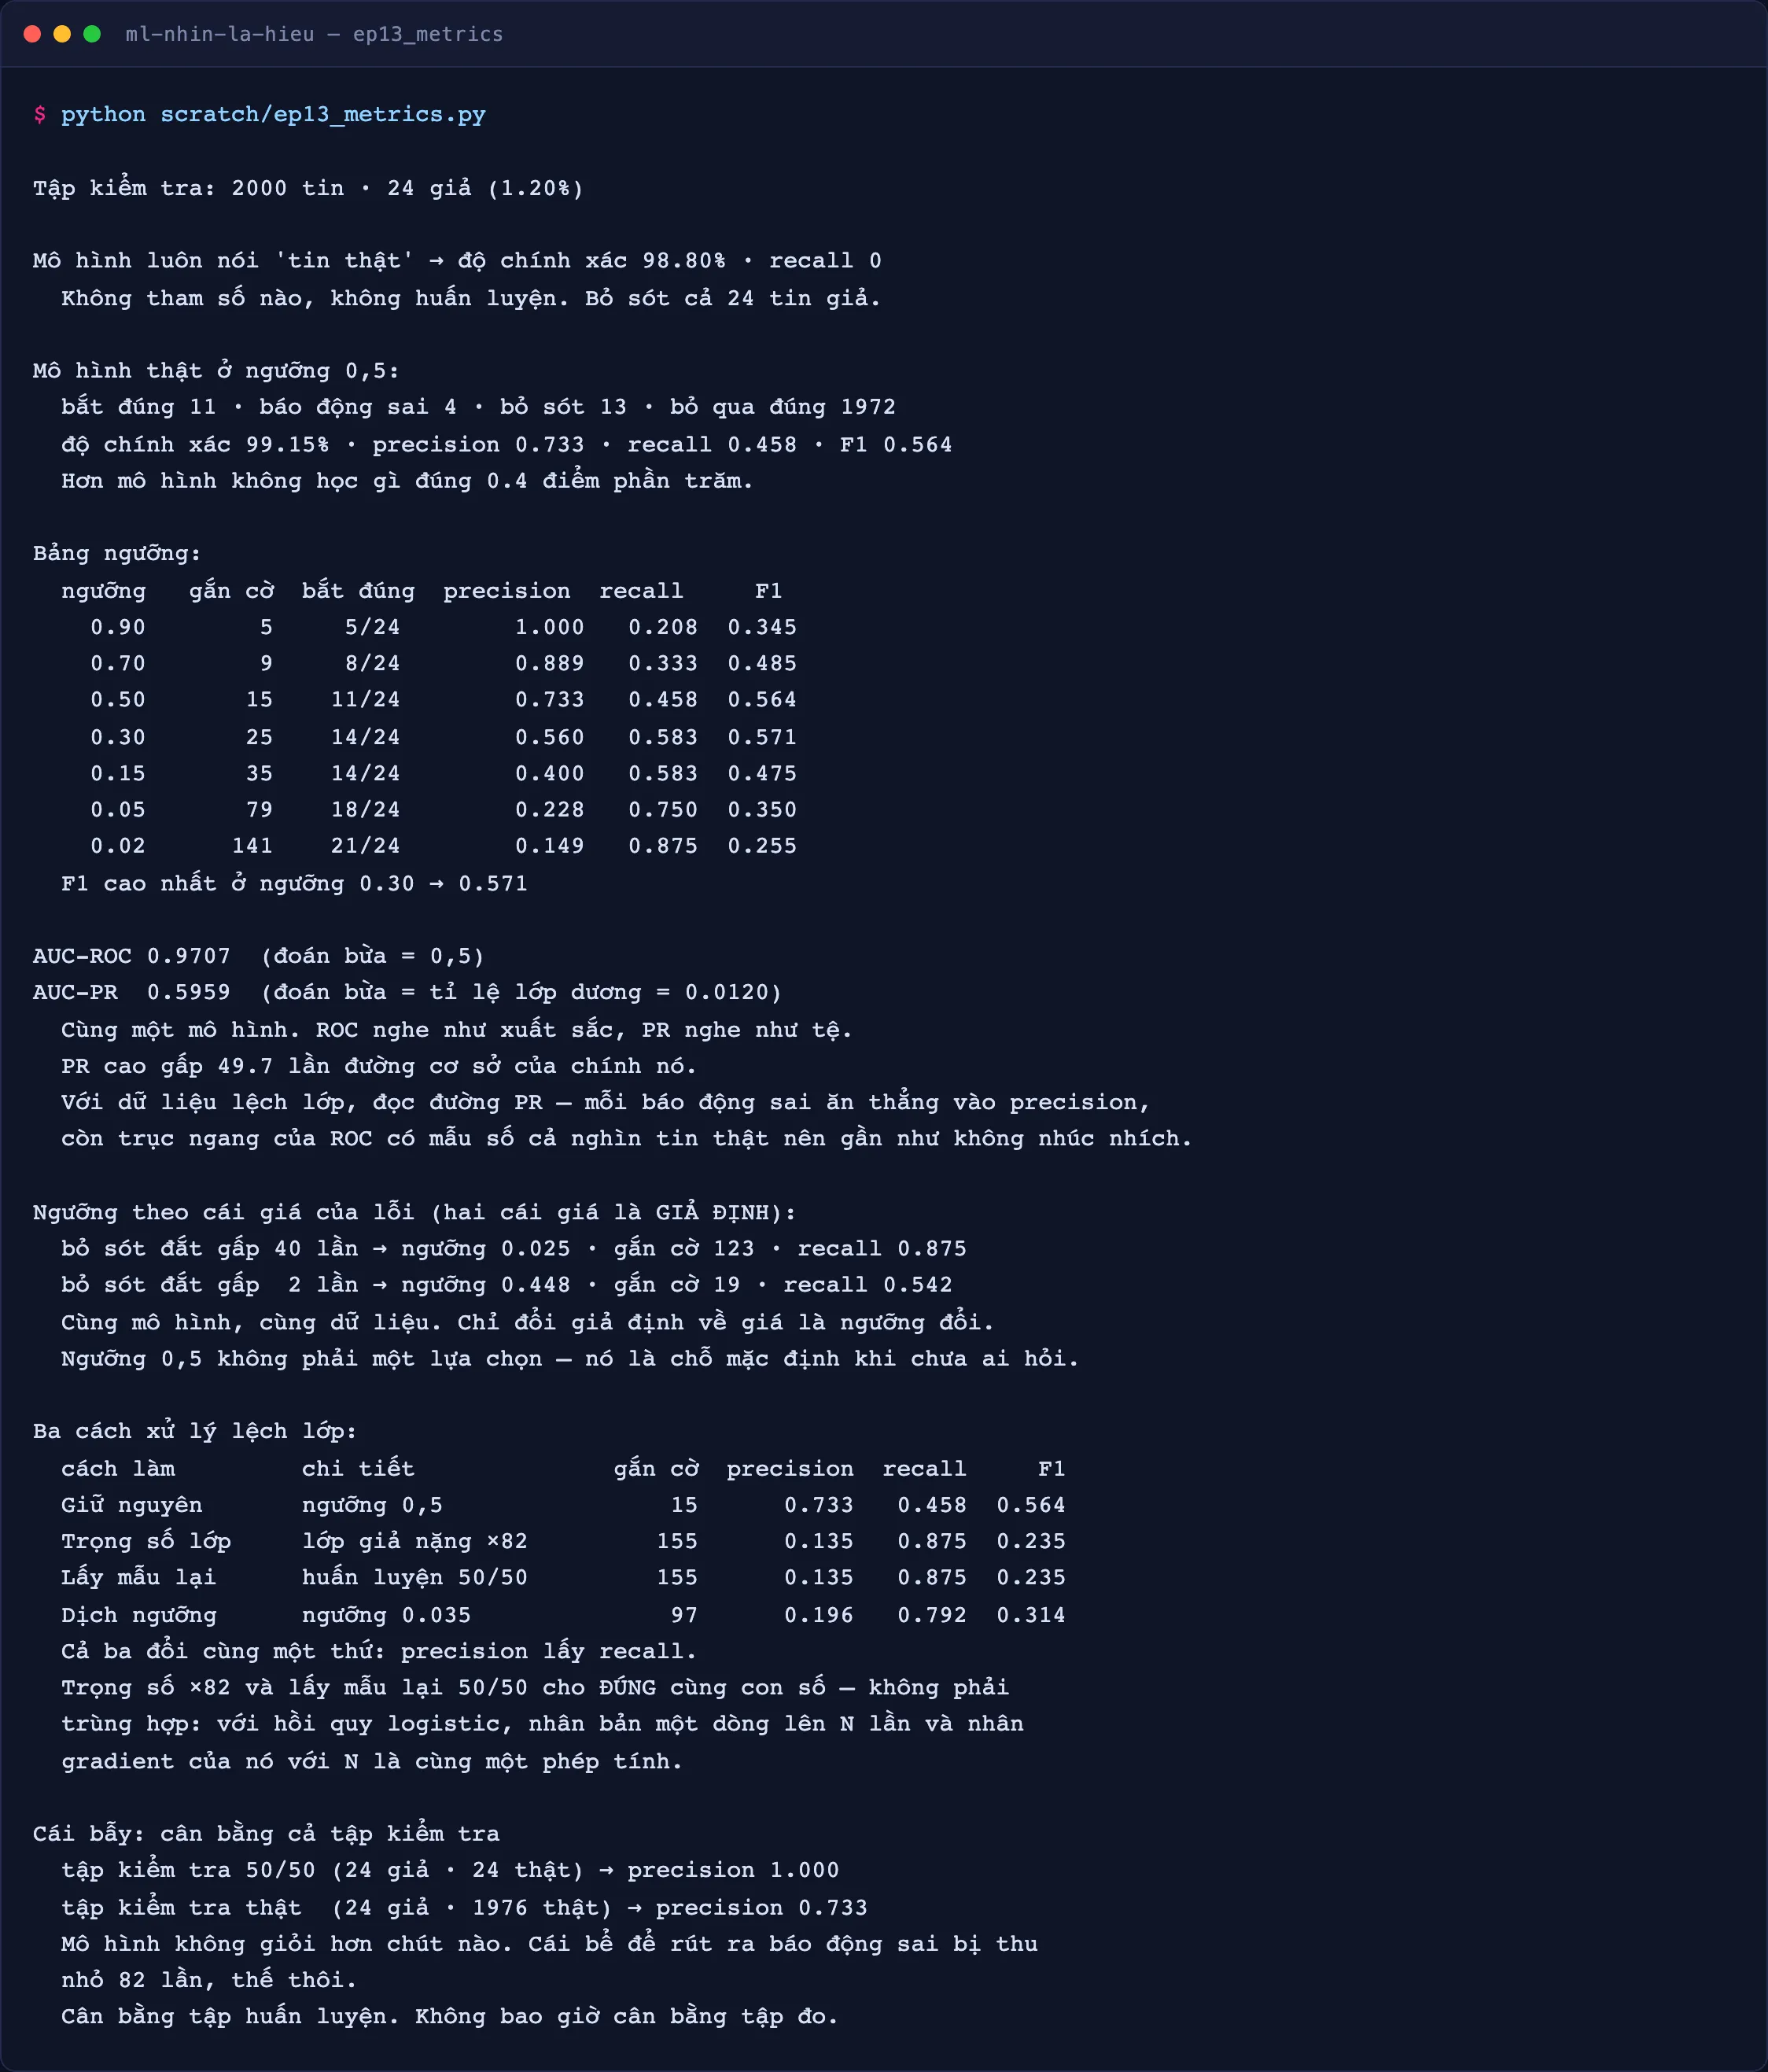
Ảnh trên là output thật của
python scratch/ep13_metrics.py, không phải bảng vẽ lại. Code:scratch/ep13_metrics.py·library/ep13_metrics.py
Một ghi chú về khả năng tái tạo
fit_logistic trong repo mặc định chạy 4000 bước — đúng như bản dựng video — và ở mức đó
gradient descent chưa hội tụ. Chạy 20 000 bước thì ma trận về 13 / 5 / 11 / 1 971, đúng
nghiệm mà lbfgs của sklearn tìm ra.
| acc | precision | recall | AUC-ROC | AUC-PR | |
|---|---|---|---|---|---|
| 4000 bước | 99,15% | 0,733 | 0,458 | 0,9707 | 0,5959 |
| hội tụ | 99,20% | 0,722 | 0,542 | 0,9724 | 0,6040 |
Mọi kết luận của bài giữ nguyên ở cả hai: độ chính xác vẫn ~99% so với 98,80%, precision vẫn
giảm đơn điệu khi hạ ngưỡng, ROC vẫn tô hồng so với PR. Chạy
python scratch/ep13_metrics.py --converged để xem cả hai.
Ghi lại chuyện này vì nó chính là lý do repo tồn tại: một con số có thể đúng, tái tạo được, và vẫn là hệ quả của một lựa chọn cài đặt mà không ai nói ra.
Kết series
Mười ba bài, từ bản đồ thuật toán tới cách đo cho đúng. Nếu chỉ mang được một câu đi, thì là câu này: không có metric tốt nhất, chỉ có metric khớp với cái giá bạn thật sự phải trả — và chọn nó trước khi huấn luyện, không phải sau khi đã xem kết quả.