Xem bản video
Bản video 2:47. Bài viết dưới đây đi sâu hơn và có code chạy được. Cả 13 tập ở playlist, xếp sẵn theo thứ tự 1 → 13.
Vòng lặp chỉ có hai bước
K-means (thuật toán Lloyd) làm đúng hai việc, lặp lại tới khi tâm không nhúc nhích:
- Gán: mỗi điểm về tâm gần nhất
- Cập nhật: mỗi tâm về trung bình các điểm của nó
Cả hai bước đều làm inertia — tổng bình phương khoảng cách tới tâm — giảm hoặc giữ nguyên. Nên nó chắc chắn hội tụ. Nhưng hội tụ về đâu thì là chuyện khác.
Khởi tạo quyết định kết quả
Ba đám tách bạch, k = 3. Cùng dữ liệu, cùng thuật toán, khác chỗ bắt đầu:
| khởi tạo | số vòng | inertia |
|---|---|---|
| k-means++ | 2 | 0,3036 |
| chọn bừa (hai tâm trong cùng một đám) | 5 | 2,6190 |
Chênh +763%. K-means hội tụ về nghiệm địa phương, không phải nghiệm tốt nhất.
Chú ý: KMeans của sklearn mặc định n_init=10 — chạy lại mười lần rồi lấy lần tốt
nhất. Đó là lý do bạn khó thấy nghiệm địa phương khi dùng thư viện: nó đã che giúp bạn.
Đặt n_init=1 là thấy ngay.
Chọn k: elbow và silhouette
Inertia luôn giảm khi k tăng (k = số điểm thì inertia = 0), nên không thể chọn k bằng cách tối thiểu hoá nó. Elbow tìm chỗ inertia thôi giảm nhanh:
| k | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|---|---|
| inertia | 5,71 | 3,12 | 0,30 | 0,26 | 0,19 | 0,16 | 0,11 |
Từ k = 2 sang 3 giảm 2,82; từ 3 sang 4 chỉ giảm 0,04. Khuỷu tay ở k = 3.
Silhouette đo mỗi điểm hợp với cụm của nó hơn cụm gần nhất bao nhiêu — và quan trọng là nó không cần nhãn thật:
| k | 2 | 3 | 4 | 5 |
|---|---|---|---|---|
| silhouette | 0,518 | 0,809 | 0,629 | 0,559 |
Nhiễu thuần vẫn ra ba cụm
Đây là điểm chính của bài. Đưa 48 điểm nhiễu đều — không có cấu trúc cụm nào — cho K-means với k = 3:
Nó trả về ba cụm gọn gàng. Thuật toán không có cách nào nói "dữ liệu này không có cụm". Chỉ silhouette mới cho thấy: 0,395 trên nhiễu, so với 0,809 trên cụm thật.
Nếu bạn chỉ nhìn hình và inertia, bạn sẽ tin vào ba cụm không tồn tại.
Kích thước lệch: kiểu hỏng kinh điển
Một cụm to lỏng 44 điểm, cạnh hai cụm nhỏ chặt 7 điểm mỗi cụm. Với k = 3, K-means làm gì?
- 44 điểm của cụm to rơi vào hai cụm cỡ 26 và 18 — bị xé làm đôi
- 14 điểm của hai cụm nhỏ rơi vào một cụm cỡ 14 — bị gộp lại
Tối thiểu hoá inertia thích như vậy, vì cụm to đóng góp nhiều bình phương khoảng cách hơn hẳn nên xé nó ra lợi hơn. Thuật toán làm đúng việc nó được giao; chỉ là việc đó không phải điều bạn muốn.
Một lưu ý khi tự kiểm: đừng phân loại cụm theo kích thước. Cụm gộp 14 điểm trông y hệt một mảnh của cụm to bị xé. Phải đối chiếu theo nguồn gốc của từng điểm.
Chạy thử
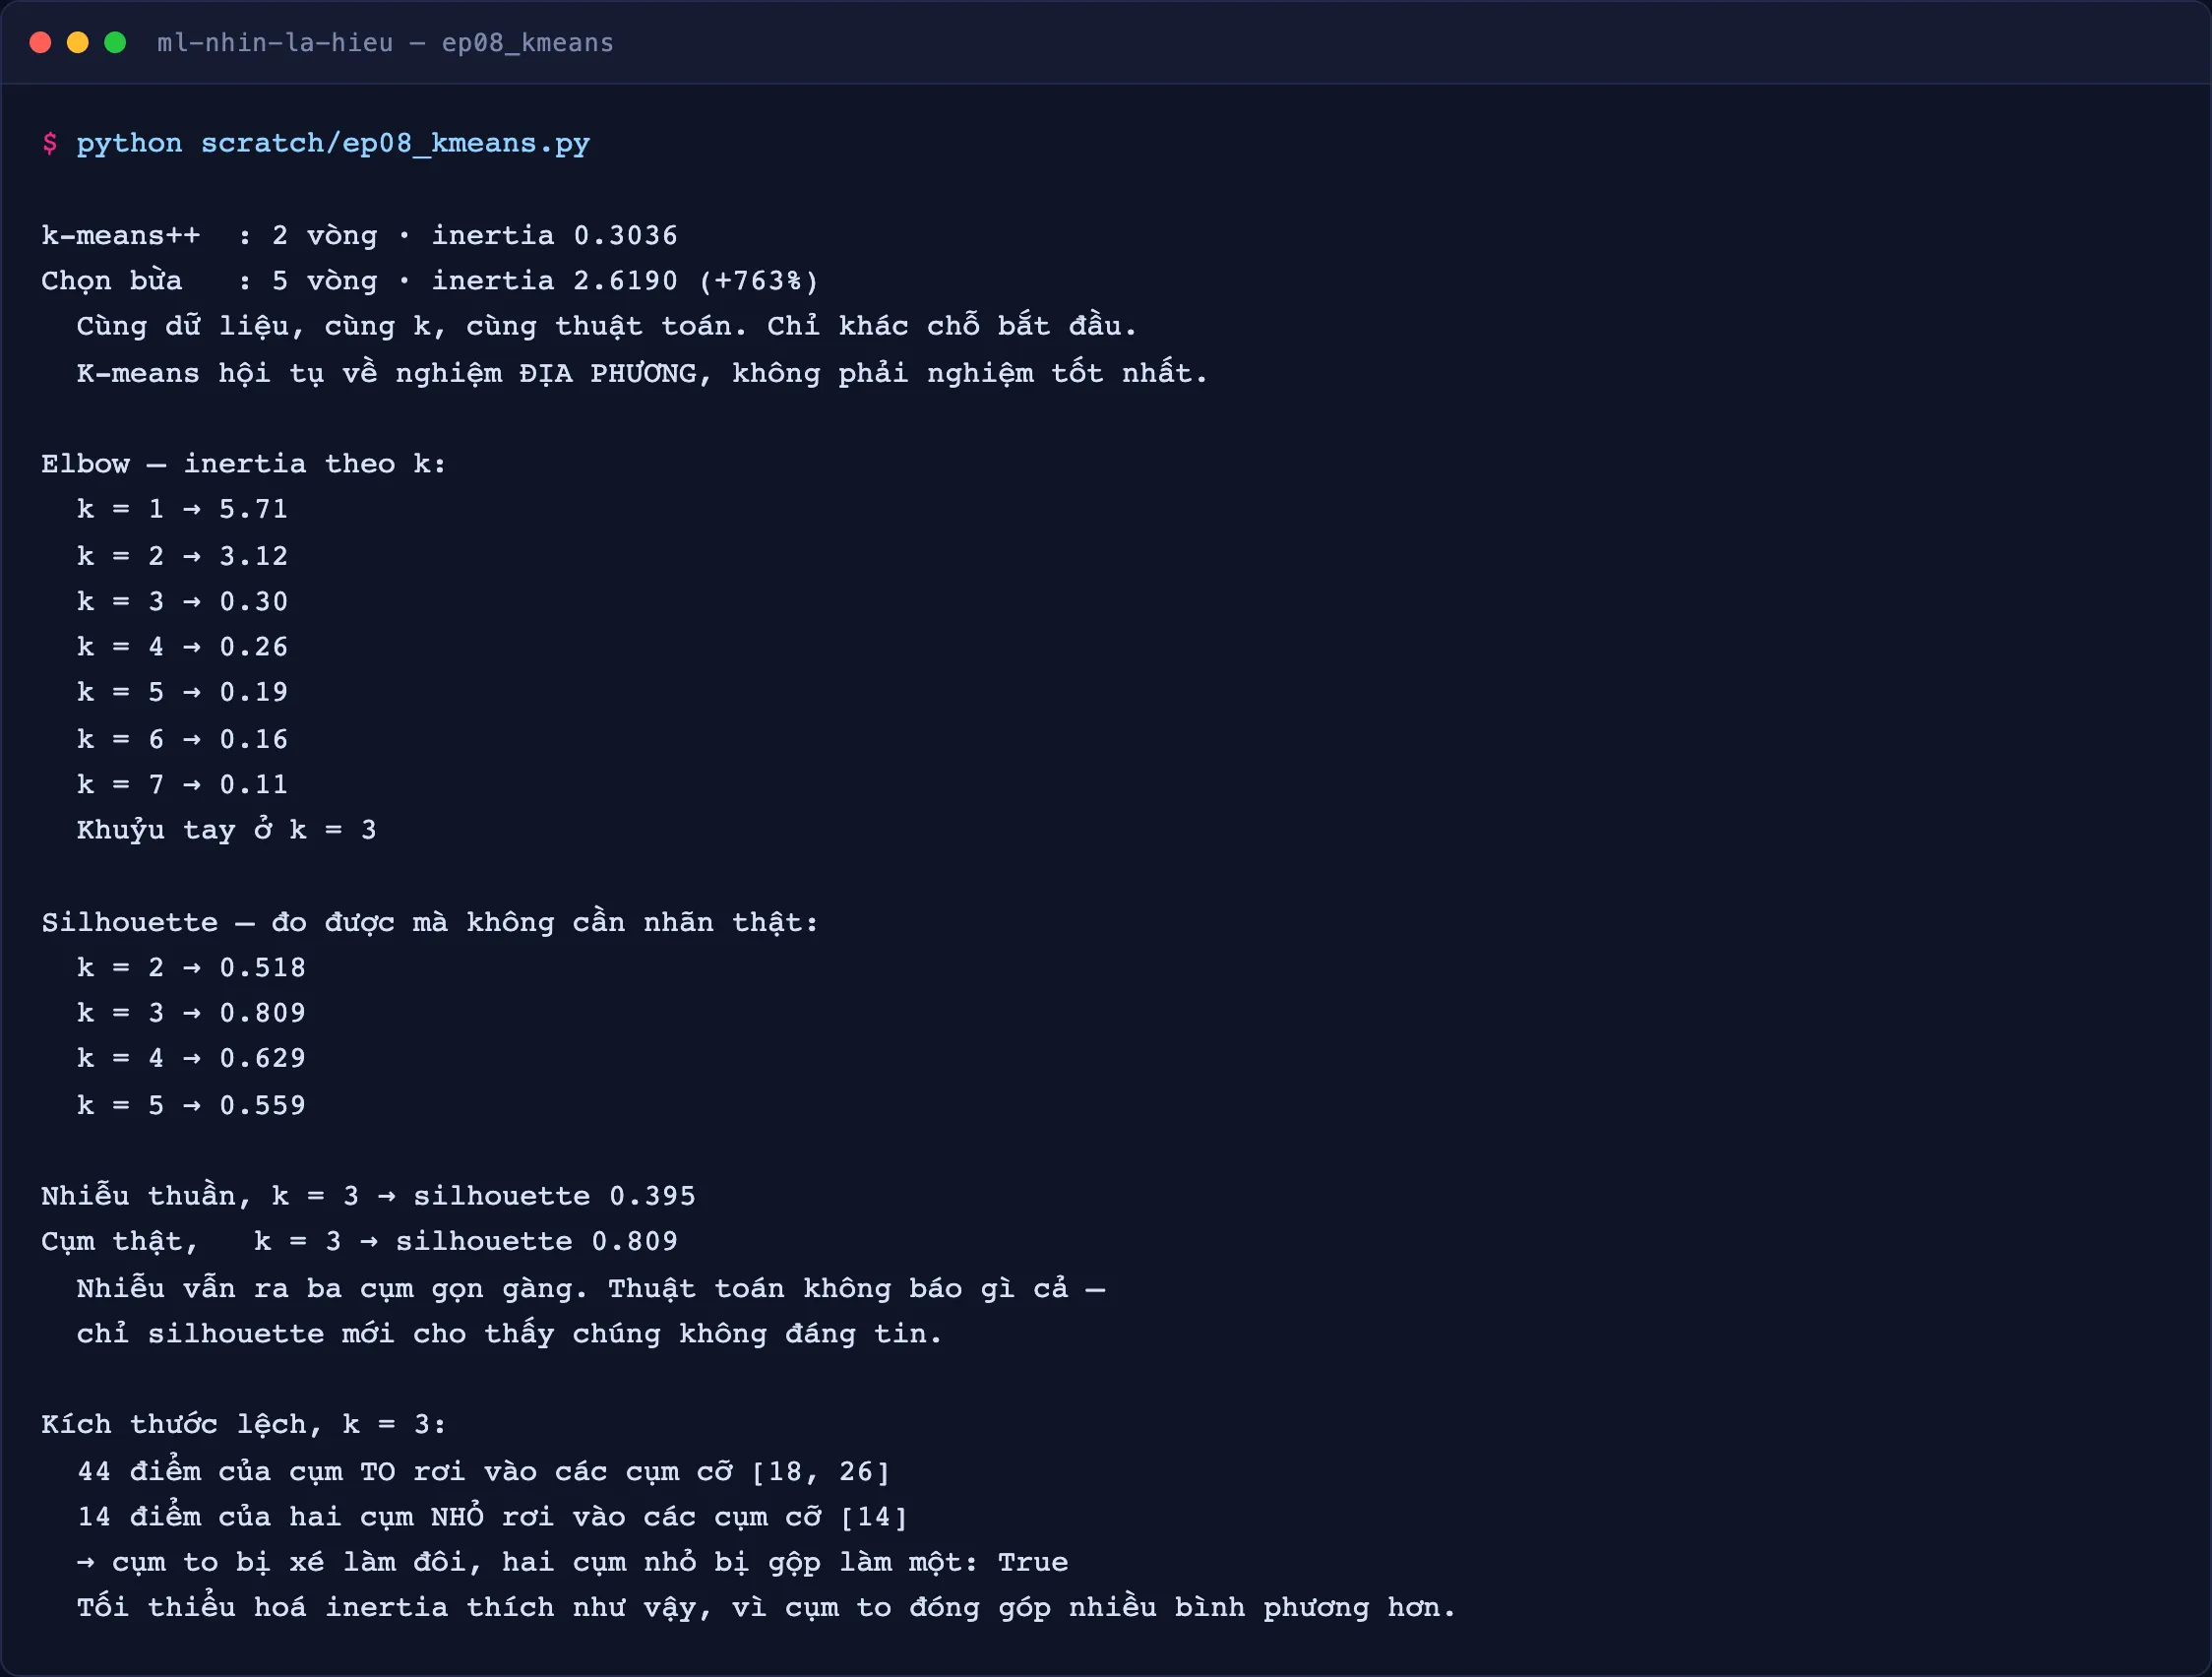
Ảnh trên là output thật của
python scratch/ep08_kmeans.py, không phải bảng vẽ lại. Code:scratch/ep08_kmeans.py·library/ep08_kmeans.py
Hình dạng K-means không tả được
Vì mỗi cụm được định nghĩa bởi một tâm và khoảng cách Euclid, cụm của K-means luôn là khối lồi quanh tâm. Hai vòng cung lồng nhau thì nó cắt sai hoàn toàn — đó là lúc cần DBSCAN hoặc spectral clustering.