Xem bản video
Bản video 2:46. Bài viết dưới đây đi sâu hơn và có code chạy được. Cả 13 tập ở playlist, xếp sẵn theo thứ tự 1 → 13.
Bài toán không đường thẳng nào chia được
Bốn nhóm điểm xếp chéo: hai nhóm ở góc (−,−) và (+,+) là một lớp, hai nhóm ở (−,+) và (+,−) là lớp kia. Đây là XOR trong hai chiều.
Câu hỏi quan trọng: đường thẳng tốt nhất đạt bao nhiêu? Không phải "đường thẳng tôi thử được đạt bao nhiêu" — mà tốt nhất trong mọi đường thẳng.
Cách trả lời: quét hết. Mọi góc từ 0 tới 180°, mọi vị trí từ −1,4 tới 1,4:
def best_line_accuracy(rows):
    best = 0.0
    for a in range(0, 180, 3):
        theta = a * math.pi / 180
        c = -1.4
        while c <= 1.4:
            acc = sum(1 for x, y, label in rows
                      if (1 if x*math.cos(theta) + y*math.sin(theta) > c else 0) == label) / len(rows)
            best = max(best, acc, 1 - acc)
            c += 0.05
    return best
Kết quả: 75%. Đây là mức trần, không phải mức chưa cố.
Sự khác biệt giữa hai cách nói này rất lớn. Nói "mạng tuyến tính chỉ đạt 50%" thì người nghe có quyền nghi là huấn luyện chưa tới. Nói "không đường thẳng nào vượt 75%" là một tính chất của bài toán.
Phi tuyến là thứ duy nhất tạo khác biệt
Cùng mạng 2-8-1, cùng số tham số, cùng 4000 vòng. Chỉ đổi hàm kích hoạt:
| log loss | đúng | |
|---|---|---|
có tanh | 0,0040 | 100% |
bỏ tanh (đồng nhất) | 0,6927 | 50% |
tanh, chỉ 1 nơ-ron ẩn | 0,5075 | 75% |
Bỏ tanh thì tám nơ-ron xếp tầng vẫn chỉ là một hàm tuyến tính — tổ hợp tuyến tính
của tổ hợp tuyến tính vẫn là tổ hợp tuyến tính. Ranh giới vẫn là đường thẳng, nên không
thể vượt trần 75%.
Một nơ-ron ẩn thì có phi tuyến, nhưng chỉ đủ một nếp gấp. XOR cần ít nhất hai.
Backprop không huyền bí
Đạo hàm của log loss theo z2 với đầu ra sigmoid đúng bằng (p − nhãn). Mọi thứ còn lại
chỉ là quy tắc dây chuyền lan ngược:
dz2 = (p - label) / n
for j in range(len(self.w2)):
    gw2[j] += dz2 * a1[j]
    da1 = dz2 * self.w2[j]
    dz1 = da1 if linear else da1 * (1 - a1[j] * a1[j])   # đạo hàm tanh
    gw1[j][0] += dz1 * x
    gw1[j][1] += dz1 * y
Ba dòng cho tầng ra, bốn dòng cho tầng ẩn. Đó là toàn bộ backprop cho mạng này.
Gradient thật ở bước đầu tiên, nơ-ron 1: ∂/∂w_x = −0,09835, ∂/∂w_y = −0,01570. Đây là
số thật, không phải số minh hoạ.
Học dần
| vòng | 0 | 60 | 200 | 700 | 4000 |
|---|---|---|---|---|---|
| đúng | 32% | 98% | 100% | 100% | 100% |
Ở vòng 0 nó đúng 32% — tệ hơn đoán bừa, vì trọng số khởi tạo ngẫu nhiên. Tới vòng 200 đã 100%. Ba nghìn tám trăm vòng còn lại chỉ để log loss nhỏ dần, không đổi kết luận nào.
Chạy thử
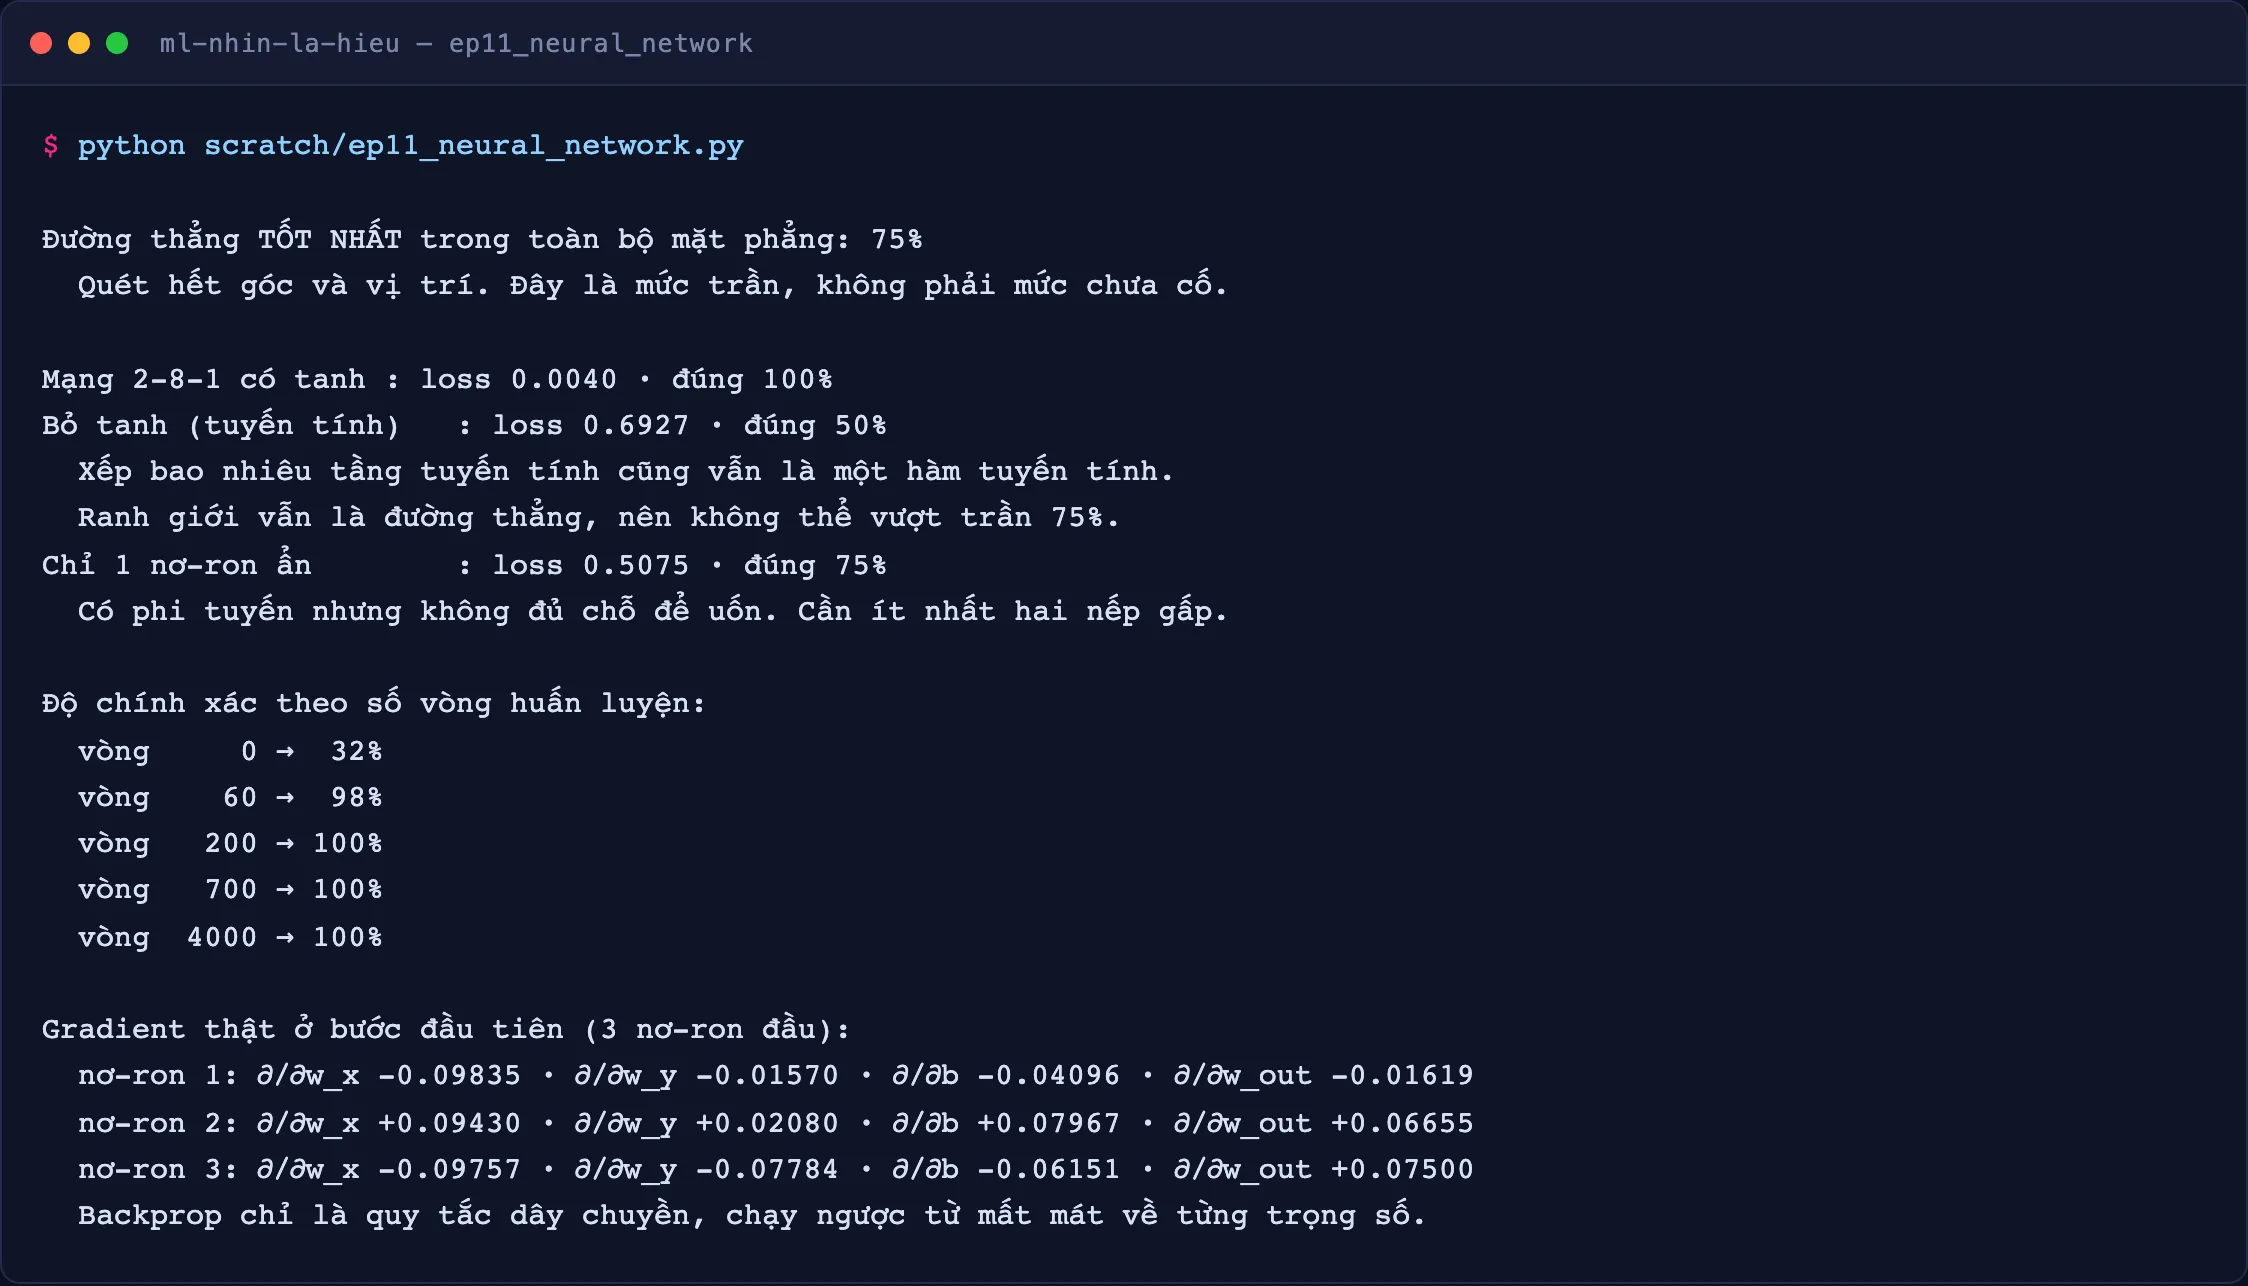
Ảnh trên là output thật của
python scratch/ep11_neural_network.py, không phải bảng vẽ lại. Code:scratch/ep11_neural_network.py·library/ep11_neural_network.py
Khi nào chưa cần mạng nơ-ron
Mạng nơ-ron cần nhiều dữ liệu hơn, nhiều thời gian hơn, nhiều tham số phải chỉnh hơn, và khó giải thích hơn mọi thứ ở bài 2 tới 10. Trên dữ liệu bảng, Gradient Boosting ở bài 10 thường thắng — và nó thắng bằng ít công sức hơn nhiều.
Mạng nơ-ron thắng khi dữ liệu có cấu trúc mà bạn không tự tay mô tả được: ảnh, âm thanh, văn bản. Bảng số liệu có 5 cột thì chưa tới mức đó.
So với sklearn
MLPClassifier(activation="identity") là cách một dòng để thấy điều bài này nói: cùng số
tham số, cùng số vòng, chỉ đổi hàm kích hoạt, và độ chính xác rơi từ 100% xuống 50%.
Lưu ý MLPClassifier mặc định có alpha=0.0001 (phạt L2) và dùng Adam thay vì gradient
descent thuần. Đường học khác nhau dù đích đến giống nhau.