Xem bản video
Bản video 2:51. Bài viết dưới đây đi sâu hơn và có code chạy được. Cả 13 tập ở playlist, xếp sẵn theo thứ tự 1 → 13.
Gini: đo độ lẫn của một nhóm
Cây quyết định đặt một chuỗi câu hỏi có/không. Câu hỏi tốt là câu chia nhóm thành hai phần thuần hơn — và "thuần" đo bằng Gini:
def gini(rows):
    p = sum(1 for r in rows if r.label == 1) / len(rows)
    return 1 - p * p - (1 - p) * (1 - p)
Gini bằng 0 nếu cả nhóm cùng nhãn, bằng 0,5 nếu lẫn đều. CART thử mọi ngưỡng giữa hai giá trị liền kề của mọi cột, rồi chọn cái làm Gini giảm nhiều nhất. Không có công thức kín — chỉ là thử hết.
Trên 200 căn hộ (140 huấn luyện, 60 kiểm tra, có 12% nhãn nhiễu), câu hỏi gốc mà nó
chọn là cách trung tâm ≤ 6,0 km, làm Gini giảm 0,157.
Độ sâu: chỗ học biến thành nhớ
| độ sâu | số lá | train | test |
|---|---|---|---|
| 1 | 2 | 81% | 82% |
| 2 | 4 | 82% | 68% |
| 3 | 8 | 89% | 85% |
| không giới hạn | 33 | 100% | 78% |
Cây không giới hạn đạt 100% trên dữ liệu huấn luyện. Đó không phải thành tích — trong 140 dòng train có 16 dòng nhãn nhiễu, và để đúng 100% thì nó buộc phải học thuộc cả 16 dòng nhiễu đó. Kết quả: rơi từ 85% xuống 78% trên dữ liệu chưa thấy.
Chú ý dòng độ sâu 2: test tệ hơn độ sâu 1. Đường cong này không đơn điệu, nên chọn độ sâu bằng cách "tăng dần tới khi tệ đi" là chọn sai.
Tỉa cây
Cắt sớm và buộc mỗi lá có ít nhất 3 mẫu: 8 lá, train 89%, test 85%. Bằng đúng cây sâu 3 nhưng bền hơn với dữ liệu mới.
Rừng: hai lớp ngẫu nhiên
Random Forest dựng nhiều cây trên nhiều tập bootstrap khác nhau, và ở từng lần chia lại bốc một tập con đặc trưng:
def pick_feature():
    return (FEATURES[int(rand() * len(FEATURES))],)

trees.append(grow(bag, 0, 99, 1, pick_feature))   # pick_feature gọi lại mỗi lần chia
Bốc một lần cho cả cây là một thuật toán khác và yếu hơn hẳn: các cây sẽ giống nhau, mà rừng chỉ có ích khi các cây sai theo những cách khác nhau.
Rừng 200 cây: train 99%, test 82%. Từng cây riêng trong rừng chỉ đạt trung bình 76% — yếu hơn hẳn một cây thường, vì mỗi cây chỉ thấy một phần dữ liệu và một phần đặc trưng. Trung bình lại thì đúng hơn từng cái.
Nhưng rừng không phải lúc nào cũng thắng
Cây tỉa gọn đạt 85%, rừng 200 cây đạt 82%. Trên bộ này, cây đơn thắng.
Lý do: hai cột và một quy tắc gần tuyến tính thì một cây sâu 3 đã mô tả đủ. Rừng có ích khi dữ liệu đủ phức tạp để một cây không mô tả nổi. Repo có một test khẳng định kết quả này, để nó khỏi bị "sửa cho đẹp" khi số liệu đổi.
Chạy thử
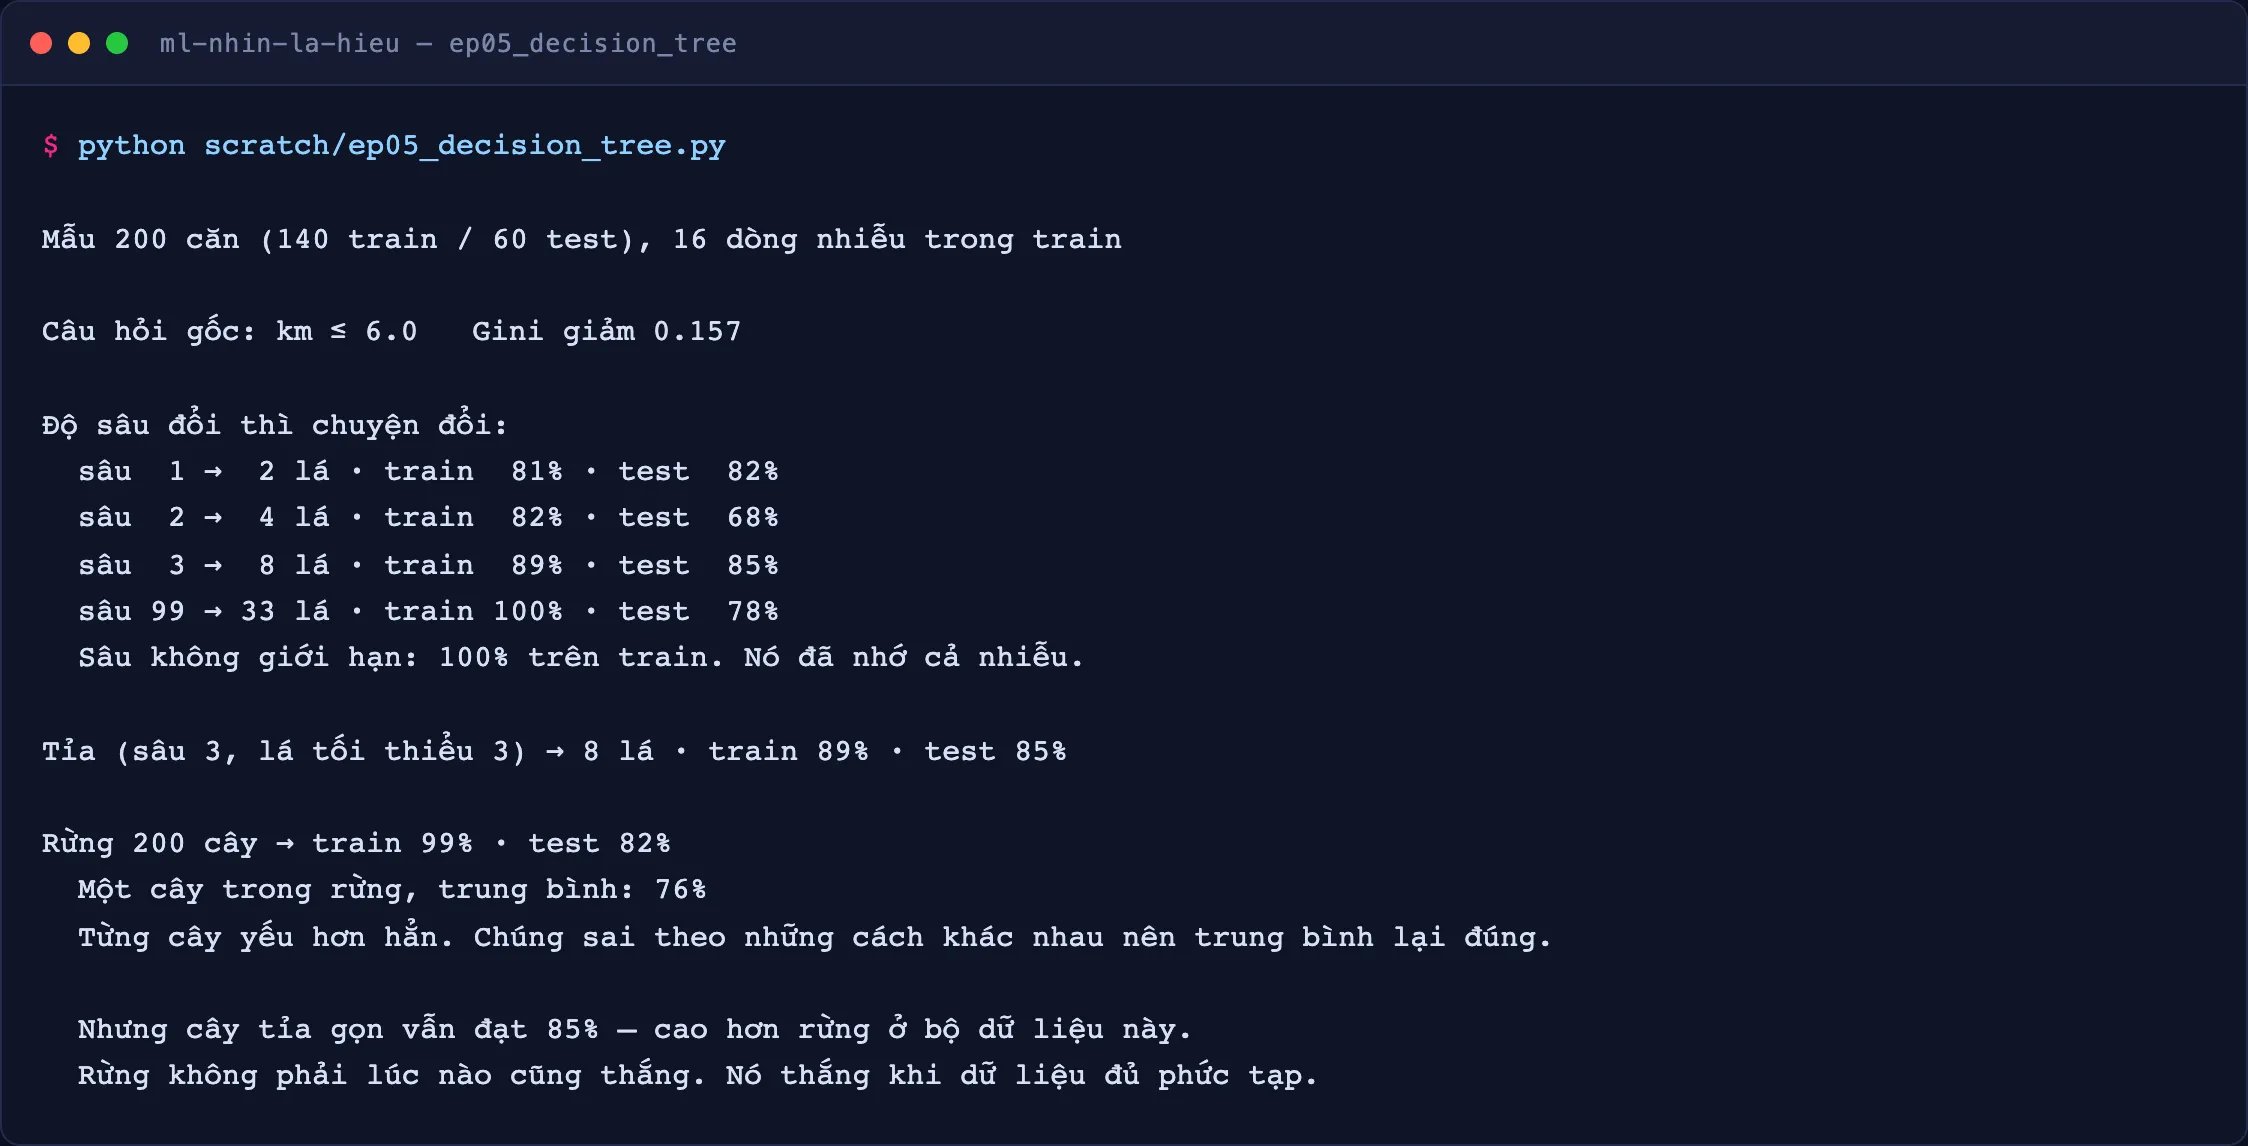
Ảnh trên là output thật của
python scratch/ep05_decision_tree.py, không phải bảng vẽ lại. Code:scratch/ep05_decision_tree.py·library/ep05_decision_tree.py
Một khác biệt khi so với sklearn
RandomForestClassifier bỏ phiếu bằng trung bình xác suất của từng cây, không phải
đếm phiếu đa số như bản viết tay. Kết quả gần nhau nhưng không đồng nhất — đọc tài liệu
trước khi so hai cài đặt với nhau.