Xem bản video
Bản video 2:44. Bài viết dưới đây đi sâu hơn và có code chạy được. Cả 13 tập ở playlist, xếp sẵn theo thứ tự 1 → 13.
Vô số đường cùng chia đúng
Mười bốn điểm, hai lớp tách sạch. Có vô số đường thẳng chia đúng cả mười bốn điểm. SVM chọn đường có lề rộng nhất — khoảng trống hai bên lớn nhất.
Với bộ này, lề rộng 0,320 và chỉ 3 trên 14 điểm nằm sát lề. Ba điểm đó gọi là support vector.
Đo xem "chỉ vài điểm quyết định" đúng tới mức nào
Câu đó dễ nói. Đo được thì mới tin. Cách đo: xoá từng điểm, khớp lại, xem ranh giới xoay bao nhiêu độ.
| xoá điểm nào | ranh giới xoay |
|---|---|
| một điểm bên trong | 0,060° |
| một support vector | 13,505° |
Gấp 224 lần. Trung bình cả nhóm thì 0,149° so với 10,142° — gấp 68 lần. Đọc kiểu nào cũng cùng một chuyện: mô hình chỉ nhớ phần biên, phần còn lại xoá đi cũng gần như không đổi gì.
Một bước dễ bỏ trong Pegasos
Pegasos là phương pháp dưới gradient, và nó dừng ở đâu thì w có độ lớn ở đó. Muốn báo
lề và số support vector cho có nghĩa thì phải chuẩn hoá về dạng chính tắc trước:
raw = [y * (w[0] * x1 + w[1] * x2 + b) for x1, x2, y in rows]
closest = min(raw)
if closest > 1e-9:
    w = [w[0] / closest, w[1] / closest]
    b /= closest
Chia cho lề nhỏ nhất để điểm gần nhất nằm đúng ở lề 1. Không có bước này thì bề rộng lề
báo ra là tạo tác của chỗ vòng lặp dừng, không phải tính chất của dữ liệu. Repo có
test khẳng định min(margins) == 1.
Lề mềm và tham số C
Khi hai lớp chồng lấn, không đường nào chia sạch được. Lề mềm cho phép vi phạm, và C quyết định vi phạm đắt bao nhiêu:
| C | lề | điểm vi phạm | support vector |
|---|---|---|---|
| 3 | 0,54 | 4 | 18 |
| 10 | 0,36 | 4 | 16 |
| 30 | 0,23 | 5 | 13 |
| 100 | 0,17 | 4 | 11 |
| 500 | 0,11 | 5 | 9 |
C nhỏ: lề rộng, chấp nhận nhiều vi phạm. C lớn: lề hẹp, cố ép đúng. Không có C đúng sẵn — nó là câu hỏi về việc bạn sợ loại lỗi nào hơn, và bài 13 nói về cách trả lời nó.
Kernel trick, ở dạng trần trụi nhất
Chín điểm trên một trục, lớp trong nằm giữa: không ngưỡng nào chia được. Nâng x thành
(x, x²) thì đường thẳng x² = 0,25 chia sạch — vì x² = 0,25 tương đương |x| = 0,5.
Kernel trick chỉ là: tính tích vô hướng ở chiều cao mà không dựng toạ độ ở đó. Với
SVC(kernel="poly", degree=2), sklearn không tạo cột x² nào cả — nó chỉ đổi cách tính
tích vô hướng, và đạt 100% trong khi kernel tuyến tính trên một chiều chỉ đạt 56%.
Chạy thử
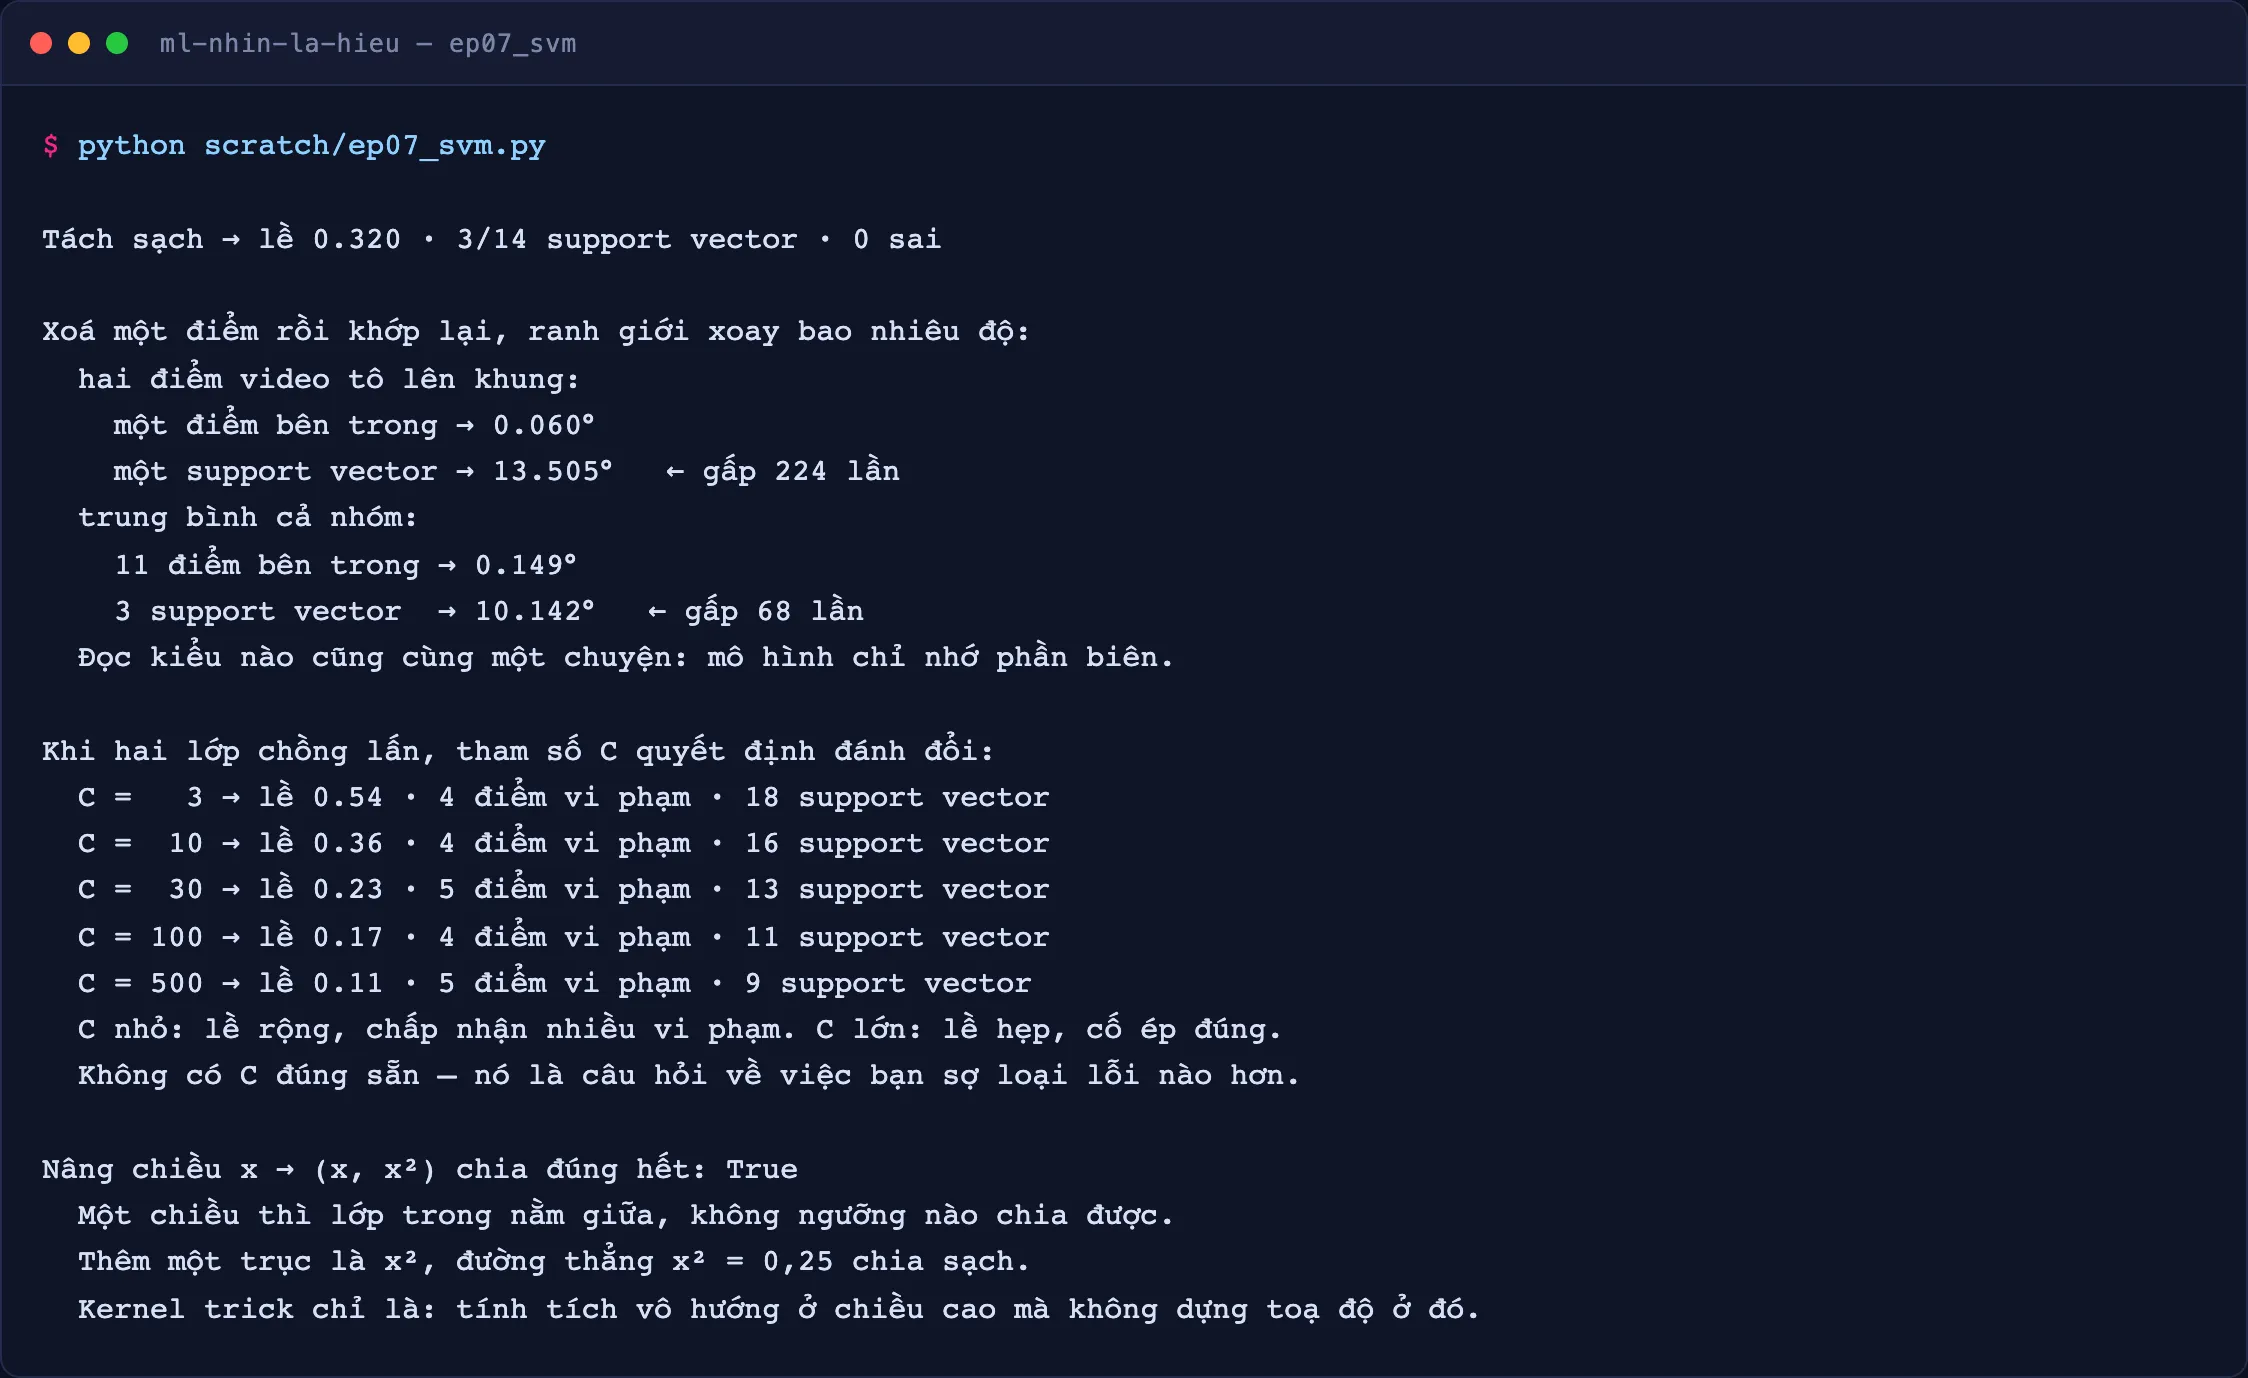
Ảnh trên là output thật của
python scratch/ep07_svm.py, không phải bảng vẽ lại. Code:scratch/ep07_svm.py·library/ep07_svm.py
So với sklearn
SVC(kernel="linear", C=1e6) giải bài toán đối ngẫu chính xác, còn Pegasos là dưới
gradient nên xấp xỉ. Hai bên cho cùng lề tới ba chữ số — đủ để tin bản viết tay đúng.