Xem bản video
Bản video 2:56. Bài viết dưới đây đi sâu hơn và có code chạy được. Cả 13 tập ở playlist, xếp sẵn theo thứ tự 1 → 13.
Đổi câu hỏi thì đổi cả cách đọc đường thẳng
Bài 2 hỏi "giá bao nhiêu". Bài này hỏi "bán nhanh hay bán chậm" — đầu ra không còn là một con số mà là một nhãn.
Thử dùng Linear Regression cho nhãn 0/1 xem sao. Khớp OLS lên mười sáu căn hộ với nhãn 0 và 1, rồi đọc giá trị ở hai đầu: ở 0 km nó cho +1,29, ở 9 km cho −0,18. Không phải xác suất. Xác suất không thể vượt 1 hay xuống dưới 0.
Đường thẳng vẫn dùng được — chỉ là cái ta đọc từ nó không còn là nhãn, mà là khoảng cách tới ranh giới. Rồi sigmoid biến khoảng cách đó thành xác suất.
Sigmoid, và một cái bẫy số học
def sigmoid(z):
    if z >= 0:
        return 1.0 / (1.0 + math.exp(-z))
    ez = math.exp(z)
    return ez / (1.0 + ez)
Viết thẳng 1 / (1 + exp(-z)) thì ngắn hơn, nhưng có hai lỗi. Với z rất âm thì
exp(-z) tràn số và Python ném OverflowError. Và trên giấy sigmoid không bao giờ
chạm 0 hay 1, nhưng trong float64 thì có: từ khoảng |z| > 37 nó trả về đúng 1.0,
khi đó log(1 - p) là log của 0 và nổ.
Dạng hai nhánh ở trên chỉ gọi exp với đối số âm nên không bao giờ tràn. Đây cũng là
lý do mọi thư viện thật đều kẹp xác suất về [eps, 1-eps] trước khi lấy log.
Ở tập dữ liệu này |z| lớn nhất chỉ 4,26 nên chưa chạm giới hạn — nhưng biết trước thì
đỡ mất một buổi debug.
Gradient descent trên log loss
Không có nghiệm đóng như bài 2, nên phải đi tìm. Điều bất ngờ là gradient của log loss hoá ra rất gọn: chỉ là sai số nhân với đặc trưng.
for _ in range(steps):
    dw = db = 0.0
    for x, y in rows:
        err = sigmoid(w * x + b) - y      # đúng bằng gradient theo z
        dw += err * x
        db += err
    w -= lr * dw / n
    b -= lr * db / n
Đạo hàm của sigmoid tự triệt tiêu với đạo hàm của log — nên không có chỗ nào phải nhớ
công thức. Sau 20 000 bước: w = −1,1312, b = 5,4646.
Ranh giới là chỗ xác suất bằng 0,5, tức z = 0, tức x = −b/w = 4,83 km. Log loss
cuối cùng: 0,3827.
Ngưỡng là quyết định của người
Mô hình cho ra xác suất. Biến xác suất thành quyết định cần một ngưỡng, và ngưỡng không nằm trong mô hình:
| ngưỡng | gọi là "nhanh" | đúng | gọi oan |
|---|---|---|---|
| 0,5 | 8 căn | 6/8 | 2 |
| 0,3 | 10 căn | 7/8 | 3 |
Hạ ngưỡng thì bắt được nhiều hơn và cũng gọi oan nhiều hơn. Không có ngưỡng đúng sẵn — bài 13 chỉ ra cách chọn nó theo cái giá của từng loại lỗi.
Chạy thử
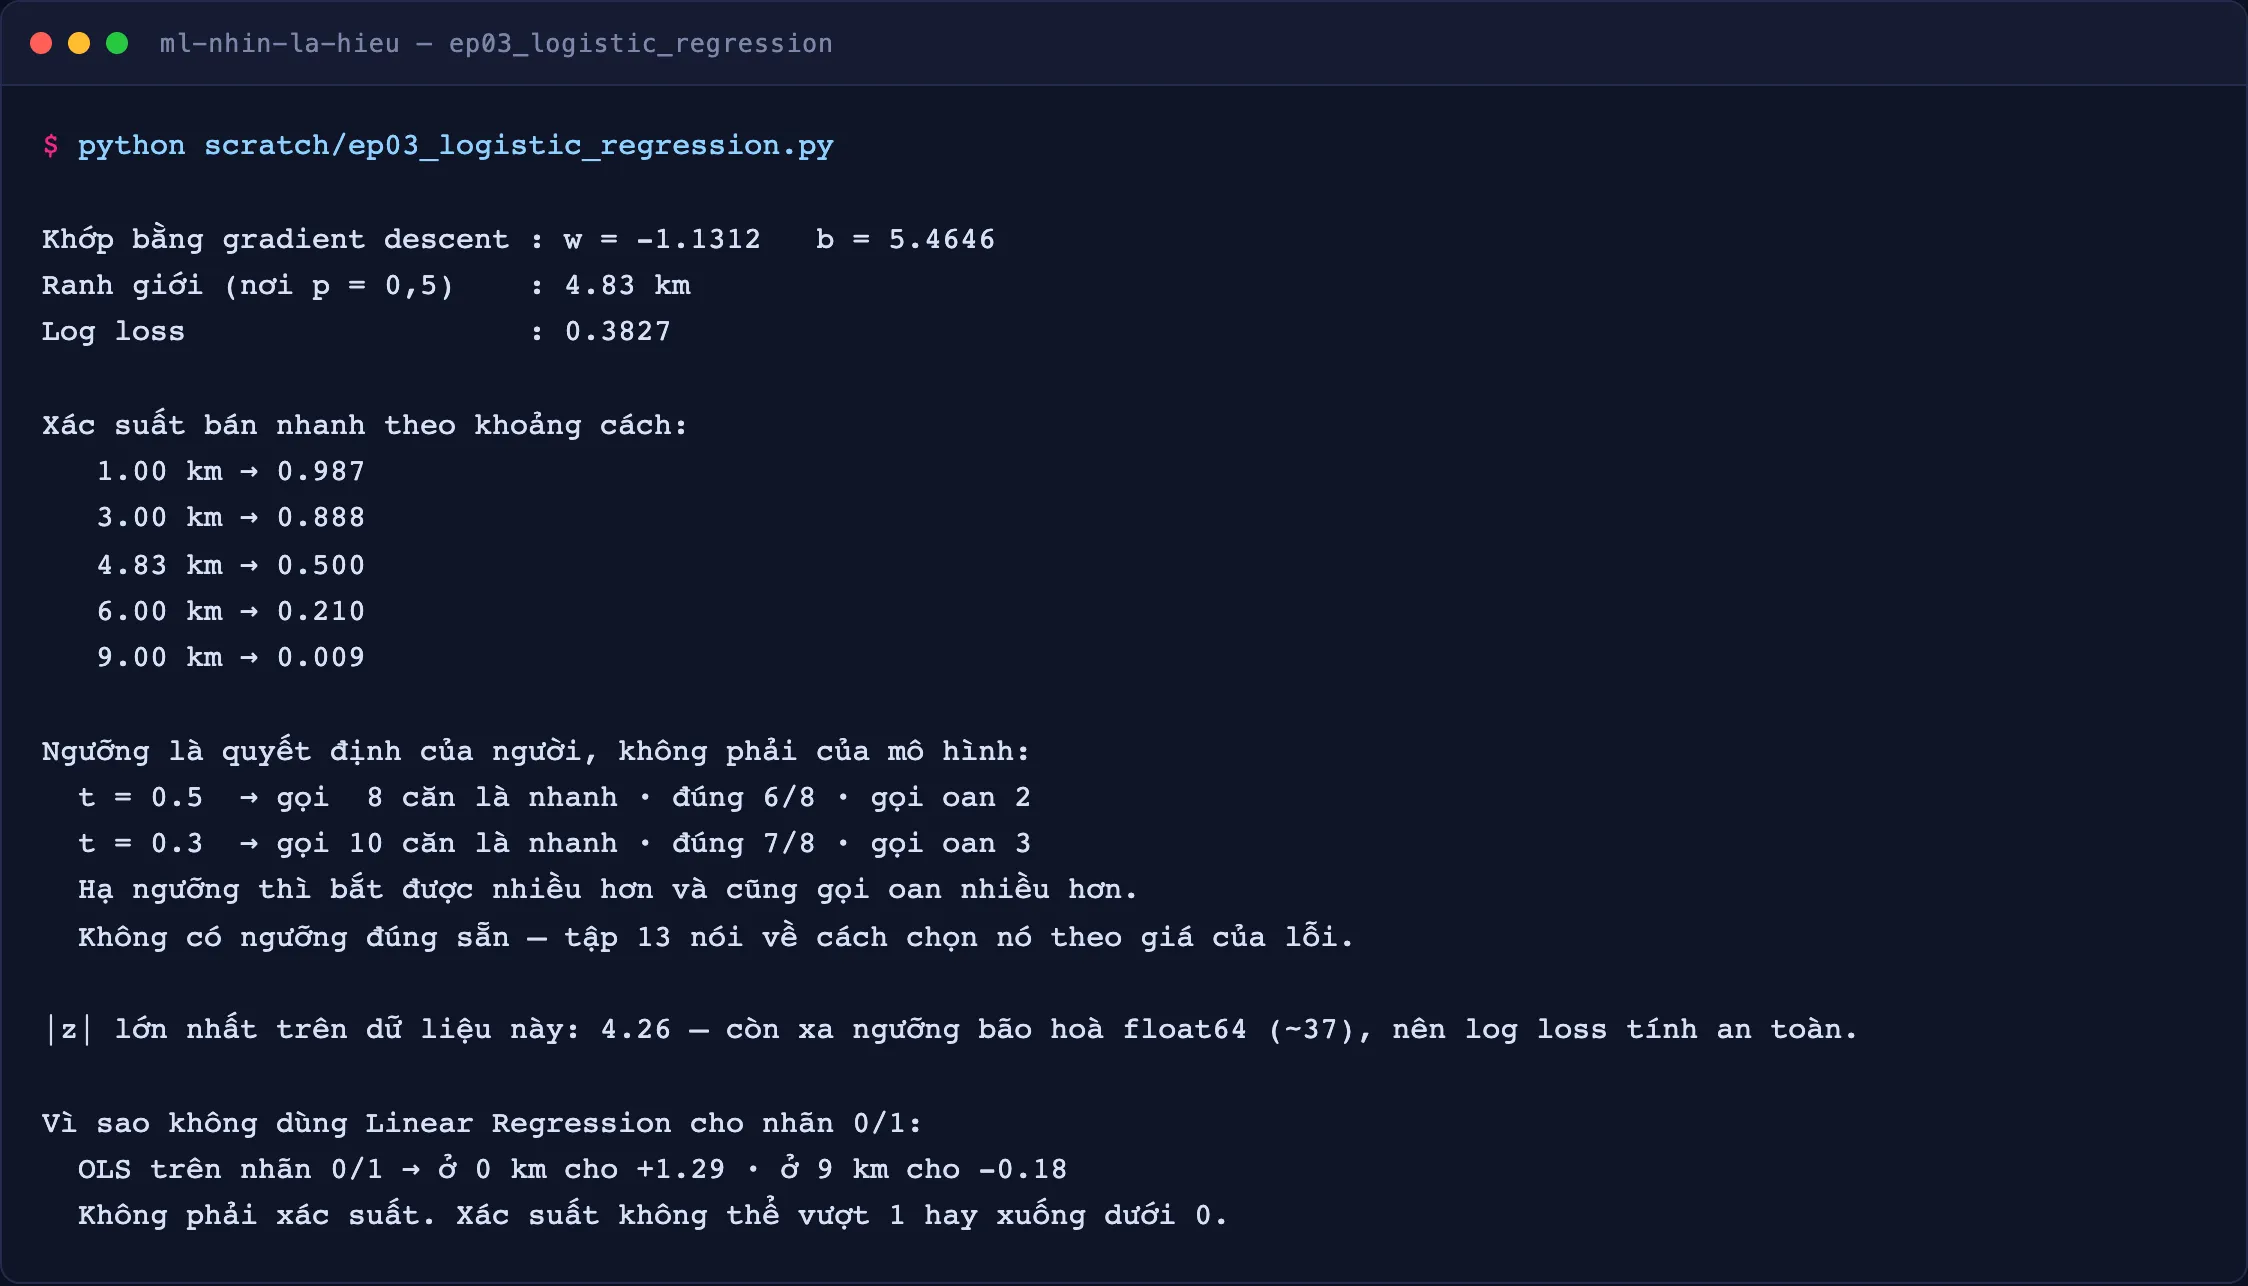
Ảnh trên là output thật của
python scratch/ep03_logistic_regression.py, không phải bảng vẽ lại. Code:scratch/ep03_logistic_regression.py·library/ep03_logistic_regression.py
Một mặc định của thư viện đáng biết
LogisticRegression(penalty=None)     # ra đúng w = -1,1313, b = 5,4653
LogisticRegression()                 # ra w = -0,9155, b = 4,4279
LogisticRegression của sklearn mặc định có phạt L2 (C=1.0). Bản viết tay không
phạt gì, nên muốn hai bên ra cùng nghiệm thì phải penalty=None.
Không phải tiểu tiết. Đây là ví dụ sống của điều bài 12 nói: mặc định của thư viện là một lựa chọn mô hình hoá, và không ai hỏi bạn trước khi áp dụng nó.