Xem bản video
Bài viết dưới đây đi sâu hơn bản video và có code chạy được.
Hai con số không mâu thuẫn nhau
Dựng một mô hình không học gì: nó trả lời O cho mọi token, không bao giờ đánh dấu thực
thể nào. Đo trên 300 câu kiểm:
| Độ chính xác | 93,16% |
| Số thực thể lấy ra được | 0 |
| Token F1 | 0.00 |
| Span F1 | 0.00 |
Tập kiểm có 522 thực thể thật. Mô hình lấy ra 0. Và nó vẫn thắng ở cột đầu tiên.
Vì sao: mẫu số là thứ ta không cần
Trong corpus, chỉ 6,75% token là thực thể. 93,25% còn lại
là chữ nền, và trả lời O cho chữ nền thì luôn đúng.
Độ chính xác lấy mẫu số là mọi token. Nên nó bị chi phối gần như hoàn toàn bởi đúng phần ta không quan tâm. Nó không tính sai — nó trả lời một câu hỏi khác câu ta hỏi.
Trích xuất không phải phân loại
Phân loại có một câu hỏi và một đáp án. Trích xuất thì:
- số đáp án tuỳ từng câu — có câu không có thực thể nào, có câu có bốn;
- mỗi đáp án là một đoạn, phải đúng cả loại lẫn hai đầu biên.
Đầu ra không phải một nhãn cho cả câu, mà là một danh sách đoạn kèm vị trí.
Token là âm tiết, và điều đó quan trọng
Tách theo khoảng trắng thì Nguyễn Văn An là ba token nhưng chỉ một cái tên.
Đoán đúng hai trong ba âm tiết: token đúng 2/3, nghe như gần đúng. Còn cái tên thì sai hẳn — không có nửa cái tên. Tiếng Việt làm chuyện này gắt hơn tiếng Anh, nơi một tên riêng thường là một token.
Nhãn BIO
Cách gán nhãn phổ biến nhất:
B-X— âm tiết mở đầu một thực thể loại XI-X— âm tiết nằm trong thực thể đóO— mọi thứ còn lại
Một chi tiết đáng nhớ: nhãn của một token phụ thuộc vào cái nó đang nằm trong. Trong
corpus này, token Trang là I-LOC khi nằm trong Nha Trang, và là I-PER khi nằm trong
Ngô Ngọc Trang — cùng một chữ, hai nhãn khác nhau, trong cùng một câu.
Bốn độ đo, bốn câu hỏi
| Độ đo | Câu hỏi nó trả lời | Dùng khi nào |
|---|---|---|
| Accuracy | Bao nhiêu token đúng nhãn? | Gần như không bao giờ, ở bài toán này |
| Token F1 | Trong các token thực thể, đúng bao nhiêu? | Khi soi mô hình học được gì ở mức token |
| Span F1 | Có lấy đúng cả đoạn, đúng cả hai biên? | Mặc định — con số để báo |
| Câu đúng trọn | Cả câu này có dùng được không? | Khi đầu ra đi thẳng vào hệ thống khác |
Từ bài sau, mọi con số của series là span F1.
Chạy lại mọi con số
Repo Python thuần, không phụ thuộc ngoài, không cần cài gì:
git clone https://github.com/tdduydev/ner-nhin-la-hieu
cd ner-nhin-la-hieu
python3 scratch/ep01_accuracy.py
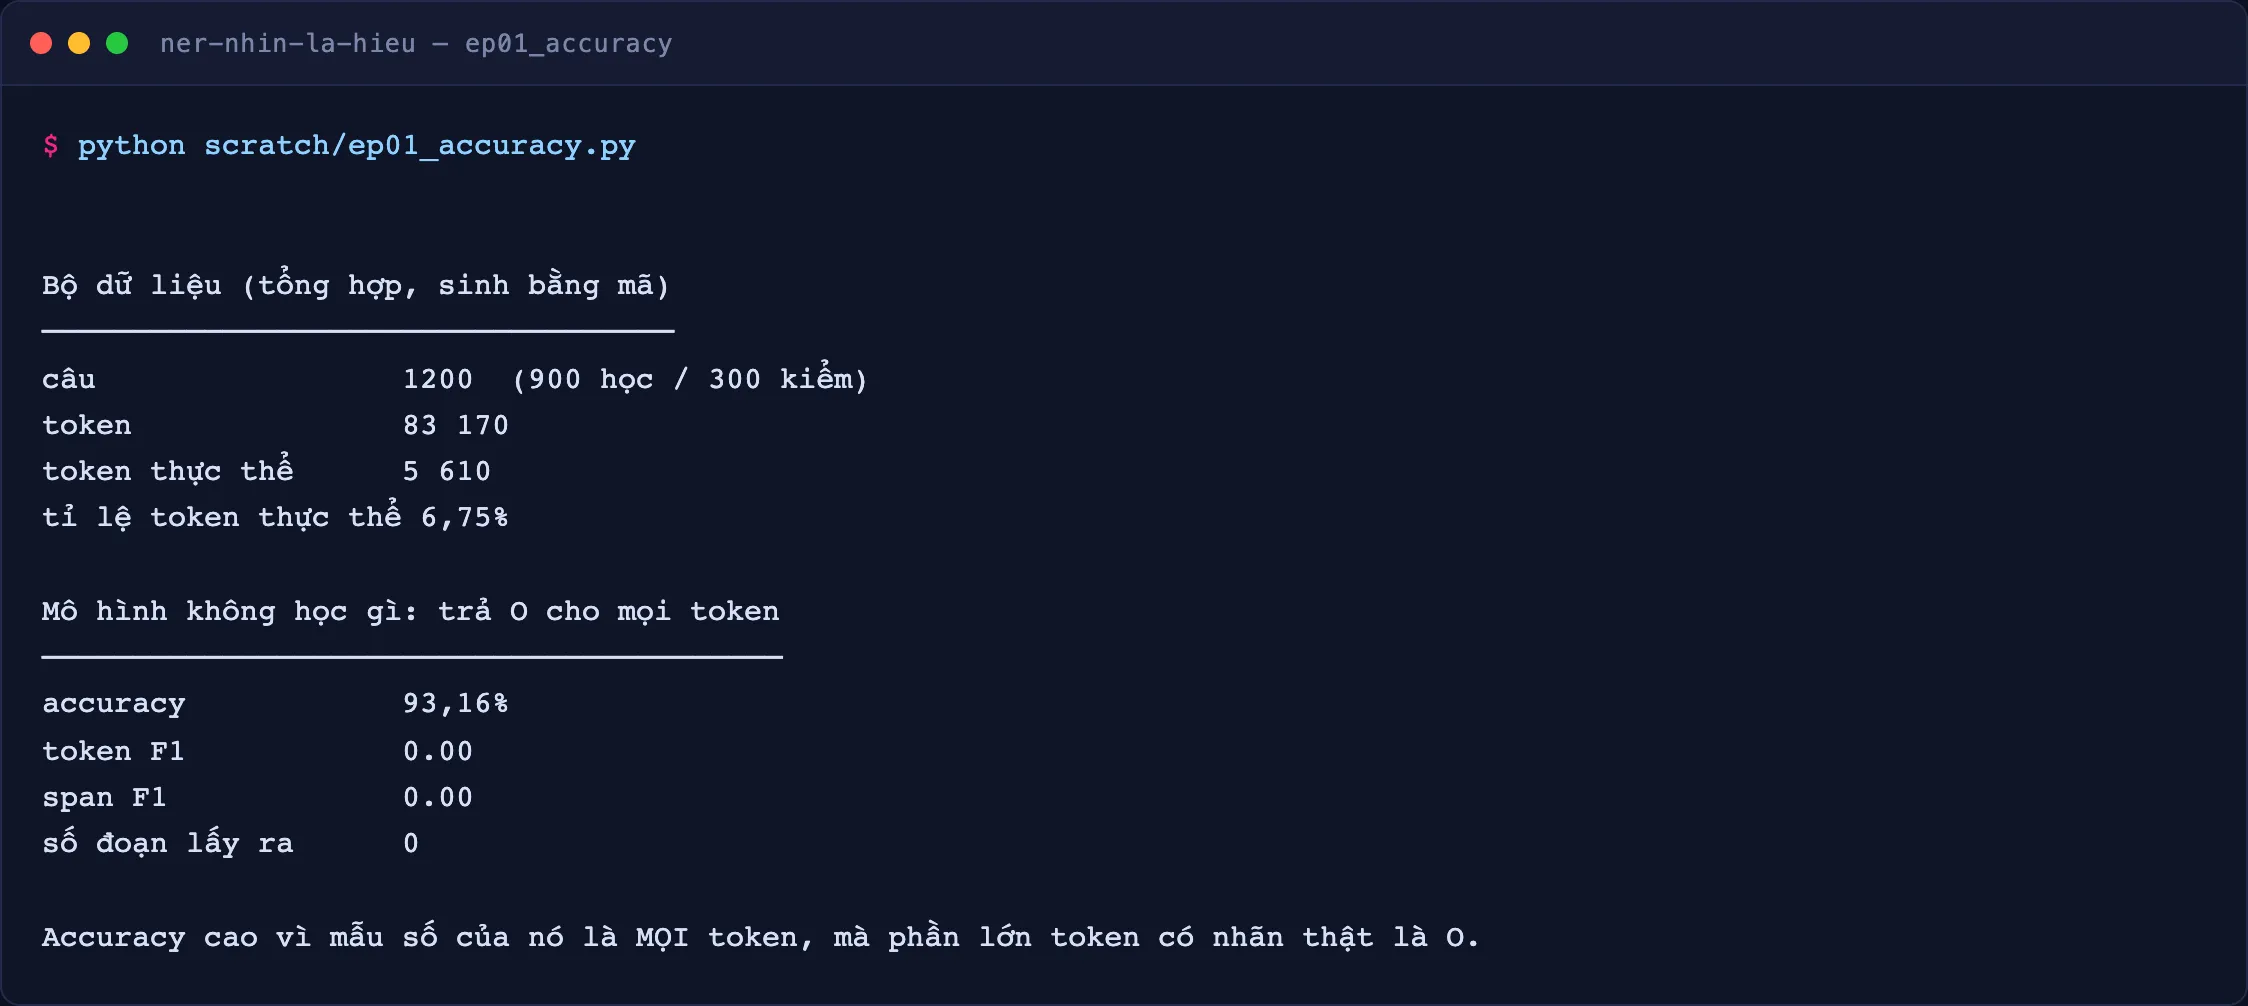
Toàn bộ số của bảy bài: python3 measure.py. Khẳng định số không đổi: python3 run_tests.py.
Dữ liệu ở đây là tổng hợp. Corpus 1 200 câu tiếng Việt sinh bằng mã, không phải corpus thật — môi trường dựng series không có mạng để tải corpus NER tiếng Việt. Các hiện tượng bài này đo là hệ quả của cấu trúc bài toán nên tái hiện đúng trên dữ liệu tổng hợp; nhưng mức tuyệt đối không so được với số công bố trên corpus thật, và series không so. Tên tổ chức trong dữ liệu là hư cấu.