
Series này khác gì
Phần lớn tài liệu về NER bắt đầu bằng kiến trúc mô hình. Series này bắt đầu bằng cách đo — vì ở bài toán trích xuất, chọn sai độ đo thì mọi thứ sau đó vô nghĩa.
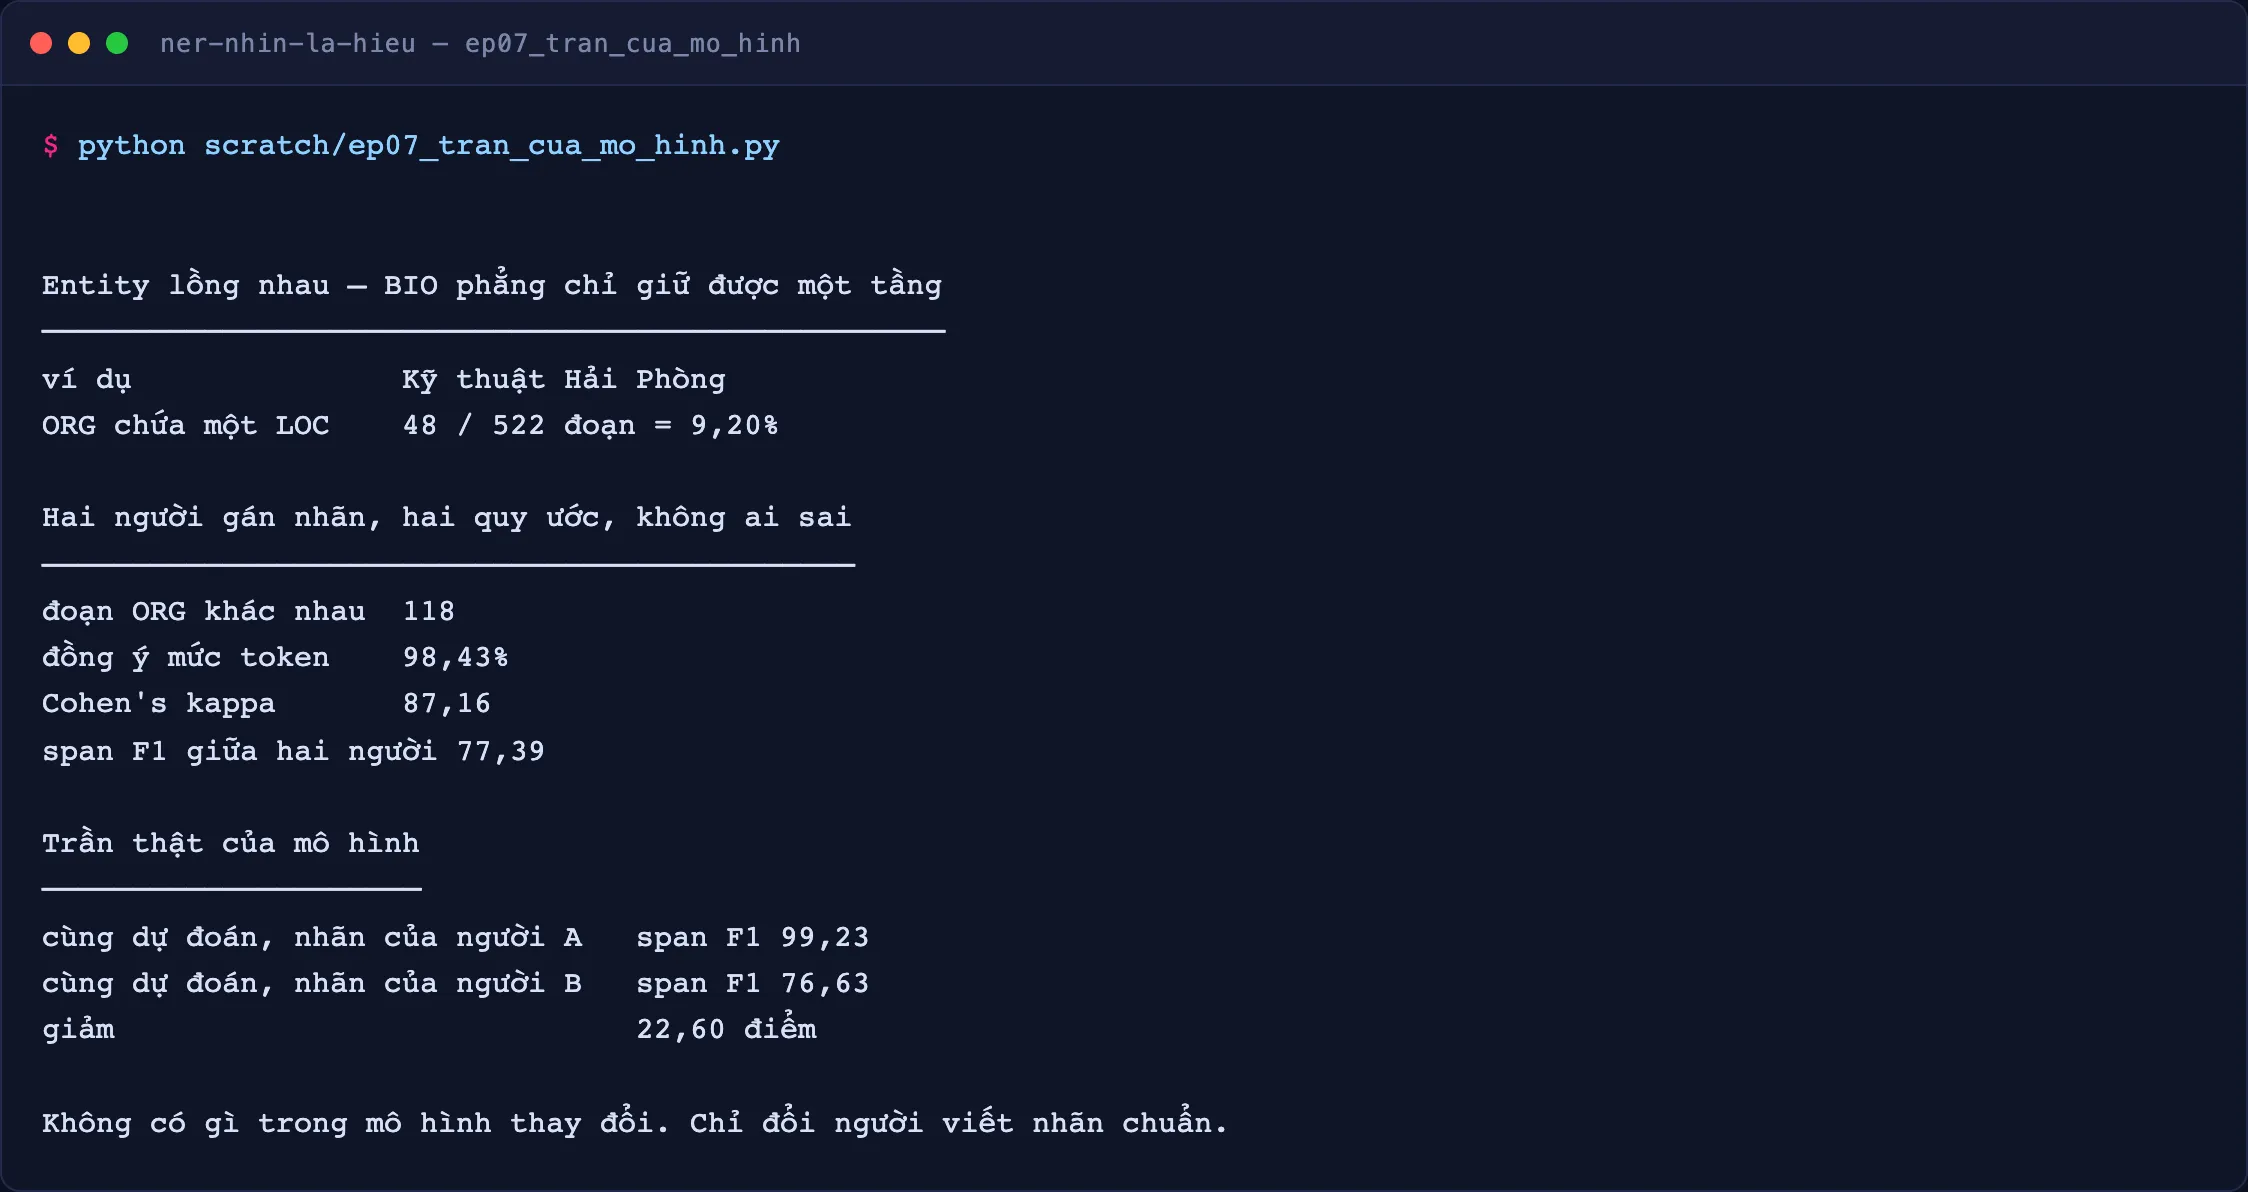
Bài 1 dựng một mô hình không học gì và cho nó đạt 93,16% độ chính xác trong khi lấy ra 0 thực thể. Bài cuối cho thấy con số 99,23 của một mô hình tốt tụt xuống 76,63 chỉ vì đổi người viết nhãn chuẩn.
Ở giữa là năm bài về những chỗ bài toán này gãy: span so với token, từ điển so với mô hình học, chuỗi nhãn không thể tồn tại, và cách sửa nó mà không cần mô hình to hơn.
Mọi con số đều đo được
Repo kèm theo là Python thuần, không phụ thuộc ngoài. python3 measure.py in ra toàn bộ
bảng số của bảy bài trong dưới một giây, và python3 run_tests.py khẳng định chúng không đổi.
Con số trên khung video và con số trong bài viết đọc từ cùng một file do measure.py xuất
ra — nên chúng không thể lệch nhau.
Về dữ liệu
Dữ liệu ở đây là tổng hợp. Corpus 1 200 câu tiếng Việt sinh bằng mã, không phải corpus thật — môi trường dựng series không có mạng để tải corpus NER tiếng Việt. Các hiện tượng bài này đo là hệ quả của cấu trúc bài toán nên tái hiện đúng trên dữ liệu tổng hợp; nhưng mức tuyệt đối không so được với số công bố trên corpus thật, và series không so. Tên tổ chức trong dữ liệu là hư cấu.
Bản đầu của corpus phải dựng lại: entity chiếm 48% token (corpus thật 2–5%) và mô hình đạt điểm 1.0 tuyệt đối ở mọi độ đo. Điểm tuyệt đối không phải tin tốt — nó là dấu hiệu dữ liệu rò đáp án qua ngữ cảnh. Bản dùng thật cố ý có bốn thứ: chữ nền chiếm đa số, tên chưa từng gặp ở tập kiểm, chuỗi vừa là địa điểm vừa là tên tổ chức, và bẫy viết hoa không phải thực thể.
Bạn sẽ học được gì
- Chọn độ đo theo câu hỏi người dùng hỏi, không theo cái dễ tính
- Đọc khoảng cách giữa token F1 và span F1, và biết nó đến từ đâu
- Biết khi nào từ điển là lựa chọn đúng, và khi nào nó chắc chắn sập
- Phát hiện lỗi cấu trúc mà accuracy và F1 đều không thấy
- Sửa lỗi đó bằng cách giải mã, không bằng mô hình to hơn
- Đặt mục tiêu theo mức đồng thuận của người gán nhãn, không theo 100