Xem bản video
Bài viết dưới đây đi sâu hơn bản video và có code chạy được.
Con số của bài trước, đo lại
Bài 6 kết thúc ở span F1 99,23. Đây là cùng dự đoán đó, không đổi một chữ nào trong mô hình, đo với nhãn chuẩn của một người gán nhãn khác: 76,63.
Giảm 22,60 điểm. Mô hình không đổi. Dữ liệu huấn luyện không đổi. Cách giải mã không đổi. Chỉ có định nghĩa của câu trả lời đúng là khác.
Phần còn lại của bài giải thích vì sao.
Chuyện thứ nhất: entity lồng nhau
Kỹ thuật Hải Phòng là một tên tổ chức. Nhưng Hải Phòng bên trong nó cũng là một địa điểm
thật, và người dùng hoàn toàn có thể cần nó.
BIO phẳng cho mỗi token đúng một nhãn, nên nó chỉ giữ được một tầng.
| Đoạn giữ được (tầng ngoài) | 522 |
| Địa điểm nằm trong tên tổ chức, bị bỏ hẳn | 48 (9,20%) |
Chúng không bị đoán sai. Chúng không có chỗ để tồn tại trong cách gán nhãn này — nên không độ đo nào của sáu bài trước nhìn thấy chúng.
Chuyện thứ hai không nằm ở mô hình
Chuỗi Tập đoàn Thiên Phú:
token    :  Tập      đoàn     Thiên    Phú
người A  :  B-ORG    I-ORG    I-ORG    I-ORG    → "Tập đoàn Thiên Phú" (4 token)
người B  :  O        O        B-ORG    I-ORG    → "Thiên Phú" (2 token)
Người A tính cả tiền tố loại hình vào tên tổ chức. Người B chỉ lấy phần lõi. Cả hai quy ước đều dùng được, và cả hai đều có tài liệu hướng dẫn thật làm theo.
Với span F1 khớp chính xác, hai đoạn này không trùng nhau.
Đo mức bất đồng — và vì sao phải báo kappa
| Đoạn ORG gán khác nhau | 118 / 224 |
| Tỉ lệ đồng ý mức token | 98,43% |
| Cohen's kappa | 87,16 |
| Span F1 giữa hai người | 77,39 |
Ở dữ liệu NER, nhãn O chiếm đa số nên phần trùng do ngẫu nhiên rất lớn. Đó là lý do tỉ lệ
đồng ý 98,4% và kappa 87,16 là hai con số
rất khác nhau — và kappa mới là con số nên báo.
Còn ở mức đoạn, thứ người dùng thật sự nhận: hai người, không ai sai, chỉ trùng nhau 77,39.
Trần của mô hình không phải 100
Nó là mức đồng thuận giữa những người gán nhãn. Vượt qua mức đó thì con số không còn nghĩa gì, vì không còn một đáp án đúng để vượt.
Điều này có ba hệ quả thực dụng:
- Trước khi tối ưu mô hình, đo mức đồng thuận của người. Nếu kappa là 87,16, đừng đặt mục tiêu span F1 95.
- Tài liệu hướng dẫn gán nhãn quan trọng hơn kiến trúc mô hình ở giai đoạn đầu. Một quy ước rõ ràng, viết ra, có ví dụ biên — đó là thứ nâng trần.
- Số công bố phải kèm quy ước gán nhãn. So span F1 của hai hệ thống gán nhãn theo hai quy ước khác nhau là so hai thứ khác nhau.
Bảy bài, bảy con số
| Bài | Con số | Nó nói gì |
|---|---|---|
| 1 | 93,16% | Mô hình trả O cho mọi token, lấy ra 0 thực thể |
| 2 | 62 → 108 | Token sai, và số đoạn sai chúng gây ra |
| 3 | 10,17 điểm | Khoảng cách token F1 / span F1, lớn dần theo độ dài đoạn |
| 4 | 22,41% | Chuỗi ở tập kiểm chưa từng gặp — chỗ từ điển sập |
| 5 | 61 | Chuỗi nhãn không thể tồn tại, mà accuracy không thấy |
| 6 | +13,26 | Đổi cách giải mã, không thêm gì vào mô hình |
| 7 | 99,23 → 76,63 | Cùng dự đoán, đổi người gán nhãn chuẩn |
Mọi con số ở đây đo lại được bằng một lệnh.
Còn thiếu: so với gọi LLM
Series này không có bài đo việc gọi LLM với schema, vì môi trường dựng không có mạng và không có khoá API — và bịa số ở đây là phá đúng cái làm nên series.
Nếu bạn có khoá, phần khung để tự đo nằm sẵn trong repo: cùng tập kiểm, cùng span F1, và nhớ đo thêm chi phí mỗi 1 000 văn bản. Chỗ nào là số đo được, chỗ nào còn trống — bài này ghi rõ.
Chạy lại mọi con số
Repo Python thuần, không phụ thuộc ngoài, không cần cài gì:
git clone https://github.com/tdduydev/ner-nhin-la-hieu
cd ner-nhin-la-hieu
python3 scratch/ep07_tran_cua_mo_hinh.py
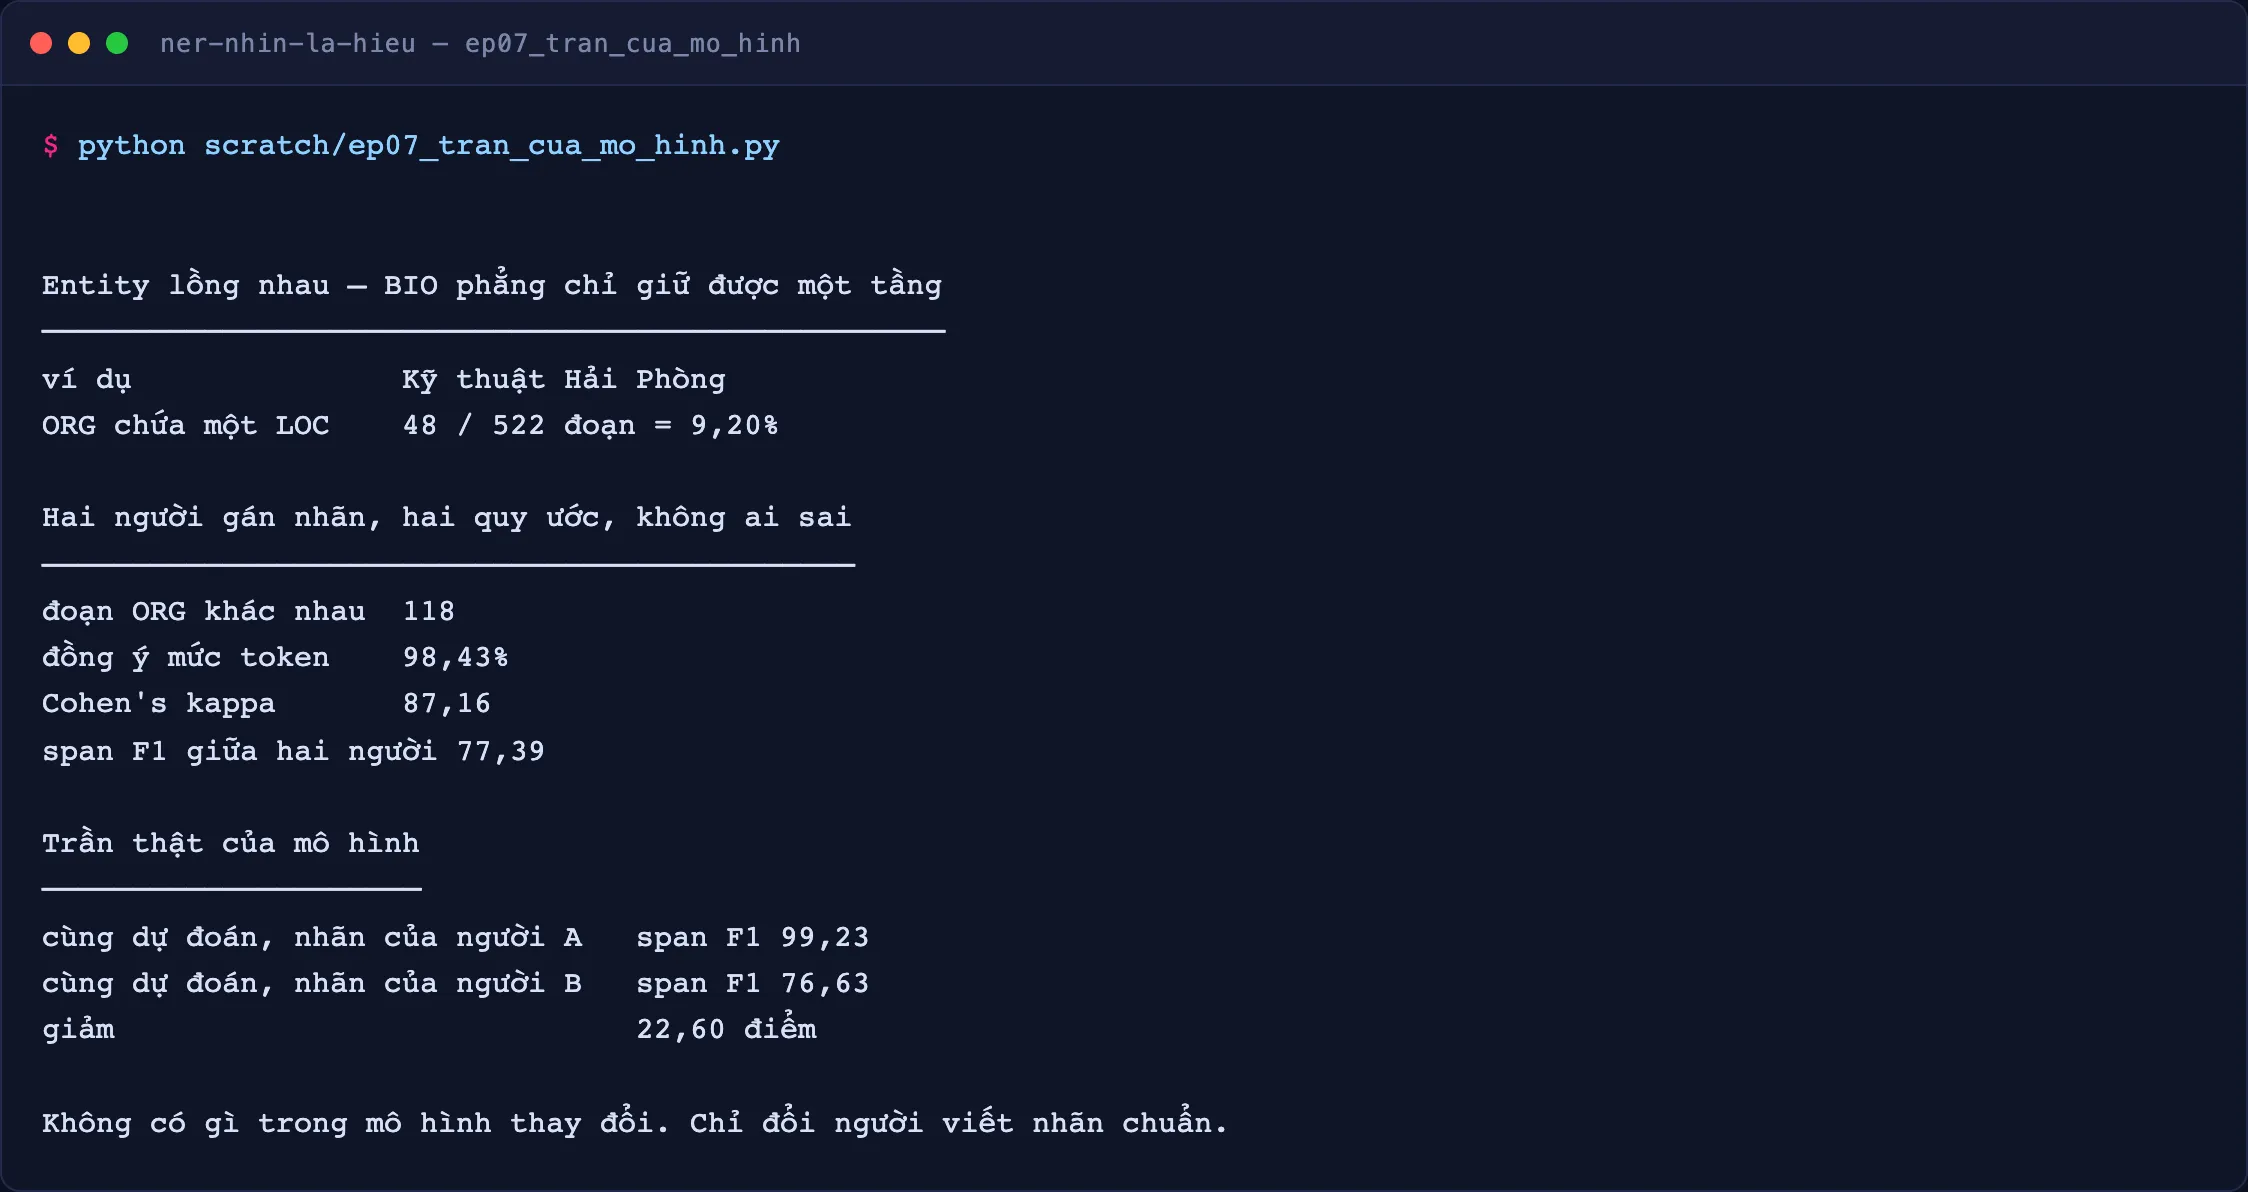
Toàn bộ số của bảy bài: python3 measure.py. Khẳng định số không đổi: python3 run_tests.py.
Dữ liệu ở đây là tổng hợp. Corpus 1 200 câu tiếng Việt sinh bằng mã, không phải corpus thật — môi trường dựng series không có mạng để tải corpus NER tiếng Việt. Các hiện tượng bài này đo là hệ quả của cấu trúc bài toán nên tái hiện đúng trên dữ liệu tổng hợp; nhưng mức tuyệt đối không so được với số công bố trên corpus thật, và series không so. Tên tổ chức trong dữ liệu là hư cấu.