Xem bản video
Bài viết dưới đây đi sâu hơn bản video và có code chạy được.
Một mô hình thật, không phải mô hình rỗng
Naive Bayes trên bốn đặc trưng — chính từ đó, từ liền trước, từ liền sau, và từ có viết hoa hay không — huấn luyện bằng đếm trên 900 câu. Cố tình giữ đơn giản: series này đo hiện tượng của bài toán, không đi thi điểm cao, và một mô hình đơn giản làm chỗ sai lộ ra rõ hơn.
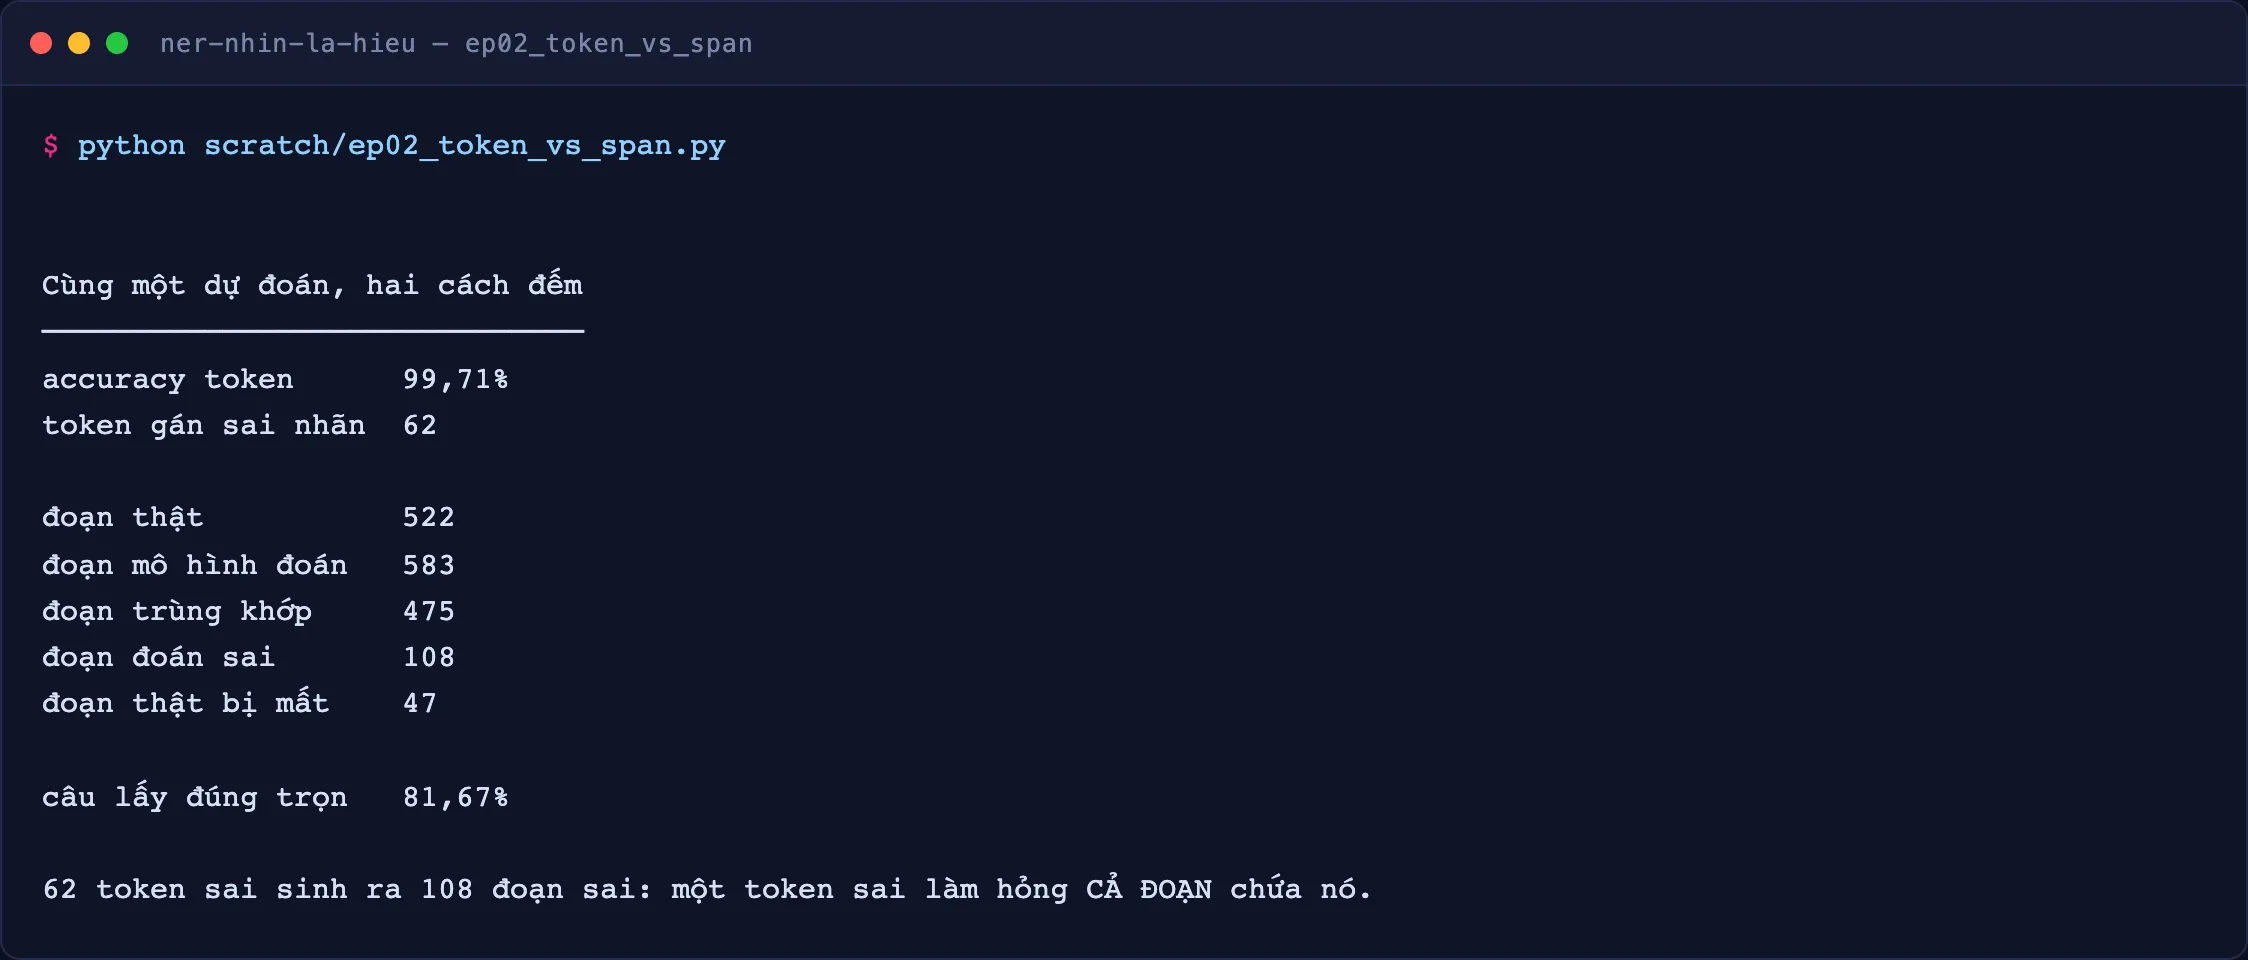
| Accuracy token | 99,71% |
| Token gán sai nhãn | 62 / 21 139 |
| Câu có ít nhất một đoạn sai | 55 / 300 |
Đếm đoạn thì ra chuyện khác
| Đoạn thật ở tập kiểm | 522 |
| Đoạn mô hình đoán ra | 583 |
| Trùng khớp chính xác | 475 |
| Đoạn đoán sai | 108 |
| Đoạn thật bị mất | 47 |
Chú ý số đoán ra nhiều hơn số thật. Không phải mô hình tham lam — mà 44
lần, một đoạn thật bị cắt thành nhiều đoạn. Một token bị gán O ở giữa một cái tên là đủ.
Bốn kiểu sai, và bốn trong năm là lỗi biên
| Kiểu | Số lần | Nghĩa là |
|---|---|---|
| Lệch biên phải | 44 | biên trái đúng, cắt sai ở cuối |
| Lệch biên trái | 44 | biên phải đúng, bắt đầu sai chỗ |
| Lệch cả hai biên | 5 | trùng phần giữa, không trùng biên nào |
| Sai loại | 3 | hai biên đúng, gọi tên loại sai |
| Không trùng gì | 12 | dựng đoạn ở chỗ không có thực thể |
Loại thì mô hình gần như luôn đúng (3 lần sai). Chỗ nó gãy là đoạn bắt đầu và kết thúc ở đâu.
Một ca thật
Ca dưới đây là lỗi mô hình thực sự mắc trên tập kiểm, tìm bằng cách chạy mô hình chứ không nghĩ ra:
token   :  Mai      Đức      Khôi
nhãn thật: B-PER    I-PER    I-PER      → 1 đoạn: PER "Mai Đức Khôi"
mô hình  : B-PER    I-LOC    I-PER      → 3 đoạn: PER "Mai" · LOC "Đức" · PER "Khôi"
Token đúng 2/3. Đoạn đúng 0. Và không đoạn nào trong ba cái mô hình sinh ra trùng với đoạn thật.
Đó là toàn bộ khoảng cách giữa hai cách đếm: 62 lỗi token sinh ra 108 đoạn sai. Một token sai không làm hỏng một token — nó làm hỏng cả đoạn chứa nó, và có khi dựng thêm một đoạn thứ hai không hề tồn tại.
Con số nên báo cho người dùng
82% — tỉ lệ câu lấy đúng trọn mọi đoạn. 55 câu còn lại cần người xem lại.
Độ chính xác token nói 99,71%. Người vận hành hệ thống cảm nhận được 82%. Hai con số đó cùng đúng, và chỉ một cái trả lời câu họ hỏi.
Chạy lại mọi con số
Repo Python thuần, không phụ thuộc ngoài, không cần cài gì:
git clone https://github.com/tdduydev/ner-nhin-la-hieu
cd ner-nhin-la-hieu
python3 scratch/ep02_token_vs_span.py
Toàn bộ số của bảy bài: python3 measure.py. Khẳng định số không đổi: python3 run_tests.py.
Dữ liệu ở đây là tổng hợp. Corpus 1 200 câu tiếng Việt sinh bằng mã, không phải corpus thật — môi trường dựng series không có mạng để tải corpus NER tiếng Việt. Các hiện tượng bài này đo là hệ quả của cấu trúc bài toán nên tái hiện đúng trên dữ liệu tổng hợp; nhưng mức tuyệt đối không so được với số công bố trên corpus thật, và series không so. Tên tổ chức trong dữ liệu là hư cấu.