Xem bản video
Bài viết dưới đây đi sâu hơn bản video và có code chạy được.
Đổi đúng một biến
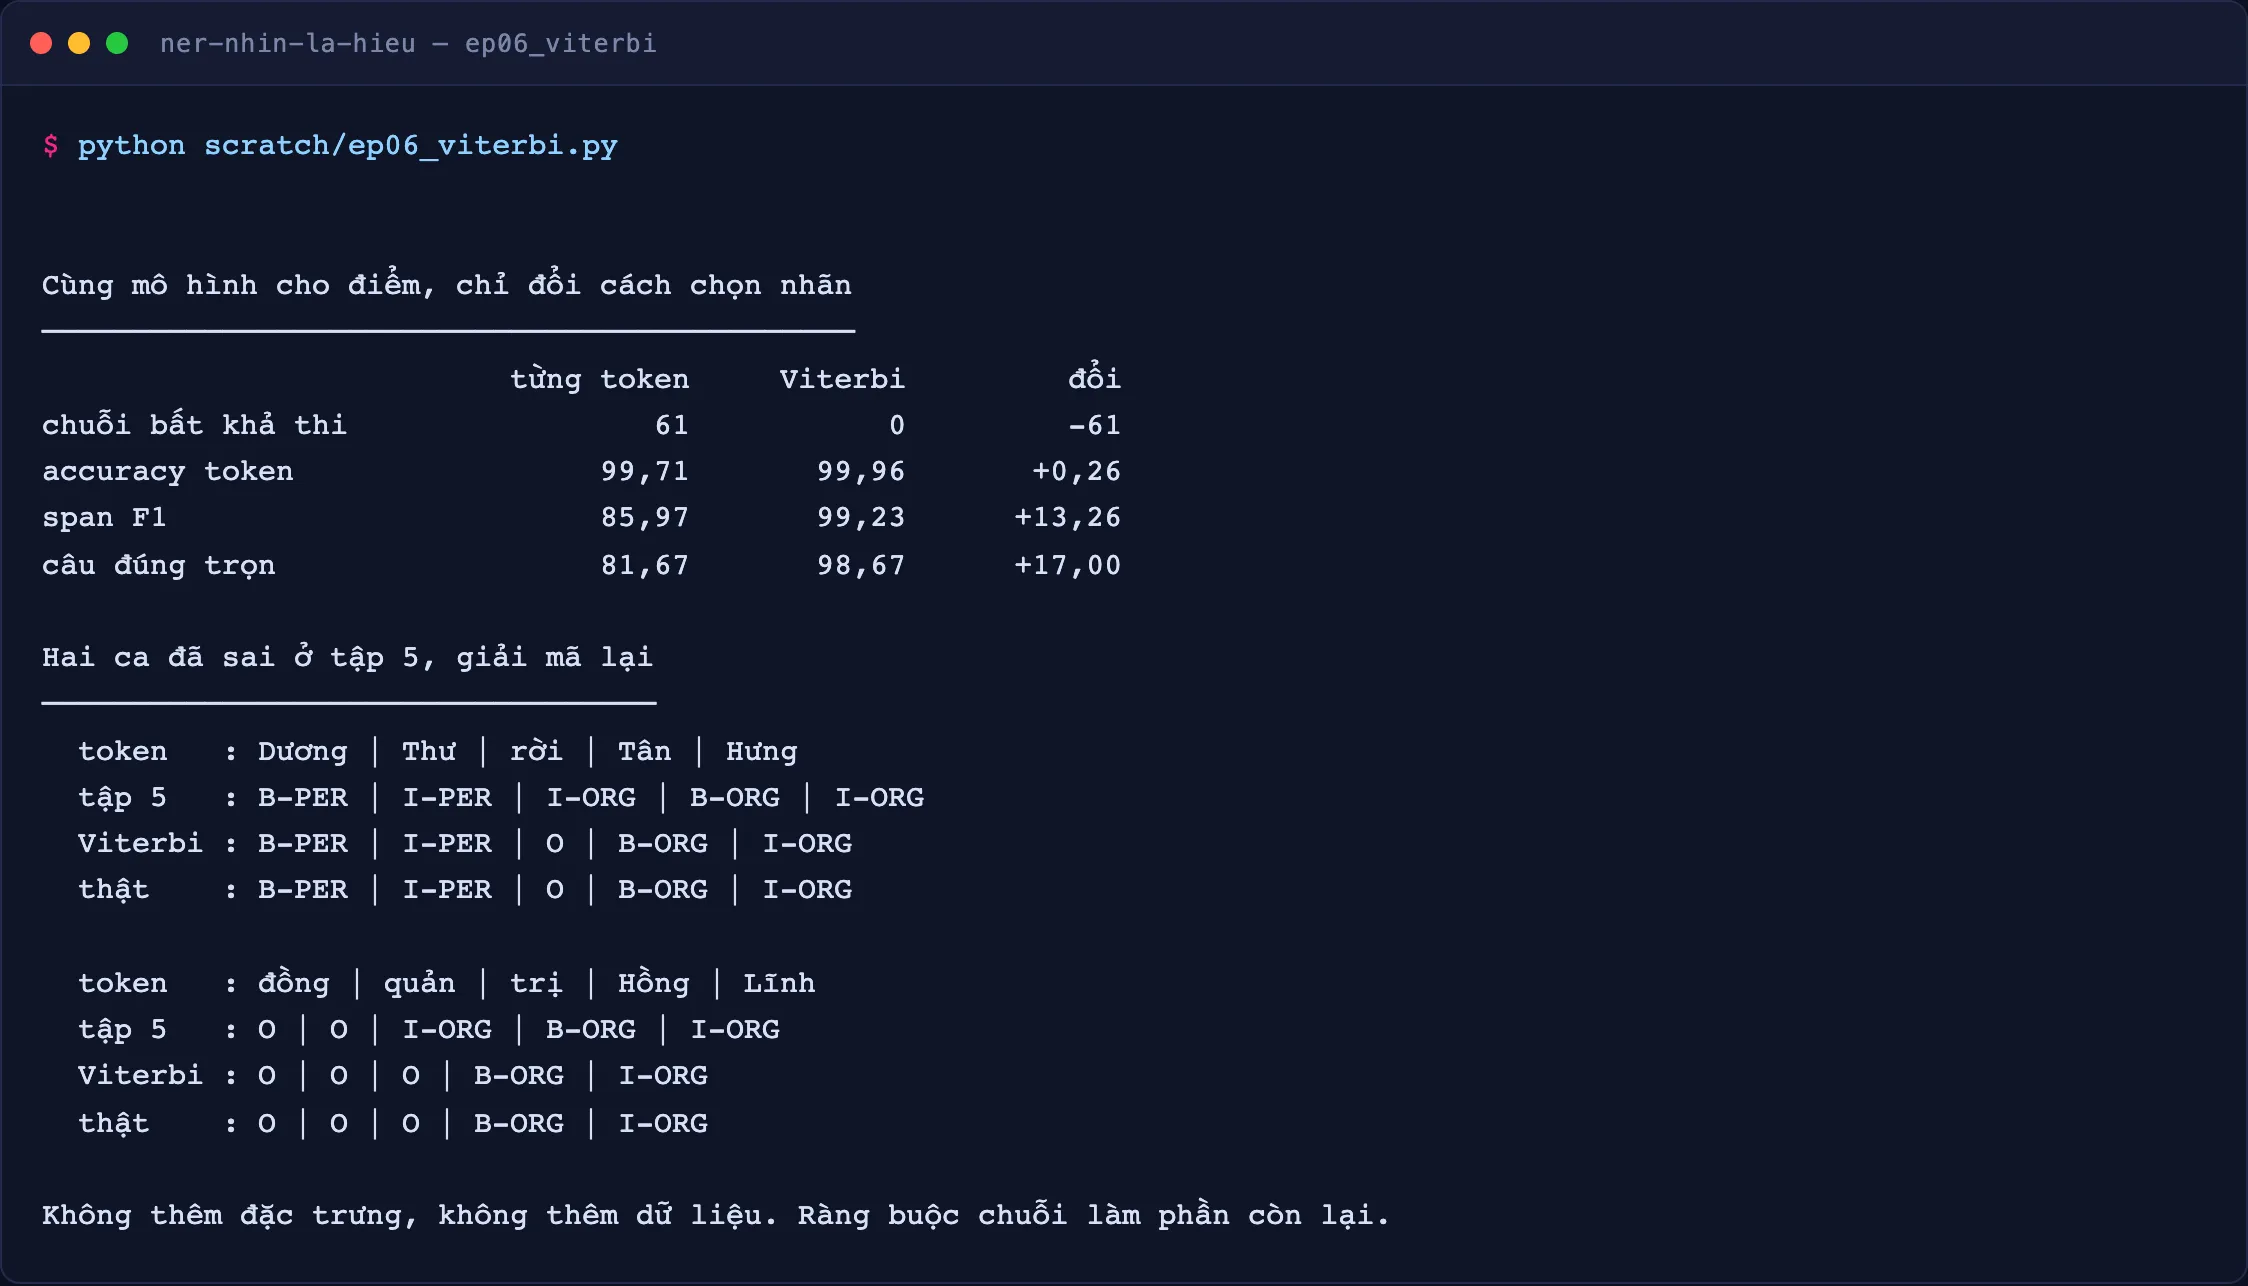
Cùng mô hình cho điểm của bài trước. Không thêm đặc trưng, không thêm dữ liệu, không đổi tham số. Chỉ đổi cách chọn nhãn.
| Chọn từng token | Viterbi | Đổi | |
|---|---|---|---|
| Chuỗi bất khả thi | 61 | 0 | −61 |
| Accuracy token | 99,71% | 99,96% | +0,26 |
| Span F1 | 85,97 | 99,23 | +13,26 |
| Câu đúng trọn | 82% | 99% | +17,00 |
Đọc theo hàng: accuracy gần như đứng yên, hai hàng dưới nhảy hẳn. Đó là dấu hiệu lỗi cũ là lỗi cấu trúc, không phải lỗi nhận dạng.
Điểm quan trọng của thiết kế này: bài 5 và bài 6 dùng chung một mô hình cho điểm. Nên khi span F1 nhảy 13,26 điểm, biến duy nhất đổi là cách giải mã.
Viterbi làm gì
Cách cũ: mỗi vị trí quyết định một mình, lấy nhãn cao điểm nhất.
Viterbi: chọn cả chuỗi nhãn có tổng điểm cao nhất. Vẫn dùng đúng bộ điểm cũ, nhưng cộng thêm điểm cho từng cặp nhãn liền nhau, và quyết định trên cả câu.
Chỗ then chốt: điểm của 15 cặp bất khả thi được đặt bằng âm vô cùng.
Khác biệt giữa phạt nặng và loại hẳn là thật:
- Phạt nặng — vẫn có thể xảy ra nếu bộ điểm đủ tự tin, chỉ là ít gặp hơn.
- Loại hẳn — không bao giờ xảy ra. Viterbi không thể trả về chuỗi sai luật.
Đó là lý do con số bất khả thi về đúng 0, chứ không phải "giảm nhiều".
Hai ca của bài trước, giải mã lại
token   :  Dương    Thư      rời      Tân      Hưng
bài 5   :  B-PER    I-PER    I-ORG    B-ORG    I-ORG   ← sai luật
Viterbi :  B-PER    I-PER    O        B-ORG    I-ORG   ← trùng nhãn thật
Viterbi không đoán giỏi hơn ở token rời. Nó chỉ không được phép chọn I-ORG ở đó, nên
buộc phải lấy phương án hợp luật tốt nhất — và phương án đó trùng nhãn thật.
Ai hưởng lợi nhiều nhất
| Loại | Lấy đúng | Recall |
|---|---|---|
| PER — tên người | 133 / 133 | 100% |
| ORG — tổ chức | 220 / 224 | 98% |
| LOC — địa điểm | 165 / 165 | 100% |
Tên người có đoạn dài nhất nên chịu thiệt nhiều nhất khi giải mã rời rạc — và cũng hưởng lợi nhiều nhất khi thêm ràng buộc chuỗi.
Nói rõ giới hạn
Mức 99,23 là hệ quả của corpus sinh bằng mã, văn phạm khá cứng. Đừng mang con số đó đi so với corpus thật.
Thứ mang đi được là khoảng cách: cùng một mô hình, cùng một dữ liệu, đổi cách giải mã thì span F1 chênh 13,26 điểm. Một con số không kèm điều kiện đo là một con số không dùng được.
Chạy lại mọi con số
Repo Python thuần, không phụ thuộc ngoài, không cần cài gì:
git clone https://github.com/tdduydev/ner-nhin-la-hieu
cd ner-nhin-la-hieu
python3 scratch/ep06_viterbi.py
Toàn bộ số của bảy bài: python3 measure.py. Khẳng định số không đổi: python3 run_tests.py.
Dữ liệu ở đây là tổng hợp. Corpus 1 200 câu tiếng Việt sinh bằng mã, không phải corpus thật — môi trường dựng series không có mạng để tải corpus NER tiếng Việt. Các hiện tượng bài này đo là hệ quả của cấu trúc bài toán nên tái hiện đúng trên dữ liệu tổng hợp; nhưng mức tuyệt đối không so được với số công bố trên corpus thật, và series không so. Tên tổ chức trong dữ liệu là hư cấu.