Xem bản video
Bài viết dưới đây đi sâu hơn bản video và có code chạy được.
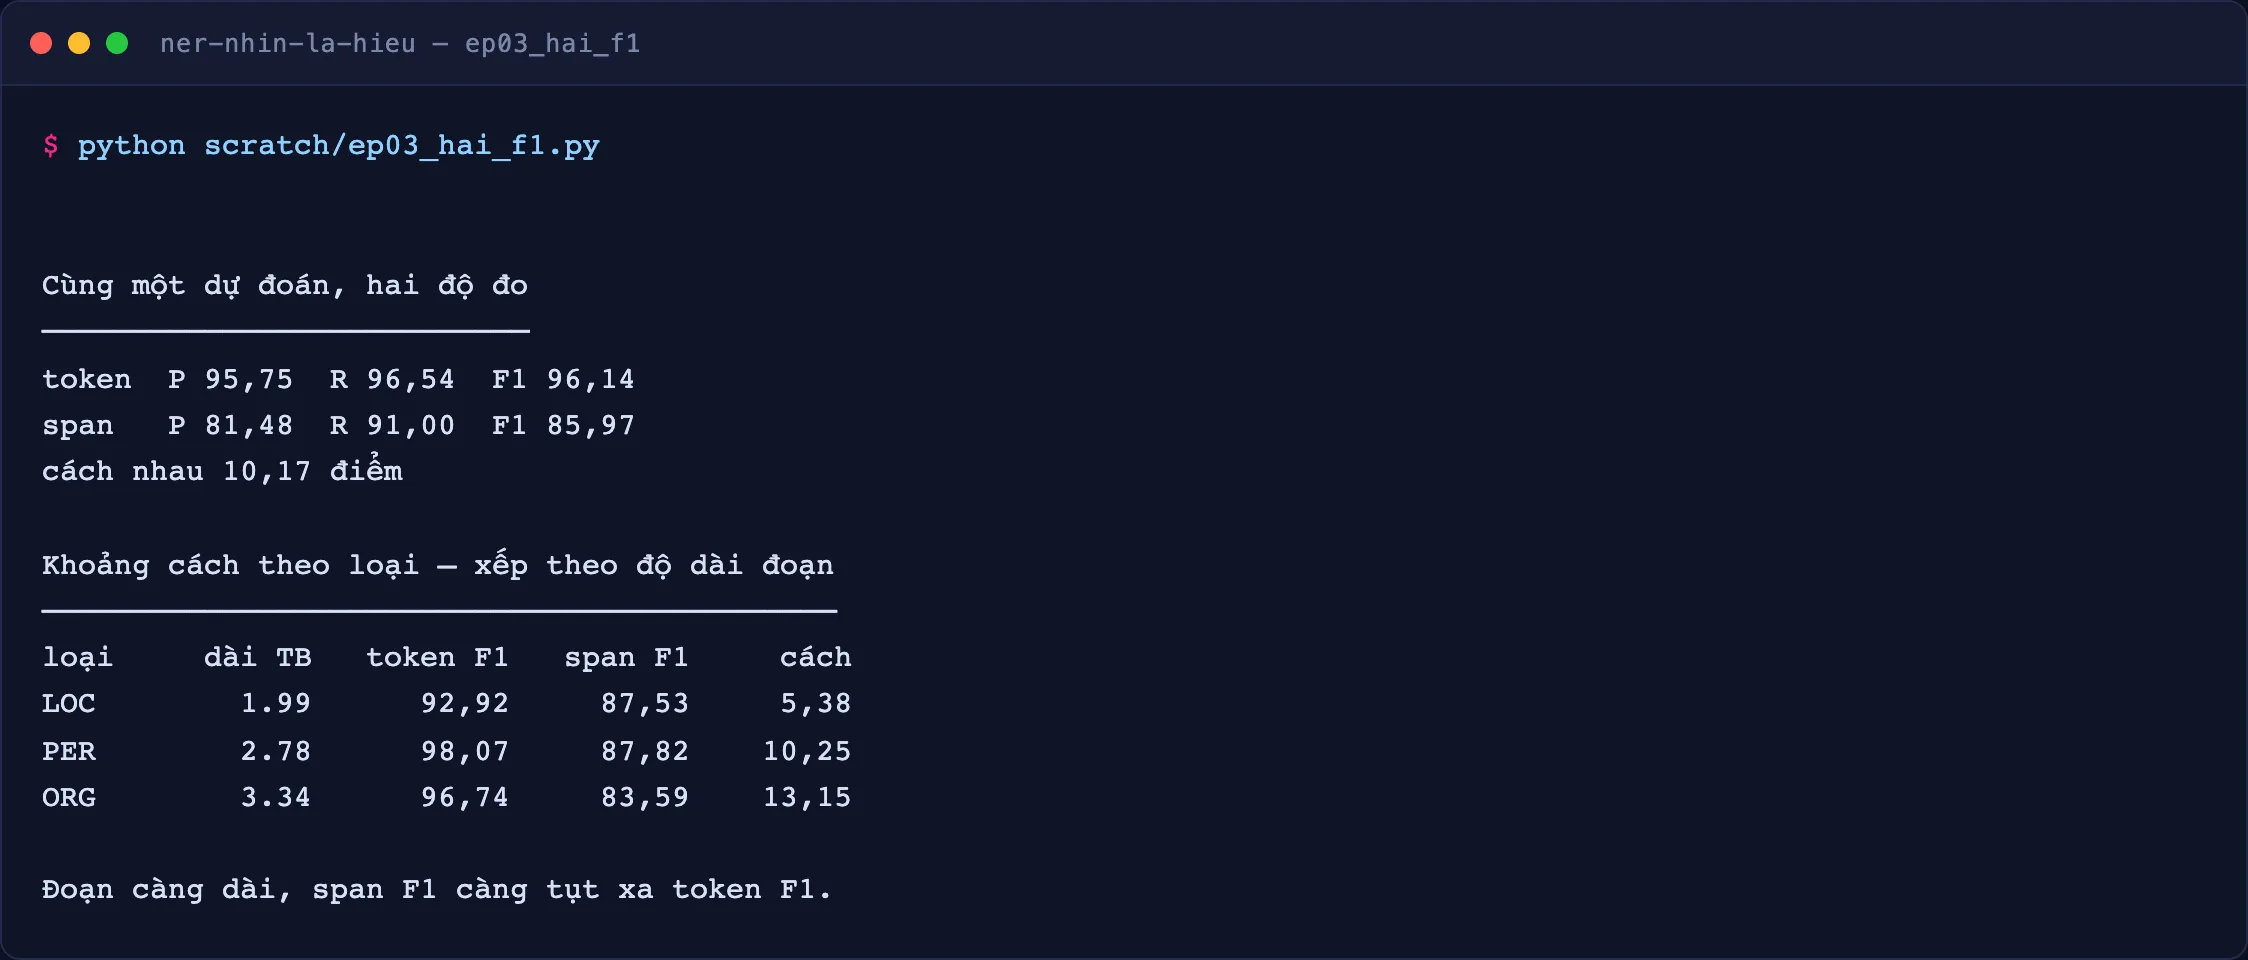
Cùng một dự đoán, tính F1 hai lần
| Precision | Recall | F1 | |
|---|---|---|---|
| Token | 95,75 | 96,54 | 96,14 |
| Span | 81,48 | 91,00 | 85,97 |
Cách nhau 10,17 điểm. Không con số nào sai.
Token F1 tính trên từng token nhưng bỏ nhãn O khỏi tử số — nếu không thì nó thành
accuracy của bài 1. Span F1 khắt khe hơn nhiều: một đoạn chỉ tính là đúng khi trùng loại,
trùng token bắt đầu, và trùng token kết thúc.
Khoảng cách đó phụ thuộc vào cái gì
Câu hỏi hay hơn "con số nào cao hơn" là: khoảng cách 10,17 điểm ấy do đâu mà có.
Một đoạn dài ba token chỉ tính là đúng khi cả ba token đúng nhãn. Xác suất sai ở đâu đó trong đoạn tăng theo độ dài. Nên đoạn càng dài, span F1 càng tụt xa token F1.
Đó là suy luận. Đây là số đo:
| Loại | Độ dài TB | Token F1 | Span F1 | Cách nhau |
|---|---|---|---|---|
| LOC (địa điểm) | 1.99 token | 92,92 | 87,53 | 5,38 |
| PER (tên người) | 2.78 token | 98,07 | 87,82 | 10,25 |
| ORG (tổ chức) | 3.34 token | 96,74 | 83,59 | 13,15 |
Ba loại, ba độ dài, ba khoảng cách — và chúng xếp đúng theo thứ tự độ dài. Đây không phải chuyện riêng của một loại thực thể nào; nó là hệ quả của việc đo theo đoạn.
Một chi tiết đáng để ý
Ở mức đoạn, precision 81,48 thấp hơn recall 91,00.
Nghĩa là mô hình dựng ra nhiều đoạn hơn số đoạn thật — 583 so với 522. Nó không bỏ sót nhiều; nó cắt vụn. Hai kiểu hỏng đó cần hai cách sửa khác nhau, và chỉ nhìn F1 gộp thì không phân biệt được.
Báo số nào
Một quy tắc, không phải sở thích:
- Đầu ra vào mắt người → span F1.
- Đầu ra đi thẳng vào hệ thống khác → tỉ lệ câu đúng trọn.
- Token F1 → giữ trong nhà, dùng khi đang soi mô hình học được gì.
Chạy lại mọi con số
Repo Python thuần, không phụ thuộc ngoài, không cần cài gì:
git clone https://github.com/tdduydev/ner-nhin-la-hieu
cd ner-nhin-la-hieu
python3 scratch/ep03_hai_f1.py
Toàn bộ số của bảy bài: python3 measure.py. Khẳng định số không đổi: python3 run_tests.py.
Dữ liệu ở đây là tổng hợp. Corpus 1 200 câu tiếng Việt sinh bằng mã, không phải corpus thật — môi trường dựng series không có mạng để tải corpus NER tiếng Việt. Các hiện tượng bài này đo là hệ quả của cấu trúc bài toán nên tái hiện đúng trên dữ liệu tổng hợp; nhưng mức tuyệt đối không so được với số công bố trên corpus thật, và series không so. Tên tổ chức trong dữ liệu là hư cấu.