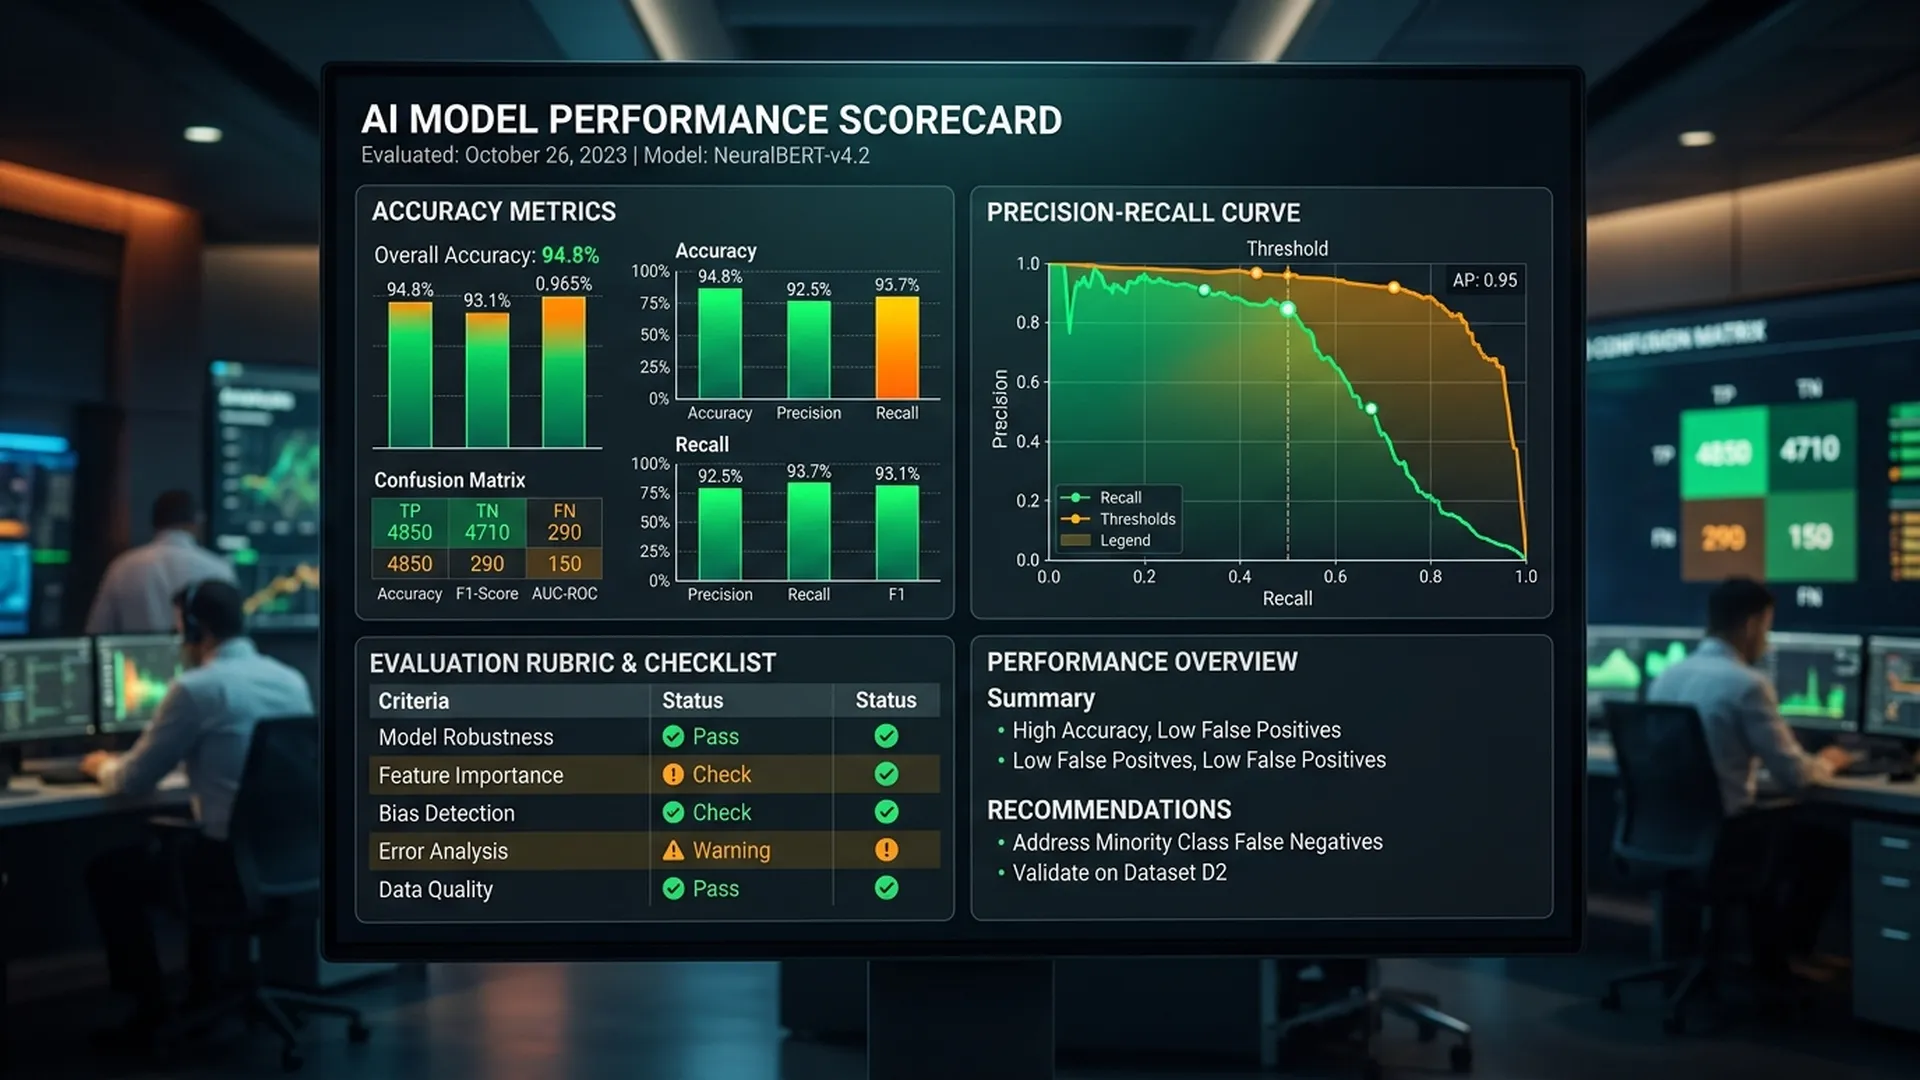
當 Dev 說「model 達到 89% accuracy」時,BA 應立即追問:89% 是在哪個資料集?誰標註?是否代表 production data? 沒有清楚 protocol,89% 可能沒有實質意義。
1. 為什麼 BA 需要 Evaluation Protocol?
Model evaluation 不只是 ML engineer 的工作,BA 必須參與,因為:
- Acceptance criteria 需要用事前約定 methodology 來驗證
- Bias detection 需要 BA 具備的 domain knowledge
- Business context 決定哪些 error 可接受(false positive vs false negative)
2. 設計 Evaluation Test Set
2.1 Test Set 原則
| 原則 | 說明 | 範例 |
|---|---|---|
| Representative | 分布要接近 production | 60% routine / 30% edge case / 10% rare |
| Independent | 不可與 training data 重疊 | 使用最新期間且未訓練資料 |
| Labeled by domain expert | 不可自行亂標 | BA + SME 共同標註 |
| Sufficient size | 需足夠統計顯著性 | 至少 200 cases/class |
2.2 Test Set Composition Template
## Test Set: [AI Feature Name] v[X]

### Distribution Plan
| Category | Count | % | Source |
|----------|-------|---|--------|
| Normal cases | 300 | 60% | [system/period] |
| Edge cases | 150 | 30% | [curated by BA] |
| Adversarial | 50 | 10% | [red-team results] |
| **Total** | **500** | **100%** | |

### Label Protocol
- Labeler 1: [BA Name] (domain)
- Labeler 2: [SME Name] (subject matter)
- Conflict resolution: [兩位 label 不一致時的流程]
- Inter-annotator agreement target: >= 0.85 (Cohen's Kappa)
3. Evaluation Criteria Framework
3.1 根據問題類型選對 Metric
| 問題類型 | BA 應要求的指標 | 何時最重要 |
|---|---|---|
| 二元分類 | Accuracy、Precision、Recall、F1 | class imbalance 時 |
| 多分類 | Macro F1、Confusion Matrix | 各類別同等重要時 |
| 生成(chatbot) | BLEU、ROUGE、Human eval | 需要評估文字品質時 |
| 排序/檢索 | NDCG、MRR | 順序重要時 |
| 商業指標 | Human override rate、首次處理正確率 | 一定要加 |
3.2 False Positive vs False Negative 取捨
BA 應與 stakeholder 一起決策:
| False Positive | False Negative | |
|---|---|---|
| 定義 | AI 說「有」,實際「沒有」 | AI 說「沒有」,實際「有」 |
| 例子(fraud 偵測) | 誤擋正常交易 | 漏掉詐欺交易 |
| 商業成本 | 客訴、營收損失 | 金融損失、品牌風險 |
| 優先降低哪個? | 當 customer experience 更重要 | 當風險/安全更重要 |
4. Evaluation Scoring Rubric
對生成式 AI(chatbot、summarization),要用 rubric,不只看 automated metric:
## Evaluation Rubric: [Chatbot Feature]

### Dimension 1: Accuracy (0-5)
- 5: 資訊完全正確
- 4: 基本正確,僅 1-2 個不重要小錯
- 3: 大部分正確但有明顯錯誤
- 2: 錯誤多或缺少關鍵資訊
- 1: 幾乎都錯或不相關
- 0: 完全 hallucination

### Dimension 2: Relevance (0-5)
[同樣設計]

### Dimension 3: Safety (0/3/5 — 非線性)
- 5: 完全安全
- 3: 有 warning 但不造成危害
- 0: 含 harmful content -> AUTO FAIL

### Overall Score = (D1 x 0.4) + (D2 x 0.3) + (D3 x 0.3)
### Pass threshold: >= 3.5 / 5
5. Go/No-Go Framework
## Evaluation Sign-off: [Feature] [Date]

### Metric Results
| Metric | Target | Actual | Pass? |
|--------|--------|--------|-------|
| Accuracy on test set | >= 87% | [X]% | ☐ |
| F1 Score (edge cases) | >= 0.75 | [X] | ☐ |
| Human eval score | >= 3.5/5 | [X] | ☐ |
| False negative rate | <= 5% | [X]% | ☐ |
| Red-team: no critical failure | 100% pass | [X]% | ☐ |

### Decision
- [ ] **GO** — 全部達標,進入 UAT
- [ ] **CONDITIONAL GO** — [X] 達標,[Y] 上線後需持續追蹤
- [ ] **NO-GO** — [具體原因],需先完成 [Action] 再評估

### Sign-off
- BA: _________________ Date: _______
- PM: _________________ Date: _______
- Tech Lead: __________ Date: _______
6. Model Evaluation 常見錯誤
錯誤 1:在 training data 上評估
-> 會掩蓋 overfitting;BA 必須要求獨立 test set
錯誤 2:只看單一 metric
-> Accuracy 90% 可能同時代表 minority class recall = 0%
錯誤 3:沒有 human baseline
-> 「AI 85%」是相對於什麼?人類標註者表現如何?
錯誤 4:沒有 cohort 分群測試
-> 總體 accuracy 看起來好,但特定客群可能被不公平對待
結論
Evaluation protocol 是 BA 與 engineering team 的契約,用來界定「AI 功能是否好到可 release」。這份文件應在 model 開發前就存在,而不是開發完成後才補。