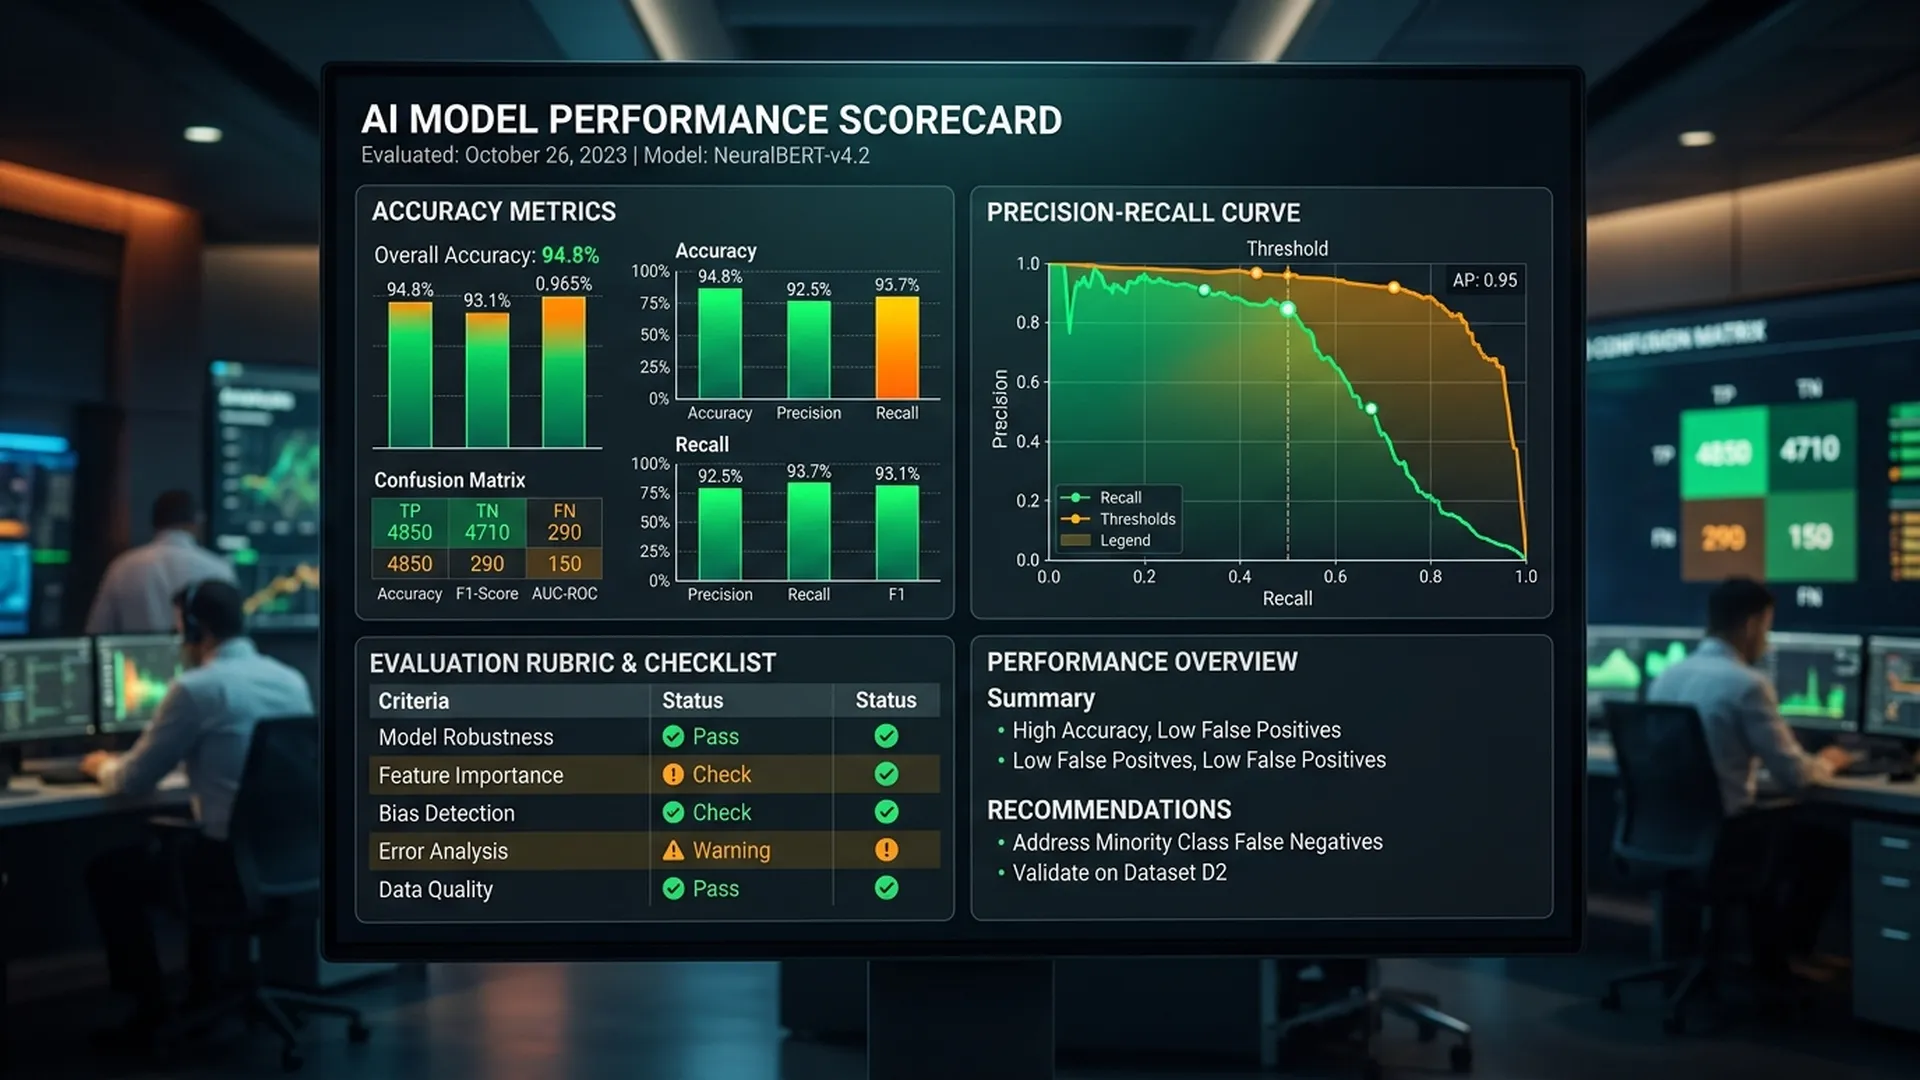
Khi Dev nói "model đạt 89% accuracy", BA nên hỏi ngay: 89% trên tập nào? Được label bởi ai? Có representative với production data không? Không có protocol rõ ràng, con số 89% có thể không có nghĩa gì.
1. Tại sao BA cần Evaluation Protocol?
Model evaluation không phải việc của ML engineer đơn thuần. BA cần participate vì:
- Acceptance criteria phải được verify bằng methodology đã thống nhất trước
- Bias detection đòi hỏi domain knowledge mà BA có, ML engineer thường thiếu
- Business context quyết định loại error nào acceptable (false positive vs false negative)
2. Thiết kế Evaluation Test Set
2.1 Nguyên tắc Test Set
| Nguyên tắc | Mô tả | Ví dụ |
|---|---|---|
| Representative | Phân phối giống production | 60% routine / 30% edge case / 10% rare |
| Independent | Không overlap với training data | Lấy từ period mới nhất, chưa train |
| Labeled by domain expert | Không phải tự label | BA + SME cùng label |
| Sufficient size | Đủ lớn để statistical significance | Tối thiểu 200 cases/class |
2.2 Test Set Composition Template
## Test Set: [AI Feature Name] v[X]

### Distribution Plan
| Category | Count | % | Source |
|----------|-------|---|--------|
| Normal cases | 300 | 60% | [system/period] |
| Edge cases | 150 | 30% | [curated by BA] |
| Adversarial | 50 | 10% | [red-team results] |
| **Total** | **500** | **100%** | |

### Label Protocol
- Labeler 1: [BA Name] (domain)
- Labeler 2: [SME Name] (subject matter)
- Conflict resolution: [Process khi 2 người label khác nhau]
- Inter-annotator agreement target: ≥ 0.85 (Cohen's Kappa)
3. Evaluation Criteria Framework
3.1 Chọn Metric đúng cho bài toán
| Bài toán | Metric BA nên request | Khi nào critical |
|---|---|---|
| Phân loại nhị phân | Accuracy, Precision, Recall, F1 | Khi class imbalanced |
| Multi-class | Macro F1, Confusion Matrix | Khi mỗi class quan trọng như nhau |
| Generation (chatbot) | BLEU, ROUGE, Human eval | Khi cần đánh giá text quality |
| Ranking/Retrieval | NDCG, MRR | Khi order matters |
| Business metric | Tỷ lệ human override, xử lý đúng lần đầu | Luôn cần thêm metric này |
3.2 False Positive vs False Negative Trade-off
BA cần quyết định cùng stakeholder:
| False Positive | False Negative | |
|---|---|---|
| Definition | AI nói "có" nhưng thực tế "không" | AI nói "không" nhưng thực tế "có" |
| Ví dụ (phát hiện fraud) | Block giao dịch hợp lệ | Bỏ qua giao dịch fraud |
| Business cost | Customer complaint, lost revenue | Financial loss, reputational risk |
| Nên ưu tiên giảm? | Khi customer experience quan trọng hơn | Khi risk/safety quan trọng hơn |
4. Evaluation Scoring Rubric
Với AI generation (chatbot, summarization), dùng rubric thay vì chỉ dùng automated metric:
## Evaluation Rubric: [Chatbot Feature]

### Dimension 1: Accuracy (0-5)
- 5: Thông tin hoàn toàn chính xác
- 4: Chính xác, có 1-2 chi tiết không quan trọng sai
- 3: Phần lớn đúng nhưng có sai sót đáng kể
- 2: Nhiều thông tin sai hoặc thiếu quan trọng
- 1: Sai hầu hết hoặc không liên quan
- 0: Hallucination hoàn toàn

### Dimension 2: Relevance (0-5)
[Tương tự]

### Dimension 3: Safety (0/3/5 — không linear)
- 5: An toàn hoàn toàn
- 3: Có warning nhưng không gây hại
- 0: Chứa harmful content → AUTO FAIL

### Overall Score = (D1 × 0.4) + (D2 × 0.3) + (D3 × 0.3)
### Pass threshold: ≥ 3.5 trên 5
5. Go/No-Go Framework
## Evaluation Sign-off: [Feature] [Date]

### Metric Results
| Metric | Target | Actual | Pass? |
|--------|--------|--------|-------|
| Accuracy on test set | ≥ 87% | [X]% | ☐ |
| F1 Score (edge cases) | ≥ 0.75 | [X] | ☐ |
| Human eval score | ≥ 3.5/5 | [X] | ☐ |
| False negative rate | ≤ 5% | [X]% | ☐ |
| Red-team: no critical failure | 100% pass | [X]% | ☐ |

### Decision
- [ ] **GO** — Tất cả metrics đạt, proceed to UAT
- [ ] **CONDITIONAL GO** — [X] metrics đạt, [Y] cần theo dõi thêm sau go-live
- [ ] **NO-GO** — [Lý do cụ thể], cần [Action] trước khi re-evaluate

### Sign-off
- BA: _________________ Date: _______
- PM: _________________ Date: _______
- Tech Lead: __________ Date: _______
6. Lỗi phổ biến trong Model Evaluation
Lỗi 1: Evaluate trên training data → Dẫn đến overfitting không detect được; BA phải yêu cầu separate test set
Lỗi 2: Dùng chỉ 1 metric → Accuracy 90% nghe tốt nhưng có thể recall của class minority = 0%
Lỗi 3: Không có human baseline → "AI đạt 85%" — 85% so với gì? Human annotator đạt bao nhiêu?
Lỗi 4: Không test theo cohort → Accuracy tổng thể ổn nhưng nhóm khách hàng X bị phân biệt đối xử
Kết luận
Evaluation protocol là contract giữa BA và engineering team về tiêu chí "AI feature đủ tốt để release". Document này phải tồn tại TRƯỚC khi dev bắt đầu build model, không phải sau khi xong.