簡介
神經網路是所有現代人工智慧的基礎——從影像辨識模型到 ChatGPT。您可以將神經網路視為決策工廠:資料進來→經過許多處理步驟→輸出。
本課程自下而上建立理解:從單一「工人」(神經元)開始,然後將其組裝成一個「團隊」(網路),最後教導團隊如何「改進」(反向傳播)。
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(42)
1. 感知器:從生物學到數學
1.1 生物神經元-人工智慧的靈感
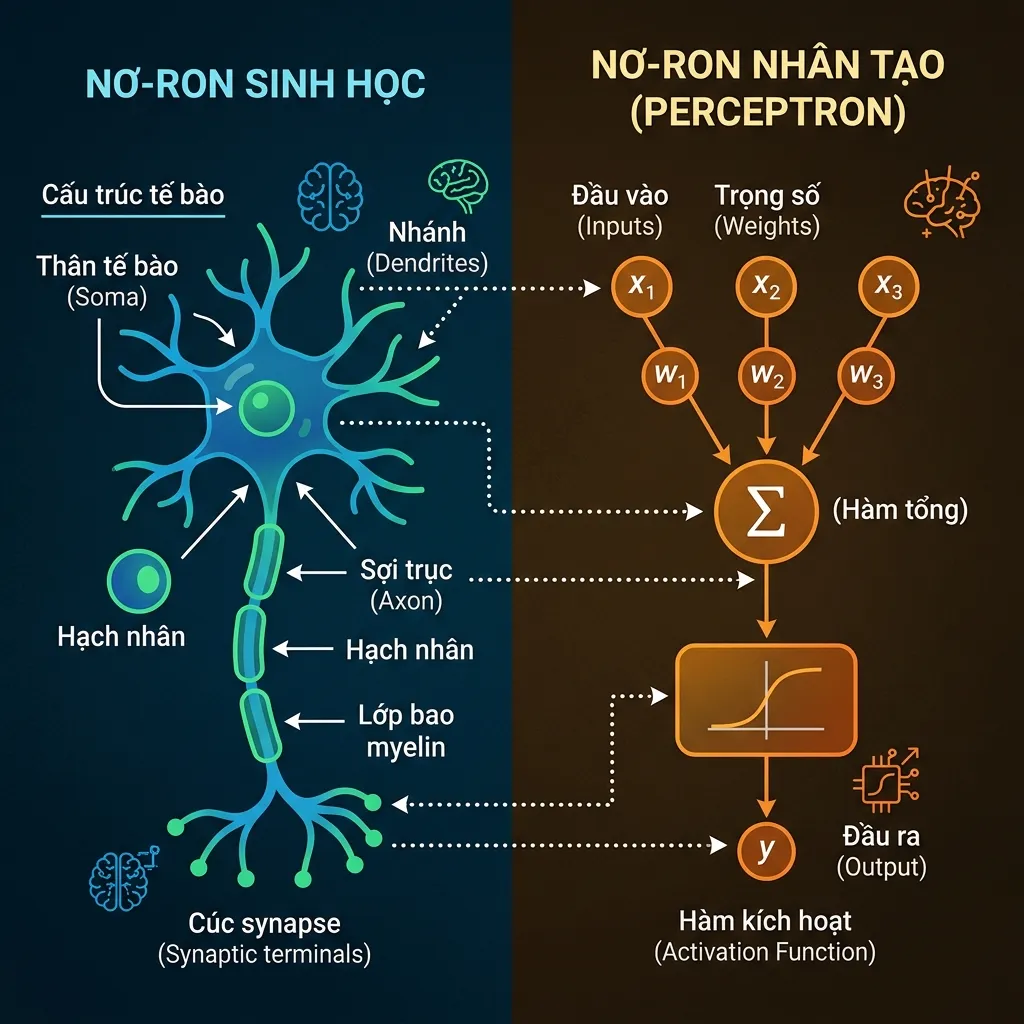
人腦約有 860 億個神經元。每個神經元都充當一個簡單的決策者:
- 透過樹突獲取資訊(多重輸入-例如聽取多個來源的意見)
- 細胞體/體細胞中的治療(考慮所有意見)
- 訊號透過軸突如果足夠的刺激(做出決定:「是」或「否」)
**現實生活中的例子:**想像一下你正在決定是否要和朋友出去吃飯:
| 因子(輸入) | 重要性等級(權重) | 今天的情況 |
|---|---|---|
| 有錢嗎? | w₁ = 0.4(重要) | x₁ = 1(是) |
| 天氣好嗎? | w2 = 0.1(較不重要) | x2 = 0(雨) |
| 你要去嗎,老兄? | w₃ = 0.5(非常重要) | x₃ = 1(是) |
總分:0.4×1 + 0.1×0 + 0.5×1 = 0.9 → 超過0.5的門檻 → **GO! ** 🎉
1.2 感知器 — 人工神經元 (1958)
Frank Rosenblatt 將神經元建模為數學公式:
z = w₁x₁ + w₂x₂ + ... + wₙxₙ + b = W·x + b
ŷ = f(z)    # f là activation function — quyết định "bắn" hay "không"
看起來很熟悉嗎?這是上一篇文章中的 點積 + 激活函數!
class Perceptron:
    def __init__(self, n_inputs, learning_rate=0.1):
        # Khởi tạo trọng số ngẫu nhiên nhỏ
        self.weights = np.random.randn(n_inputs) * 0.01
        self.bias = 0.0
        self.lr = learning_rate

    def predict(self, x):
        z = np.dot(x, self.weights) + self.bias
        return 1 if z >= 0 else 0  # Step function: ≥0 → "có", <0 → "không"

    def train(self, X, y, epochs=100):
        for epoch in range(epochs):
            errors = 0
            for xi, yi in zip(X, y):
                ypred = self.predict(xi)
                error = yi - ypred
                # Perceptron update rule: sai → điều chỉnh trọng số
                self.weights += self.lr * error * xi
                self.bias    += self.lr * error
                errors += abs(error)
            if errors == 0:
                print(f"Converged at epoch {epoch}")
                break

# === Bài toán AND ===
# AND: chỉ cho 1 khi CẢ HAI input = 1
X_and = np.array([[0,0],[0,1],[1,0],[1,1]])
y_and = np.array([0, 0, 0, 1])

p = Perceptron(n_inputs=2)
p.train(X_and, y_and, epochs=50)
print("AND predictions:", [p.predict(x) for x in X_and])  # [0, 0, 0, 1] ✅
print(f"Trọng số học được: w={p.weights}, b={p.bias:.2f}")
💡練習 1.2:
- 針對 OR 問題訓練感知器 (x₁=0,x2=0→0; x₁=0,x2=1→1; x₁=1,x2=0→1; x₁=1,x2=1→1)。它收斂了多少個紀元?
- 畫出感知器所學到的決策邊界。提示:它位於
w₁x₁ + w₂x₂ + b = 0。
1.3 單一感知器的限制-異或問題
單一感知器僅對線性資料進行分類—這表示它只能繪製直線來劃分資料。
AND: có thể chia bằng 1 đường thẳng ✅     XOR: KHÔNG thể chia ❌
          x₂                                      x₂
     1  | 0   1                               1  | 1   0
        |  ╱                                      |
     0  | 0 ╱ 0                               0  | 0   1
        +--------                                 +--------
          0   1   x₁                               0   1   x₁
異或:(0,0)→0,(0,1)→1,(1,0)→1,(1,1)→0→沒有可分割線!
解決方案: 將多個感知器排列成多個層 → 多層感知器(MLP)。每層「繪製」一條分割線,多個層協同工作→可以繪製任何曲線。
💡練習 1.3: 嘗試訓練單一感知器來解決 XOR 問題。它收斂嗎?最後的錯誤是什麼?
2. 激活函數—“激活閾值”
為什麼我們需要激活函數?
正常生活的例子:如果每個類別只是乘法和加法(線性),那麼即使你堆疊1000個類,它仍然只是1類——因為連續乘法=1個更大的乘法:
y = W₃(W₂(W₁x + b₁) + b₂) + b₃ = (W₃W₂W₁)x + ... = W'x + b'
→ 3 lớp linear = 1 lớp linear to hơn! Vô nghĩa!
激活函數會產生非線性 - 就像您不僅“考慮”而且“感興趣”或“拒絕”每個決策步驟。
2.1 常用激活函數
def sigmoid(x):
    """Nén mọi input vào khoảng (0, 1) — giống "xác suất" """
    return 1 / (1 + np.exp(-np.clip(x, -500, 500)))

def sigmoid_derivative(x):
    s = sigmoid(x)
    return s * (1 - s)

def tanh(x):
    """Nén vào (-1, 1) — zero-centered, tốt hơn sigmoid"""
    return np.tanh(x)

def relu(x):
    """ReLU: giữ nguyên nếu dương, bỏ nếu âm — đơn giản mà hiệu quả"""
    return np.maximum(0, x)

def relu_derivative(x):
    return (x > 0).astype(float)

def gelu(x):
    """GELU: smooth version of ReLU — dùng trong GPT, BERT"""
    return 0.5 * x * (1 + np.tanh(np.sqrt(2/np.pi) * (x + 0.044715 * x**3)))

def leaky_relu(x, alpha=0.01):
    """Leaky ReLU: giống ReLU nhưng không "giết chết" neuron âm"""
    return np.where(x > 0, x, alpha * x)
2.2 比較-何時使用什麼?
| 啟動 | 範圍 | 優勢 | 問題 | 在哪裡使用 |
|---|---|---|---|---|
| 乙狀結腸 | (0, 1) | (0, 1) | 輸出與機率相同 | 梯度消失 |
| 丹赫 | (-1, 1) | 以零為中心 | 梯度消失 | 隱藏層(RNN) |
| ReLU | [0, 無限大) | 計算速度快,不消失 | Dying ReLU(神經元永久死亡) | 隱藏層(CNN、MLP) |
| Leaky ReLU | (-無窮大, 無窮大) | 修復垂死的神經元 | 新增超參數 α | 隱藏層 |
| 格魯 | 光滑 | 光滑、自然 | 稍貴 | 變形金剛(BERT、GPT) |
| SiLU/Swish | 光滑 | 適合深度網路 | 貴 | 駱駝,帕爾姆 |
經驗法則:
- 從事 Transformer/LLM 工作? → 使用 GELU
- 致力於 CNN/MLP 常規? → 使用 ReLU
- 輸出層分類? → 使用Sigmoid(2層)或Softmax(多層)
💡練習 2:
- 在同一張圖上畫出 4 個活化函數(Sigmoid、Tanh、ReLU、GELU)的圖。建議:使用
plt.subplot(2,2,...)。 2.用文字解釋一下:為什麼ReLU能解決「梯度消失」而Sigmoid不能?
3.多層感知器(MLP):前向傳遞
3.1 架構—“決策工廠”
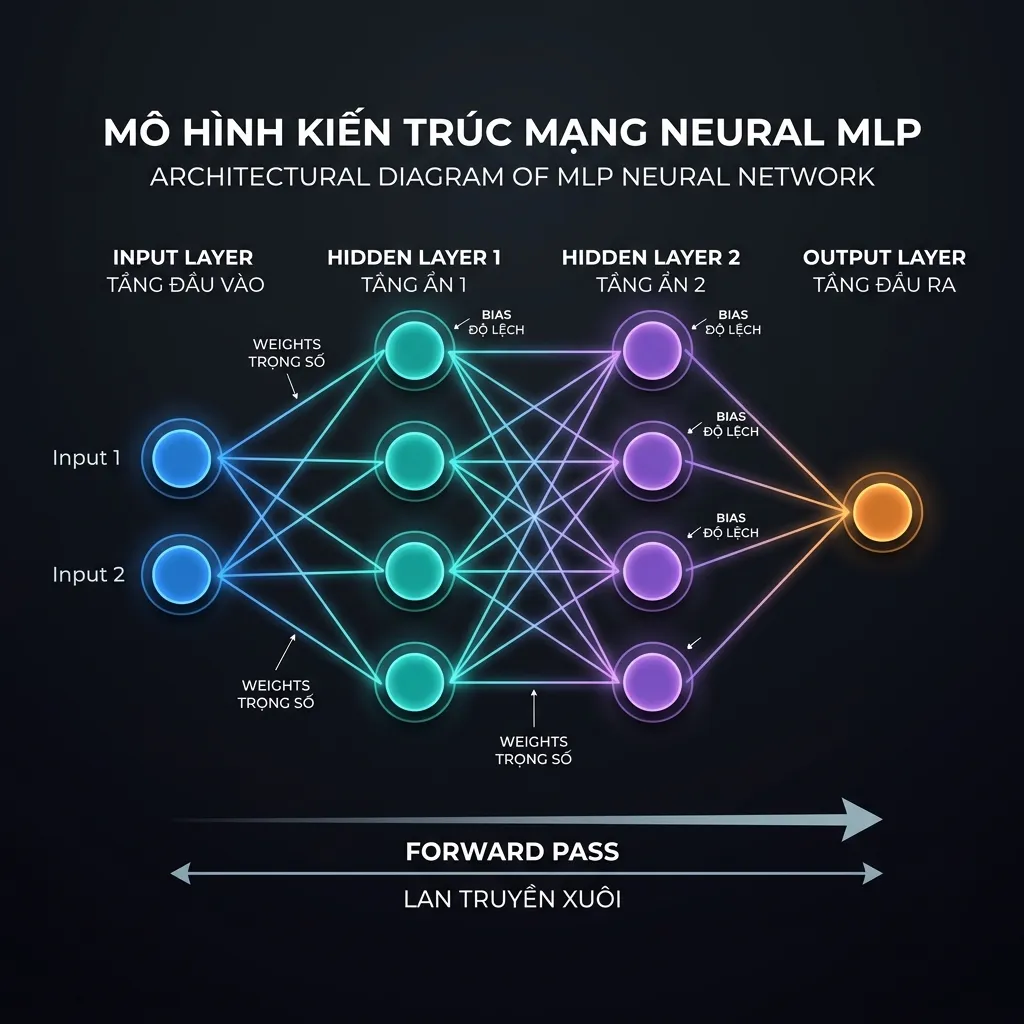
想像 MLP 是訂單處理工廠:
| 步驟 | 神經網路層 | 工廠實例 |
|---|---|---|
| 1.取得原料 | 輸入層 (x₁, x2) | 接收訂單:數量、產品類型 |
| 2. 初步治療 | 隱藏層 1 + ReLU | 檢驗部門:分選、過濾 |
| 3、加工細節 | 隱藏層 2 + ReLU | 包裝部:收費、收貨 |
| 4、輸出結果 | 輸出層+Sigmoid | 出口部:出貨還是取消? |
Input Layer → Hidden Layer 1 → Hidden Layer 2 → Output Layer
  (x₁,x₂)  →   ReLU(W₁x+b₁) →   ReLU(W₂h₁+b₂) → Sigmoid(W₃h₂+b₃)
3.2 前向傳遞—“穿過工廠”
前向傳遞是將資料從輸入通過所有層傳送到輸出的過程。每層執行:矩陣乘法→偏移加法→啟動函數。
# Ví dụ: MLP 2 → 4 → 4 → 1 cho bài toán XOR
np.random.seed(42)

# Khởi tạo tham số (ban đầu ngẫu nhiên — chưa biết đáp án)
W1 = np.random.randn(2, 4) * 0.5   # Lớp 1: 2 input → 4 neuron
b1 = np.zeros(4)
W2 = np.random.randn(4, 4) * 0.5   # Lớp 2: 4 → 4 neuron
b2 = np.zeros(4)
W3 = np.random.randn(4, 1) * 0.5   # Lớp output: 4 → 1 output
b3 = np.zeros(1)

def forward(X):
    """Chạy dữ liệu qua toàn bộ network"""
    # Layer 1: Nhận input, biến đổi
    z1 = X @ W1 + b1          # Nhân ma trận + bias → (N, 4)
    a1 = relu(z1)              # Activation → giữ phần dương → (N, 4)

    # Layer 2: Tiếp tục biến đổi
    z2 = a1 @ W2 + b2          # (N, 4)
    a2 = relu(z2)              # (N, 4)

    # Output layer: Ra kết quả cuối cùng
    z3 = a2 @ W3 + b3          # (N, 1)
    output = sigmoid(z3)       # Nén vào (0,1) → xác suất → (N, 1)

    return output, (z1, a1, z2, a2, z3)

# Dữ liệu XOR
X_xor = np.array([[0.,0.],[0.,1.],[1.,0.],[1.,1.]])
y_xor = np.array([[0.],[1.],[1.],[0.]])

output, cache = forward(X_xor)
print("Predictions (chưa train):", output.T)  # Ngẫu nhiên, chưa đúng!
💡練習 3.2: 當 W1 = [[1, -1], [-1, 1]] 且 b1 = [0, 0] 時: 1.透過第1層手動計算輸入[1, 0]的前向傳遞(ReLU前後) 2. 對輸入 [0, 0] 重複此操作。有哪些不同的結果?
4. 損失函數—“錯誤的衡量標準”
日常生活中的例子: 你射箭。損失函數測量從箭頭到中心的距離。如果損失 = 0 → 擊中中心。損失越大→偏差越大。
損失函數有兩種常見類型:
def mse_loss(y_true, y_pred):
    """Mean Squared Error — cho bài toán dự đoán số (regression)
    Ví dụ: dự đoán giá nhà, nhiệt độ, doanh thu"""
    return np.mean((y_true - y_pred) ** 2)

def binary_cross_entropy(y_true, y_pred, eps=1e-15):
    """Binary Cross-Entropy — cho bài toán phân loại 2 lớp (classification)
    Ví dụ: spam/không spam, mèo/chó, XOR"""
    y_pred = np.clip(y_pred, eps, 1 - eps)  # Tránh log(0)
    return -np.mean(y_true * np.log(y_pred) + (1 - y_true) * np.log(1 - y_pred))

# So sánh: cùng dự đoán sai, BCE phạt NẶNG hơn MSE khi model "tự tin sai"
y_true = np.array([1.0])
y_pred_confident_wrong = np.array([0.01])  # 99% tự tin sai!
y_pred_unsure = np.array([0.4])            # Không chắc lắm

print(f"MSE (tự tin sai):  {mse_loss(y_true, y_pred_confident_wrong):.4f}")  # 0.98
print(f"MSE (không chắc):  {mse_loss(y_true, y_pred_unsure):.4f}")          # 0.36
print(f"BCE (tự tin sai):  {binary_cross_entropy(y_true, y_pred_confident_wrong):.4f}")  # 4.6!
print(f"BCE (không chắc):  {binary_cross_entropy(y_true, y_pred_unsure):.4f}")          # 0.92
結論: 當模型有信心但錯誤時,BCE 會「懲罰」非常重→迫使模型謹慎→有利於分類!
💡練習 4: 如果 y_true = [1, 0, 1, 0] 且 y_pred = [0.9, 0.1, 0.8, 0.2],手動計算 MSE 和 BCE 並與上述函數的輸出進行比較。
5. 反向傳播:“教導網路如何改進”
5.1 主要思想
日常生活中的例子: 你煮的河粉很差。您想知道主要原因:
- 淡肉湯? → 下次加鹽(+效果大)
- 硬河粉? → 浸泡更久(+中等效果)
- 洋蔥還沒香嗎? → 更熟練(+小效果)
反向傳播做同樣的事情:從錯誤的結果(損失)中,它跟踪每一層,以了解每個權重有多大影響以及如何調整。
Forward:  Input → Layer 1 → Layer 2 → Output → Loss
                                                  ↓
Backward: dW₁ ← dW₂ ←── dW₃ ←──── dL/dOutput ←──┘
          (điều chỉnh mỗi W để loss giảm)
提示:使用上一課中的鍊式法則! dLoss/dW₁ = dLoss/dOutput × dOutput/dLayer2 × dLayer2/dW₁
5.2 數值範例 — 2 層 MLP
讓我們詳細了解每個步驟:
# Mạng nhỏ để dễ theo dõi bằng tay
x = np.array([[1.0, 0.0]])   # Input: shape (1, 2)
y_true = np.array([[1.0]])    # Đáp án: 1

W1 = np.array([[0.5, -0.3], [0.2, 0.8]])  # Lớp 1: (2, 2)
W2 = np.array([[0.4], [-0.1]])              # Lớp 2: (2, 1)

# === FORWARD PASS === (đi xuôi: tính output)
z1 = x @ W1                      # [1,0] @ W1 = [0.5, -0.3]
a1 = sigmoid(z1)                 # [0.622, 0.426]
z2 = a1 @ W2                     # 0.622×0.4 + 0.426×(-0.1) = 0.206
y_pred = sigmoid(z2)             # sigmoid(0.206) = 0.551

loss = binary_cross_entropy(y_true, y_pred)
print(f"y_pred: {y_pred[0,0]:.6f}, loss: {loss:.6f}")

# === BACKWARD PASS === (đi ngược: tính gradient từng trọng số)
# Mục tiêu: tính dLoss/dW1 và dLoss/dW2

# Bước 1: dLoss/dy_pred — "loss thay đổi thế nào khi output thay đổi?"
dL_dypred = -(y_true / y_pred - (1 - y_true) / (1 - y_pred)) / len(y_true)

# Bước 2: dLoss/dz2 = dLoss/dy_pred × dy_pred/dz2 (chain rule!)
dL_dz2 = dL_dypred * sigmoid_derivative(z2)

# Bước 3: dLoss/dW2 = a1ᵀ × dLoss/dz2 — "W2 ảnh hưởng loss bao nhiêu?"
dL_dW2 = a1.T @ dL_dz2          # (2,1)

# Bước 4: Truyền gradient ngược qua lớp 2
dL_da1 = dL_dz2 @ W2.T          # (1,2)

# Bước 5: dLoss/dz1 (qua sigmoid' của lớp 1)
dL_dz1 = dL_da1 * sigmoid_derivative(z1)

# Bước 6: dLoss/dW1 — "W1 ảnh hưởng loss bao nhiêu?"
dL_dW1 = x.T @ dL_dz1           # (2,2)

print(f"\ndL/dW2:\n{dL_dW2}")
print(f"dL/dW1:\n{dL_dW1}")
# → Giờ ta biết cần điều chỉnh W1, W2 theo hướng nào!
💡練習 5:
- 在上面的範例中,如果更改 y_true = 0(而不是 1),梯度的符號將如何變化?為什麼?
- 得到梯度後,更新W1和W2:
W_new = W_old - 0.1 × gradient。再跑前傳-損失會減少嗎?
6. 從頭開始建立神經網路 — 解決 XOR 問題
現在讓我們將它們組合成一個完整的類別:
class NeuralNetwork:
    def __init__(self, layer_dims, learning_rate=0.1):
        """
        layer_dims: list kích thước mỗi layer
        Ví dụ: [2, 8, 1] = input 2 → hidden 8 neurons → output 1
        """
        self.lr = learning_rate
        self.params = {}
        self.L = len(layer_dims) - 1  # Số lớp có trọng số

        for l in range(1, self.L + 1):
            fan_in  = layer_dims[l-1]
            fan_out = layer_dims[l]
            # He initialization: đặc biệt cho ReLU — không quá lớn, không quá nhỏ
            self.params[f'W{l}'] = np.random.randn(fan_in, fan_out) * np.sqrt(2.0 / fan_in)
            self.params[f'b{l}'] = np.zeros(fan_out)

    def forward(self, X):
        """Forward pass: input → qua tất cả lớp → output"""
        self.cache = {'A0': X}
        A = X
        for l in range(1, self.L + 1):
            W = self.params[f'W{l}']
            b = self.params[f'b{l}']
            Z = A @ W + b
            # Lớp cuối dùng sigmoid (output xác suất), còn lại dùng ReLU
            A = sigmoid(Z) if l == self.L else relu(Z)
            self.cache[f'Z{l}'] = Z
            self.cache[f'A{l}'] = A
        return A

    def backward(self, y_true):
        """Backward pass: tính gradient cho tất cả trọng số"""
        m = y_true.shape[0]
        y_pred = self.cache[f'A{self.L}']
        grads = {}

        # Gradient tại output layer
        dA = -(y_true / (y_pred + 1e-15) - (1 - y_true) / (1 - y_pred + 1e-15)) / m

        for l in range(self.L, 0, -1):  # Đi ngược từ lớp cuối
            Z  = self.cache[f'Z{l}']
            A_prev = self.cache[f'A{l-1}']
            W  = self.params[f'W{l}']

            if l == self.L:
                dZ = dA * sigmoid_derivative(Z)
            else:
                dZ = dA * relu_derivative(Z)

            grads[f'dW{l}'] = A_prev.T @ dZ      # Gradient cho W
            grads[f'db{l}'] = np.sum(dZ, axis=0)  # Gradient cho b
            dA = dZ @ W.T                          # Truyền gradient cho lớp trước

        return grads

    def update(self, grads):
        """Cập nhật tham số: W_new = W_old - lr × gradient"""
        for l in range(1, self.L + 1):
            self.params[f'W{l}'] -= self.lr * grads[f'dW{l}']
            self.params[f'b{l}'] -= self.lr * grads[f'db{l}']

    def train(self, X, y, epochs=5000, verbose=True):
        """Vòng lặp huấn luyện: forward → loss → backward → update"""
        losses = []
        for epoch in range(epochs):
            # 1. Forward
            y_pred = self.forward(X)
            # 2. Tính loss
            loss = binary_cross_entropy(y, y_pred)
            # 3. Backward
            grads = self.backward(y)
            # 4. Update
            self.update(grads)

            losses.append(loss)
            if verbose and epoch % 1000 == 0:
                acc = np.mean((y_pred > 0.5) == y) * 100
                print(f"Epoch {epoch:5d} | Loss: {loss:.6f} | Acc: {acc:.1f}%")
        return losses

# === Huấn luyện giải XOR ===
X_xor = np.array([[0.,0.],[0.,1.],[1.,0.],[1.,1.]])
y_xor = np.array([[0.],[1.],[1.],[0.]])

nn = NeuralNetwork(layer_dims=[2, 8, 8, 1], learning_rate=0.5)
losses = nn.train(X_xor, y_xor, epochs=5000)

# Kiểm tra kết quả
predictions = nn.forward(X_xor)
print("\n🎯 Final predictions:")
for xi, yi, pi in zip(X_xor, y_xor, predictions):
    status = "✅" if (pi[0] > 0.5) == yi[0] else "❌"
    print(f"  Input: {xi} | True: {int(yi[0])} | Pred: {pi[0]:.4f} → {int(pi[0]>0.5)} {status}")
💡練習 6: 1.嘗試改變
layer_dims進入[2, 4, 1](更少的神經元)。網路還能解決XOR問題嗎?需要多少個紀元? 2. 嘗試[2, 2, 1]——神經元太少→無法解決!為什麼? 3. 繪製圖表losses根據紀元。什麼階段損失迅速減少?
7. 比較 NumPy 與 PyTorch
上面的程式碼是用NumPy寫的,可以理解本質。但實際上,PyTorch 只需幾行即可完成所有操作:
import torch
import torch.nn as nn

# === PyTorch version — ngắn gọn hơn nhiều! ===
X_t = torch.FloatTensor([[0,0],[0,1],[1,0],[1,1]])
y_t = torch.FloatTensor([[0],[1],[1],[0]])

model = nn.Sequential(
    nn.Linear(2, 8),    # Lớp 1: 2 → 8
    nn.ReLU(),           # Activation
    nn.Linear(8, 8),     # Lớp 2: 8 → 8
    nn.ReLU(),
    nn.Linear(8, 1),     # Output: 8 → 1
    nn.Sigmoid()
)

optimizer = torch.optim.Adam(model.parameters(), lr=0.01)  # Adam! (từ bài 2)
criterion = nn.BCELoss()

for epoch in range(3000):
    optimizer.zero_grad()          # Xóa gradient cũ
    y_pred = model(X_t)            # Forward pass
    loss = criterion(y_pred, y_t)  # Tính loss
    loss.backward()                # Backward pass — TỰ ĐỘNG!
    optimizer.step()               # Update — TỰ ĐỘNG!

    if epoch % 1000 == 0:
        acc = ((y_pred > 0.5) == y_t).float().mean() * 100
        print(f"Epoch {epoch:5d} | Loss: {loss.item():.6f} | Acc: {acc.item():.1f}%")

# Kiểm tra
with torch.no_grad():
    preds = model(X_t)
    print("\nPyTorch predictions:", (preds > 0.5).int().squeeze().tolist())
最大的區別:使用 PyTorch,您只需編寫 前向傳遞。後向傳遞(梯度計算)+參數更新都是自動!
為什麼要使用 PyTorch 而不是 NumPy?
| 特點 | NumPy | PyTorch |
|---|---|---|
| Autograd(自動梯度計算) | ❌ 必須手寫 | ✅ loss.backward() |
| GPU 支援 | ❌ | ✅ model.cuda() — 10–100× 快 |
| 人工智慧生態系 | 一般 | ✅ 變形金剛、HuggingFace... |
| 易於調試 | 平均 | ✅ 好(渴望模式) |
結論: NumPy 幫助您理解本質 → 必要的。 PyTorch 可以幫助您提高工作效率 → 強制性的。 **兩者都學習。 **
💡練習 7: 使用 PyTorch,建立 MLP 對資料集進行分類
make_moons來自sklearn(半圓形數據,2類)。實現準確率 > 95%。建議:from sklearn.datasets import make_moons。
課程總結
| 概念 | 簡單理解 | 聯絡下一個 |
|---|---|---|
| 感知器 | 1 位工人做決定 | GPT 中的神經元 |
| 激活 | “觸發閾值”造成非線性 | 變壓器中的 GELU |
| MLP | 多層廠房 | Transformer 中的前饋 |
| 前向傳球 | 通過工廠運行數據 | 推理=前向傳遞 |
| 損失函數 | 測量輸出的「錯誤等級」 | LLM 的交叉熵 |
| 反向傳播 | 回溯發現錯誤,建議修正 | 訓練=前進+後退 |
| PyTorch | 自動向後 + GPU | #1 法學碩士工具 |
一般練習
- ✅ 完成每個部分的所有小練習(1.2, 1.3, 2, 3.2, 4, 5, 6, 7)
- 編輯班級
NeuralNetwork支援 Leaky ReLU 而不是 ReLU——哪裡需要改變? - 將 L2 正則化(權重衰減)加到損失中:
L = L_bce + λ × Σ||W||²。為什麼需要正規化? - 為優化器實作 Momentum:
v = β×v - α×grad; θ = θ + v。將收斂速度與普通梯度下降進行比較。 - (進階) 使用 PyTorch,建立 MNIST 分類 MLP(28×28 影像,10 位數類別)— 實現 >95% 的準確率
下一篇文章: 深度學習概論 — CNN、RNN、LSTM。為什麼需要額外的特殊架構,是什麼導致了 Transformer?