Giới thiệu
Mạng nơ-ron nhân tạo (Neural Network) là nền tảng của toàn bộ AI hiện đại — từ mô hình nhận dạng ảnh cho đến ChatGPT. Bạn có thể nghĩ về neural network như một nhà máy quyết định: dữ liệu đi vào → qua nhiều bước xử lý → ra kết quả.
Bài học này xây dựng hiểu biết từ dưới lên: bắt đầu từ một "công nhân" đơn lẻ (neuron), sau đó ghép thành "đội ngũ" (network), và cuối cùng dạy đội ngũ cách "cải thiện" (backpropagation).
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(42)
1. Perceptron: Từ Sinh học đến Toán học
1.1 Nơ-ron sinh học — Cảm hứng cho AI
Não người có ~86 tỷ nơ-ron. Mỗi nơ-ron hoạt động như một bộ ra quyết định đơn giản:
- Nhận thông tin qua dendrites (nhiều đầu vào — giống như nghe ý kiến từ nhiều nguồn)
- Xử lý trong cell body/soma (cân nhắc tất cả ý kiến)
- Phát tín hiệu qua axon nếu đủ kích thích (đưa ra quyết định: "có" hoặc "không")
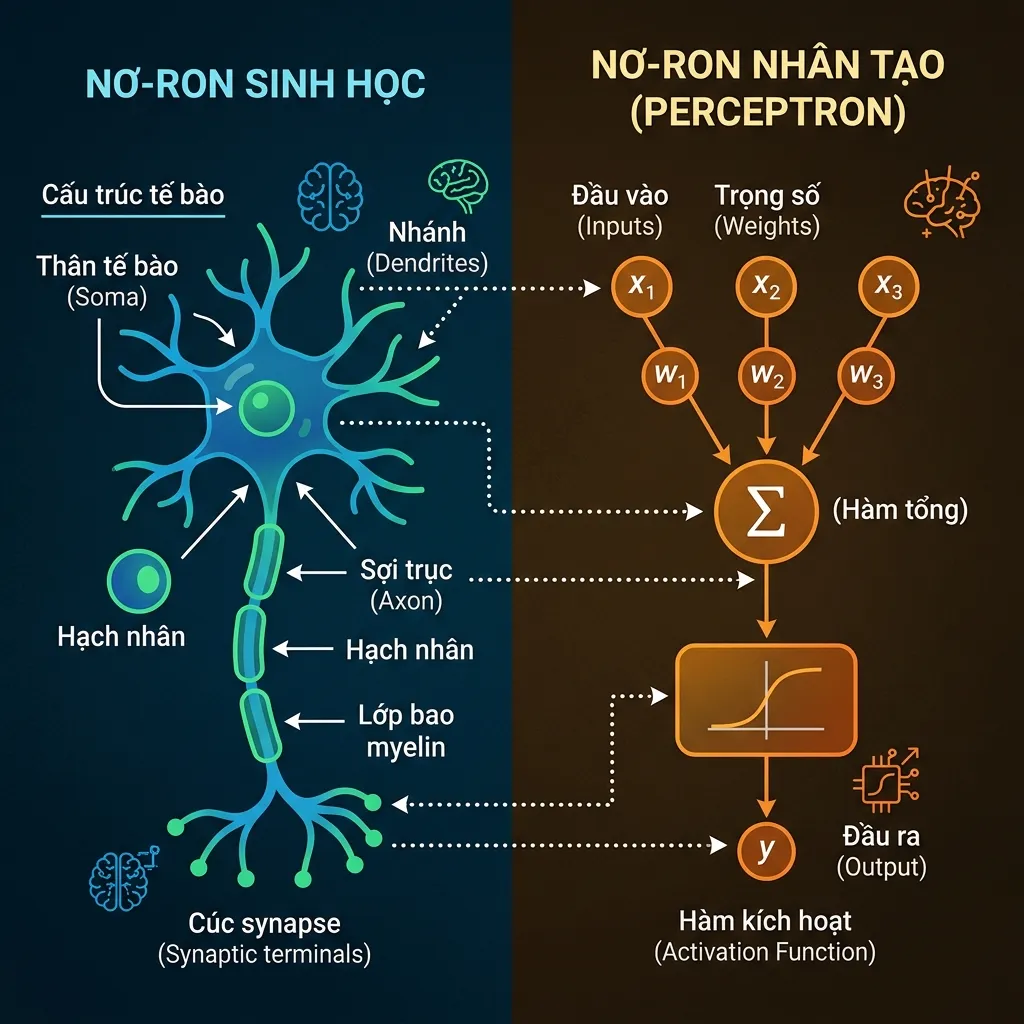
Ví dụ đời thường: Hãy tưởng tượng bạn quyết định có đi ăn tối với bạn bè không:
| Yếu tố (đầu vào) | Mức quan trọng (trọng số) | Tình huống hôm nay |
|---|---|---|
| Có tiền không? | w₁ = 0.4 (quan trọng) | x₁ = 1 (có) |
| Trời đẹp không? | w₂ = 0.1 (ít quan trọng) | x₂ = 0 (mưa) |
| Bạn thân đi không? | w₃ = 0.5 (rất quan trọng) | x₃ = 1 (có) |
Tổng điểm: 0.4×1 + 0.1×0 + 0.5×1 = 0.9 → Vượt ngưỡng 0.5 → ĐI! 🎉
1.2 Perceptron — Nơ-ron nhân tạo (1958)
Frank Rosenblatt mô hình hóa nơ-ron thành công thức toán học:
z = w₁x₁ + w₂x₂ + ... + wₙxₙ + b = W·x + b
ŷ = f(z)    # f là activation function — quyết định "bắn" hay "không"
Nhìn quen không? Đây chính là dot product từ bài trước + một hàm kích hoạt!
class Perceptron:
    def __init__(self, n_inputs, learning_rate=0.1):
        # Khởi tạo trọng số ngẫu nhiên nhỏ
        self.weights = np.random.randn(n_inputs) * 0.01
        self.bias = 0.0
        self.lr = learning_rate

    def predict(self, x):
        z = np.dot(x, self.weights) + self.bias
        return 1 if z >= 0 else 0  # Step function: ≥0 → "có", <0 → "không"

    def train(self, X, y, epochs=100):
        for epoch in range(epochs):
            errors = 0
            for xi, yi in zip(X, y):
                ypred = self.predict(xi)
                error = yi - ypred
                # Perceptron update rule: sai → điều chỉnh trọng số
                self.weights += self.lr * error * xi
                self.bias    += self.lr * error
                errors += abs(error)
            if errors == 0:
                print(f"Converged at epoch {epoch}")
                break

# === Bài toán AND ===
# AND: chỉ cho 1 khi CẢ HAI input = 1
X_and = np.array([[0,0],[0,1],[1,0],[1,1]])
y_and = np.array([0, 0, 0, 1])

p = Perceptron(n_inputs=2)
p.train(X_and, y_and, epochs=50)
print("AND predictions:", [p.predict(x) for x in X_and])  # [0, 0, 0, 1] ✅
print(f"Trọng số học được: w={p.weights}, b={p.bias:.2f}")
💡 Bài tập 1.2:
- Huấn luyện Perceptron cho bài toán OR (x₁=0,x₂=0→0; x₁=0,x₂=1→1; x₁=1,x₂=0→1; x₁=1,x₂=1→1). Nó hội tụ sau bao nhiêu epoch?
- Vẽ đường thẳng phân cách (decision boundary) mà perceptron đã học được. Gợi ý: nó nằm ở
w₁x₁ + w₂x₂ + b = 0.
1.3 Giới hạn của Perceptron đơn — Bài toán XOR
Perceptron đơn chỉ phân loại được dữ liệu tuyến tính — nghĩa là nó chỉ có thể vẽ một đường thẳng để chia dữ liệu.
AND: có thể chia bằng 1 đường thẳng ✅     XOR: KHÔNG thể chia ❌
          x₂                                      x₂
     1  | 0   1                               1  | 1   0
        |  ╱                                      |
     0  | 0 ╱ 0                               0  | 0   1
        +--------                                 +--------
          0   1   x₁                               0   1   x₁
XOR: (0,0)→0, (0,1)→1, (1,0)→1, (1,1)→0 → Không có đường thẳng nào chia được!
Giải pháp: Xếp nhiều perceptron thành nhiều lớp → Multilayer Perceptron (MLP). Mỗi lớp "vẽ" một đường phân cách, nhiều lớp cùng phối hợp → có thể vẽ bất kỳ đường cong nào.
💡 Bài tập 1.3: Thử huấn luyện Perceptron đơn cho bài toán XOR. Nó có hội tụ không? Error cuối cùng là bao nhiêu?
2. Activation Functions — "Ngưỡng kích hoạt"
Tại sao cần activation function?
Ví dụ đời thường: Nếu mỗi lớp chỉ là phép nhân và cộng (linear), thì dù xếp 1000 lớp vẫn chỉ bằng 1 lớp — vì phép nhân liên tiếp = 1 phép nhân lớn hơn:
y = W₃(W₂(W₁x + b₁) + b₂) + b₃ = (W₃W₂W₁)x + ... = W'x + b'
→ 3 lớp linear = 1 lớp linear to hơn! Vô nghĩa!
Activation function tạo ra phi tuyến tính — giống như việc bạn không chỉ "cân nhắc" mà còn "hứng thú" hoặc "từ chối" ở mỗi bước quyết định.
2.1 Các activation functions phổ biến
def sigmoid(x):
    """Nén mọi input vào khoảng (0, 1) — giống "xác suất" """
    return 1 / (1 + np.exp(-np.clip(x, -500, 500)))

def sigmoid_derivative(x):
    s = sigmoid(x)
    return s * (1 - s)

def tanh(x):
    """Nén vào (-1, 1) — zero-centered, tốt hơn sigmoid"""
    return np.tanh(x)

def relu(x):
    """ReLU: giữ nguyên nếu dương, bỏ nếu âm — đơn giản mà hiệu quả"""
    return np.maximum(0, x)

def relu_derivative(x):
    return (x > 0).astype(float)

def gelu(x):
    """GELU: smooth version of ReLU — dùng trong GPT, BERT"""
    return 0.5 * x * (1 + np.tanh(np.sqrt(2/np.pi) * (x + 0.044715 * x**3)))

def leaky_relu(x, alpha=0.01):
    """Leaky ReLU: giống ReLU nhưng không "giết chết" neuron âm"""
    return np.where(x > 0, x, alpha * x)
2.2 So sánh — Khi nào dùng gì?
| Activation | Range | Ưu điểm | Vấn đề | Dùng ở đâu |
|---|---|---|---|---|
| Sigmoid | (0, 1) | Output giống xác suất | Vanishing gradient | Output layer (binary) |
| Tanh | (-1, 1) | Zero-centered | Vanishing gradient | Hidden layers (RNN) |
| ReLU | [0, ∞) | Tính nhanh, không vanishing | Dying ReLU (neuron chết vĩnh viễn) | Hidden layers (CNN, MLP) |
| Leaky ReLU | (-∞, ∞) | Fix dying neuron | Thêm hyperparameter α | Hidden layers |
| GELU | Smooth | Mượt, tự nhiên | Tính hơi đắt | Transformers (BERT, GPT) |
| SiLU/Swish | Smooth | Tốt cho deep networks | Tính đắt | LLaMA, PaLM |
Quy tắc ngón cái:
- Đang làm Transformer/LLM? → dùng GELU
- Đang làm CNN/MLP thường? → dùng ReLU
- Output layer phân loại? → dùng Sigmoid (2 lớp) hoặc Softmax (nhiều lớp)
💡 Bài tập 2:
- Vẽ đồ thị 4 activation functions (Sigmoid, Tanh, ReLU, GELU) trên cùng 1 figure. Gợi ý: dùng
plt.subplot(2,2,...).- Giải thích bằng lời: tại sao ReLU giải quyết được "vanishing gradient" mà Sigmoid không thể?
3. Multilayer Perceptron (MLP): Forward Pass
3.1 Kiến trúc — "Nhà máy quyết định"
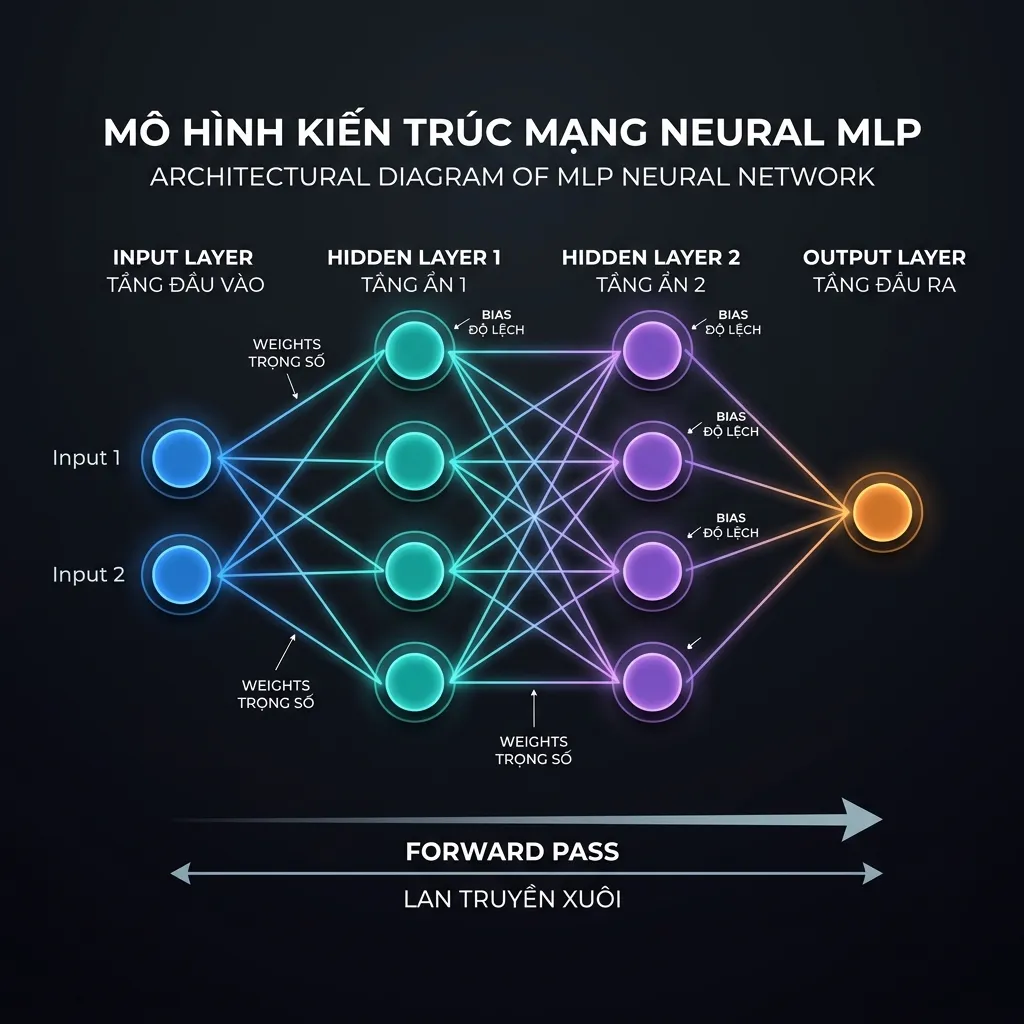
Hãy tưởng tượng MLP là một nhà máy xử lý đơn hàng:
| Bước | Tầng Neural Network | Ví dụ nhà máy |
|---|---|---|
| 1. Nhận nguyên liệu | Input Layer (x₁, x₂) | Nhận đơn hàng: số lượng, loại sản phẩm |
| 2. Xử lý sơ bộ | Hidden Layer 1 + ReLU | Bộ phận kiểm tra: phân loại, lọc |
| 3. Xử lý chi tiết | Hidden Layer 2 + ReLU | Bộ phận đóng gói: tính phí, gom hàng |
| 4. Ra kết quả | Output Layer + Sigmoid | Bộ phận xuất hàng: giao hay huỷ? |
Input Layer → Hidden Layer 1 → Hidden Layer 2 → Output Layer
  (x₁,x₂)  →   ReLU(W₁x+b₁) →   ReLU(W₂h₁+b₂) → Sigmoid(W₃h₂+b₃)
3.2 Forward Pass — "Chạy qua nhà máy"
Forward pass là quá trình đưa dữ liệu từ input qua tất cả các lớp đến output. Mỗi lớp thực hiện: nhân ma trận → cộng bias → activation function.
# Ví dụ: MLP 2 → 4 → 4 → 1 cho bài toán XOR
np.random.seed(42)

# Khởi tạo tham số (ban đầu ngẫu nhiên — chưa biết đáp án)
W1 = np.random.randn(2, 4) * 0.5   # Lớp 1: 2 input → 4 neuron
b1 = np.zeros(4)
W2 = np.random.randn(4, 4) * 0.5   # Lớp 2: 4 → 4 neuron
b2 = np.zeros(4)
W3 = np.random.randn(4, 1) * 0.5   # Lớp output: 4 → 1 output
b3 = np.zeros(1)

def forward(X):
    """Chạy dữ liệu qua toàn bộ network"""
    # Layer 1: Nhận input, biến đổi
    z1 = X @ W1 + b1          # Nhân ma trận + bias → (N, 4)
    a1 = relu(z1)              # Activation → giữ phần dương → (N, 4)

    # Layer 2: Tiếp tục biến đổi
    z2 = a1 @ W2 + b2          # (N, 4)
    a2 = relu(z2)              # (N, 4)

    # Output layer: Ra kết quả cuối cùng
    z3 = a2 @ W3 + b3          # (N, 1)
    output = sigmoid(z3)       # Nén vào (0,1) → xác suất → (N, 1)

    return output, (z1, a1, z2, a2, z3)

# Dữ liệu XOR
X_xor = np.array([[0.,0.],[0.,1.],[1.,0.],[1.,1.]])
y_xor = np.array([[0.],[1.],[1.],[0.]])

output, cache = forward(X_xor)
print("Predictions (chưa train):", output.T)  # Ngẫu nhiên, chưa đúng!
💡 Bài tập 3.2: Với W1 = [[1, -1], [-1, 1]] và b1 = [0, 0]:
- Tính bằng tay forward pass cho input [1, 0] qua lớp 1 (trước và sau ReLU)
- Lặp lại cho input [0, 0]. Kết quả khác gì?
4. Loss Functions — "Thước đo sai lầm"
Ví dụ đời thường: Bạn bắn cung. Loss function đo khoảng cách từ mũi tên đến tâm. Nếu loss = 0 → trúng tâm. Loss càng lớn → càng lệch.
Có 2 loại loss function phổ biến:
def mse_loss(y_true, y_pred):
    """Mean Squared Error — cho bài toán dự đoán số (regression)
    Ví dụ: dự đoán giá nhà, nhiệt độ, doanh thu"""
    return np.mean((y_true - y_pred) ** 2)

def binary_cross_entropy(y_true, y_pred, eps=1e-15):
    """Binary Cross-Entropy — cho bài toán phân loại 2 lớp (classification)
    Ví dụ: spam/không spam, mèo/chó, XOR"""
    y_pred = np.clip(y_pred, eps, 1 - eps)  # Tránh log(0)
    return -np.mean(y_true * np.log(y_pred) + (1 - y_true) * np.log(1 - y_pred))

# So sánh: cùng dự đoán sai, BCE phạt NẶNG hơn MSE khi model "tự tin sai"
y_true = np.array([1.0])
y_pred_confident_wrong = np.array([0.01])  # 99% tự tin sai!
y_pred_unsure = np.array([0.4])            # Không chắc lắm

print(f"MSE (tự tin sai):  {mse_loss(y_true, y_pred_confident_wrong):.4f}")  # 0.98
print(f"MSE (không chắc):  {mse_loss(y_true, y_pred_unsure):.4f}")          # 0.36
print(f"BCE (tự tin sai):  {binary_cross_entropy(y_true, y_pred_confident_wrong):.4f}")  # 4.6!
print(f"BCE (không chắc):  {binary_cross_entropy(y_true, y_pred_unsure):.4f}")          # 0.92
Kết luận: BCE "phạt" rất nặng khi model tự tin mà sai → buộc model phải thận trọng → tốt cho classification!
💡 Bài tập 4: Nếu y_true = [1, 0, 1, 0] và y_pred = [0.9, 0.1, 0.8, 0.2], tính MSE và BCE bằng tay rồi so sánh với output từ hàm trên.
5. Backpropagation: "Dạy network cách cải thiện"
5.1 Ý tưởng chính
Ví dụ đời thường: Bạn nấu phở bị dở. Bạn muốn biết nguyên nhân chính:
- Nước dùng nhạt? → Thêm muối lần sau (+ảnh hưởng lớn)
- Bánh phở cứng? → Ngâm lâu hơn (+ảnh hưởng trung bình)
- Hành chưa thơm? → Phi kỹ hơn (+ảnh hưởng nhỏ)
Backpropagation làm tương tự: từ kết quả sai (loss), nó truy ngược qua từng lớp để biết mỗi trọng số ảnh hưởng bao nhiêu và cần điều chỉnh thế nào.
Forward:  Input → Layer 1 → Layer 2 → Output → Loss
                                                  ↓
Backward: dW₁ ← dW₂ ←── dW₃ ←──── dL/dOutput ←──┘
          (điều chỉnh mỗi W để loss giảm)
Bí quyết: dùng chain rule từ bài trước! dLoss/dW₁ = dLoss/dOutput × dOutput/dLayer2 × dLayer2/dW₁
5.2 Ví dụ số — MLP 2 lớp
Hãy đi qua từng bước chi tiết:
# Mạng nhỏ để dễ theo dõi bằng tay
x = np.array([[1.0, 0.0]])   # Input: shape (1, 2)
y_true = np.array([[1.0]])    # Đáp án: 1

W1 = np.array([[0.5, -0.3], [0.2, 0.8]])  # Lớp 1: (2, 2)
W2 = np.array([[0.4], [-0.1]])              # Lớp 2: (2, 1)

# === FORWARD PASS === (đi xuôi: tính output)
z1 = x @ W1                      # [1,0] @ W1 = [0.5, -0.3]
a1 = sigmoid(z1)                 # [0.622, 0.426]
z2 = a1 @ W2                     # 0.622×0.4 + 0.426×(-0.1) = 0.206
y_pred = sigmoid(z2)             # sigmoid(0.206) = 0.551

loss = binary_cross_entropy(y_true, y_pred)
print(f"y_pred: {y_pred[0,0]:.6f}, loss: {loss:.6f}")

# === BACKWARD PASS === (đi ngược: tính gradient từng trọng số)
# Mục tiêu: tính dLoss/dW1 và dLoss/dW2

# Bước 1: dLoss/dy_pred — "loss thay đổi thế nào khi output thay đổi?"
dL_dypred = -(y_true / y_pred - (1 - y_true) / (1 - y_pred)) / len(y_true)

# Bước 2: dLoss/dz2 = dLoss/dy_pred × dy_pred/dz2 (chain rule!)
dL_dz2 = dL_dypred * sigmoid_derivative(z2)

# Bước 3: dLoss/dW2 = a1ᵀ × dLoss/dz2 — "W2 ảnh hưởng loss bao nhiêu?"
dL_dW2 = a1.T @ dL_dz2          # (2,1)

# Bước 4: Truyền gradient ngược qua lớp 2
dL_da1 = dL_dz2 @ W2.T          # (1,2)

# Bước 5: dLoss/dz1 (qua sigmoid' của lớp 1)
dL_dz1 = dL_da1 * sigmoid_derivative(z1)

# Bước 6: dLoss/dW1 — "W1 ảnh hưởng loss bao nhiêu?"
dL_dW1 = x.T @ dL_dz1           # (2,2)

print(f"\ndL/dW2:\n{dL_dW2}")
print(f"dL/dW1:\n{dL_dW1}")
# → Giờ ta biết cần điều chỉnh W1, W2 theo hướng nào!
💡 Bài tập 5:
- Trong ví dụ trên, nếu đổi y_true = 0 (thay vì 1), dấu của gradient sẽ thay đổi thế nào? Tại sao?
- Sau khi có gradient, cập nhật W1 và W2:
W_new = W_old - 0.1 × gradient. Chạy forward pass lại — loss có giảm không?
6. Build Neural Network từ đầu — Giải bài toán XOR
Giờ hãy ghép tất cả lại thành một class hoàn chỉnh:
class NeuralNetwork:
    def __init__(self, layer_dims, learning_rate=0.1):
        """
        layer_dims: list kích thước mỗi layer
        Ví dụ: [2, 8, 1] = input 2 → hidden 8 neurons → output 1
        """
        self.lr = learning_rate
        self.params = {}
        self.L = len(layer_dims) - 1  # Số lớp có trọng số

        for l in range(1, self.L + 1):
            fan_in  = layer_dims[l-1]
            fan_out = layer_dims[l]
            # He initialization: đặc biệt cho ReLU — không quá lớn, không quá nhỏ
            self.params[f'W{l}'] = np.random.randn(fan_in, fan_out) * np.sqrt(2.0 / fan_in)
            self.params[f'b{l}'] = np.zeros(fan_out)

    def forward(self, X):
        """Forward pass: input → qua tất cả lớp → output"""
        self.cache = {'A0': X}
        A = X
        for l in range(1, self.L + 1):
            W = self.params[f'W{l}']
            b = self.params[f'b{l}']
            Z = A @ W + b
            # Lớp cuối dùng sigmoid (output xác suất), còn lại dùng ReLU
            A = sigmoid(Z) if l == self.L else relu(Z)
            self.cache[f'Z{l}'] = Z
            self.cache[f'A{l}'] = A
        return A

    def backward(self, y_true):
        """Backward pass: tính gradient cho tất cả trọng số"""
        m = y_true.shape[0]
        y_pred = self.cache[f'A{self.L}']
        grads = {}

        # Gradient tại output layer
        dA = -(y_true / (y_pred + 1e-15) - (1 - y_true) / (1 - y_pred + 1e-15)) / m

        for l in range(self.L, 0, -1):  # Đi ngược từ lớp cuối
            Z  = self.cache[f'Z{l}']
            A_prev = self.cache[f'A{l-1}']
            W  = self.params[f'W{l}']

            if l == self.L:
                dZ = dA * sigmoid_derivative(Z)
            else:
                dZ = dA * relu_derivative(Z)

            grads[f'dW{l}'] = A_prev.T @ dZ      # Gradient cho W
            grads[f'db{l}'] = np.sum(dZ, axis=0)  # Gradient cho b
            dA = dZ @ W.T                          # Truyền gradient cho lớp trước

        return grads

    def update(self, grads):
        """Cập nhật tham số: W_new = W_old - lr × gradient"""
        for l in range(1, self.L + 1):
            self.params[f'W{l}'] -= self.lr * grads[f'dW{l}']
            self.params[f'b{l}'] -= self.lr * grads[f'db{l}']

    def train(self, X, y, epochs=5000, verbose=True):
        """Vòng lặp huấn luyện: forward → loss → backward → update"""
        losses = []
        for epoch in range(epochs):
            # 1. Forward
            y_pred = self.forward(X)
            # 2. Tính loss
            loss = binary_cross_entropy(y, y_pred)
            # 3. Backward
            grads = self.backward(y)
            # 4. Update
            self.update(grads)

            losses.append(loss)
            if verbose and epoch % 1000 == 0:
                acc = np.mean((y_pred > 0.5) == y) * 100
                print(f"Epoch {epoch:5d} | Loss: {loss:.6f} | Acc: {acc:.1f}%")
        return losses

# === Huấn luyện giải XOR ===
X_xor = np.array([[0.,0.],[0.,1.],[1.,0.],[1.,1.]])
y_xor = np.array([[0.],[1.],[1.],[0.]])

nn = NeuralNetwork(layer_dims=[2, 8, 8, 1], learning_rate=0.5)
losses = nn.train(X_xor, y_xor, epochs=5000)

# Kiểm tra kết quả
predictions = nn.forward(X_xor)
print("\n🎯 Final predictions:")
for xi, yi, pi in zip(X_xor, y_xor, predictions):
    status = "✅" if (pi[0] > 0.5) == yi[0] else "❌"
    print(f"  Input: {xi} | True: {int(yi[0])} | Pred: {pi[0]:.4f} → {int(pi[0]>0.5)} {status}")
💡 Bài tập 6:
- Thử thay đổi
layer_dimsthành[2, 4, 1](ít neuron hơn). Network còn giải được XOR không? Cần bao nhiêu epoch?- Thử
[2, 2, 1]— quá ít neuron → không giải được! Tại sao?- Vẽ đồ thị
lossestheo epoch. Loss giảm nhanh ở giai đoạn nào?
7. So sánh NumPy vs PyTorch
Code trên viết bằng NumPy để hiểu bản chất. Nhưng trong thực tế, PyTorch giúp làm tất cả chỉ trong vài dòng:
import torch
import torch.nn as nn

# === PyTorch version — ngắn gọn hơn nhiều! ===
X_t = torch.FloatTensor([[0,0],[0,1],[1,0],[1,1]])
y_t = torch.FloatTensor([[0],[1],[1],[0]])

model = nn.Sequential(
    nn.Linear(2, 8),    # Lớp 1: 2 → 8
    nn.ReLU(),           # Activation
    nn.Linear(8, 8),     # Lớp 2: 8 → 8
    nn.ReLU(),
    nn.Linear(8, 1),     # Output: 8 → 1
    nn.Sigmoid()
)

optimizer = torch.optim.Adam(model.parameters(), lr=0.01)  # Adam! (từ bài 2)
criterion = nn.BCELoss()

for epoch in range(3000):
    optimizer.zero_grad()          # Xóa gradient cũ
    y_pred = model(X_t)            # Forward pass
    loss = criterion(y_pred, y_t)  # Tính loss
    loss.backward()                # Backward pass — TỰ ĐỘNG!
    optimizer.step()               # Update — TỰ ĐỘNG!

    if epoch % 1000 == 0:
        acc = ((y_pred > 0.5) == y_t).float().mean() * 100
        print(f"Epoch {epoch:5d} | Loss: {loss.item():.6f} | Acc: {acc.item():.1f}%")

# Kiểm tra
with torch.no_grad():
    preds = model(X_t)
    print("\nPyTorch predictions:", (preds > 0.5).int().squeeze().tolist())
Sự khác biệt lớn nhất: Với PyTorch, bạn chỉ cần viết forward pass. Backward pass (tính gradient) + update tham số đều tự động!
Tại sao dùng PyTorch thay vì NumPy?
| Tính năng | NumPy | PyTorch |
|---|---|---|
| Autograd (tự tính gradient) | ❌ Phải viết tay | ✅ loss.backward() |
| GPU support | ❌ | ✅ model.cuda() — 10–100× nhanh |
| Hệ sinh thái AI | Tổng quát | ✅ Transformers, HuggingFace... |
| Dễ debug | Trung bình | ✅ Tốt (eager mode) |
Kết luận: NumPy giúp bạn hiểu bản chất → cần thiết. PyTorch giúp bạn làm việc hiệu quả → bắt buộc. Học cả hai.
💡 Bài tập 7: Dùng PyTorch, xây dựng MLP phân loại bộ dữ liệu
make_moonstừ sklearn (dữ liệu hình bán nguyệt, 2 lớp). Đạt accuracy > 95%. Gợi ý:from sklearn.datasets import make_moons.
Tóm tắt bài học
| Khái niệm | Hiểu đơn giản | Liên hệ tiếp |
|---|---|---|
| Perceptron | 1 công nhân ra quyết định | Neuron trong GPT |
| Activation | "Ngưỡng kích hoạt" tạo phi tuyến | GELU trong Transformer |
| MLP | Nhà máy nhiều tầng | Feed-forward trong Transformer |
| Forward pass | Chạy dữ liệu qua nhà máy | Inference = forward pass |
| Loss function | Đo "mức sai" của output | Cross-entropy cho LLM |
| Backpropagation | Truy ngược tìm lỗi, gợi ý sửa | Training = forward + backward |
| PyTorch | Automate backward + GPU | Công cụ #1 cho LLM |
Bài tập tổng hợp
- ✅ Hoàn thành tất cả bài tập nhỏ trong từng phần (1.2, 1.3, 2, 3.2, 4, 5, 6, 7)
- Sửa class
NeuralNetworkđể hỗ trợ Leaky ReLU thay vì ReLU — cần thay đổi ở đâu? - Thêm L2 regularization (weight decay) vào loss:
L = L_bce + λ × Σ||W||². Tại sao cần regularization? - Implement Momentum cho optimizer:
v = β×v - α×grad; θ = θ + v. So sánh tốc độ hội tụ với vanilla gradient descent. - (Nâng cao) Dùng PyTorch, xây dựng MLP phân loại MNIST (28×28 ảnh, 10 lớp chữ số) — đạt >95% accuracy
Bài tiếp theo: Deep Learning Overview — CNN, RNN, LSTM. Tại sao cần thêm kiến trúc đặc biệt, và điều gì dẫn đến Transformer?